
Qual é a precisão da digitação por voz? Taxa de erro, velocidade e limites reais
Como se mede a precisão do reconhecimento de fala (taxa de erro de palavras), o que os estudos dizem sobre a velocidade do ditado em comparação com a digitação, o que piora os resultados e quais palavras conferir sempre.
Resumindo
A precisão normalmente é medida pela taxa de erro de palavras (WER): palavras trocadas, apagadas e inseridas divididas pelo número de palavras realmente ditas. É útil, mas estreita: pontuação, formatação e sentido ficam de fora. Os estudos mostram que falar é cerca de três vezes mais rápido que digitar no celular. Os erros se concentram em nomes, números e ruído: são essas as palavras para conferir antes de enviar.
Você disse
por favor transfira mil e quinhentos e não cinco mil para a conta do fornecedor
O SayVelio escreveu
Por favor, transfira 1.500, e não 5.000, para a conta do fornecedor.
Três tipos de erro
Quando um sistema de reconhecimento erra, ele faz uma destas três coisas:
- Substituição: uma palavra é trocada por outra («sete» → «seis»).
- Apagamento: uma palavra some (o «não» desaparece).
- Inserção: aparece uma palavra que não foi dita.
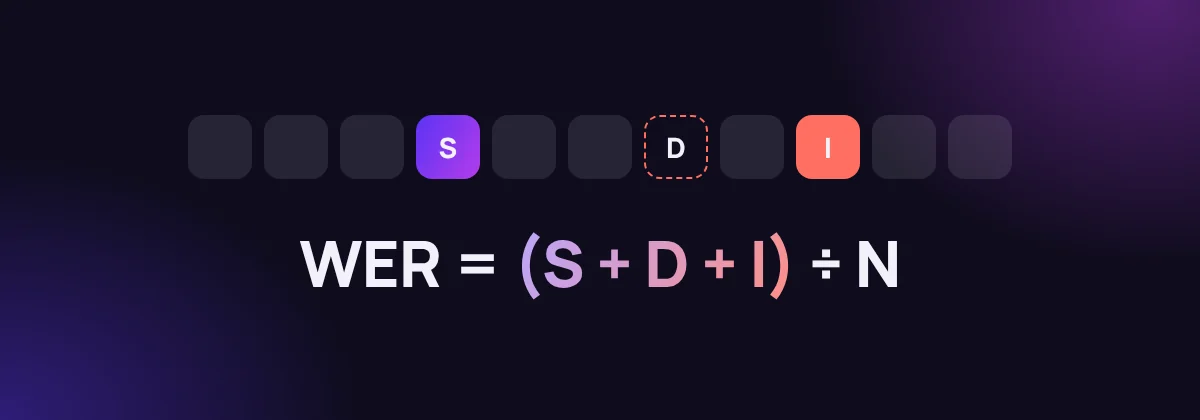
A taxa de erro de palavras (WER)
A medida padrão conta esses três tipos em relação a uma transcrição de referência correta:
WER = (substituições + apagamentos + inserções) ÷ número de palavras da referência
Um exemplo. A referência tem 10 palavras: «manda o relatório para a Maria até sexta de manhã». O sistema escreve «manda o relatório para o Mário até sexta de manhã»: 2 substituições, 0 apagamentos, 0 inserções. WER = 2 ÷ 10 = 20%.
O que a WER não diz
A WER é uma boa medida técnica e um mau resumo da experiência de uso:
- Todas as palavras pesam igual. Um «o» faltando e um «não» faltando custam um erro cada, mas só um inverte o sentido.
- Depende das regras de contagem. «5» contra «cinco» é erro? «OK» contra «okay»? O resultado varia conforme a normalização do texto antes da comparação.
- Ignora pontuação e formatação, ou seja, o trabalho da limpeza.
- Está presa ao seu conjunto de teste. Uma WER baixa em fala lida e limpa diz pouco sobre o seu sotaque, o seu microfone ou o vocabulário da sua área.
Por isso, comparar dois produtos só faz sentido com o mesmo áudio, o mesmo idioma, a mesma tarefa e as mesmas regras. Um nome de marca ou uma promessa de velocidade em anúncio não substituem essa comparação.
Ditar é mais rápido que digitar?
Veja o que encontraram estudos revisados por pares:
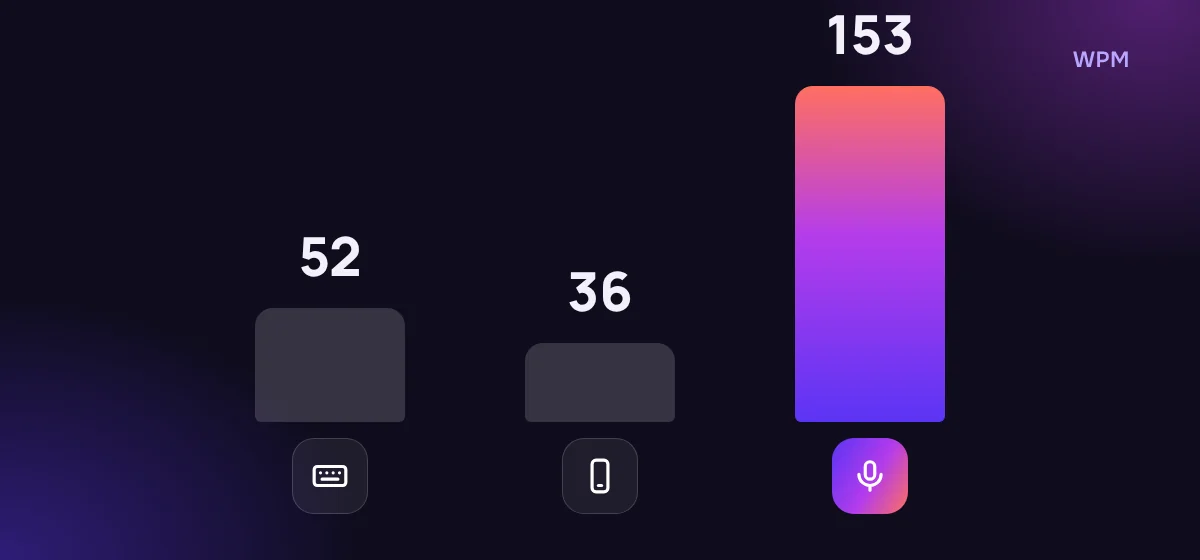
| Método | Velocidade média | Estudo |
|---|---|---|
| Teclado físico | 52 palavras por minuto | Dhakal et al., CHI 2018, 168.000 voluntários |
| Teclado touch do celular | 36,2 palavras por minuto | Palin et al., MobileHCI 2019, 37.370 voluntários |
| Voz no celular (inglês) | 153 palavras por minuto | Ruan et al., 2017, mensagens curtas em laboratório |
| Teclado do celular no mesmo estudo | 52 palavras por minuto | Ruan et al., 2017 |
No estudo de Stanford liderado por Ruan e colegas, a voz foi 2,93 vezes mais rápida que o teclado do celular em inglês e 2,87 vezes em chinês mandarim. Os participantes tiveram menos erros para corrigir no caminho (taxa de erros corrigidos de 5,3% contra 11,2% em inglês), embora tenham sobrado um pouco mais de erros no texto ditado final (1,3% contra 0,8%). Os estudos envolveram tarefas e pessoas diferentes: veja a comparação como ordem de grandeza, não como uma proporção exata. No trabalho também se gasta tempo pensando e revisando, então o ganho no dia a dia é menor que no laboratório, mas continua grande para mensagens longas.
O que piora os resultados
- Ruído e eco: vozes ao fundo, microfones distantes, salas grandes (veja redução de ruído e detecção de voz).
- Várias pessoas falando ao mesmo tempo.
- Áudio saturado: falar tão perto ou tão alto que o sinal distorce.
- Nomes e jargão desconhecidos, que o modelo viu poucas vezes (veja como o contexto ajuda o reconhecimento).
- Trocar de idioma no meio da frase, algo que alguns sistemas lidam mal.
A velocidade também tem um preço
A espera total soma várias etapas: fim da gravação, envio, reconhecimento, limpeza opcional e inserção do texto. Os sistemas em streaming ainda precisam decidir quando fixar as palavras, entre texto antecipado e correções posteriores. No SayVelio, os modos de ditado deixam você escolher: Rápido insere o texto reconhecido sem limpeza, Equilibrado e Máxima qualidade acrescentam a limpeza para um texto mais caprichado.
Confira sempre antes de enviar
Num texto que importa, é você quem revisa por último. Olhe duas vezes:
- números e valores, incluindo moedas e decimais;
- nomes de pessoas, empresas e produtos;
- negações: «não», «nunca», «nenhum»;
- datas e horários;
- orientações médicas, jurídicas e financeiras;
- tudo o que uma limpeza possa ter reformulado.
Uma correção fácil torna o ditado útil mesmo quando ele não é perfeito, mas a praticidade não prova que nenhum erro aconteceu.
Fontes
- Dhakal, V., Feit, A. M., Kristensson, P. O., Oulasvirta, A. Observations on Typing from 136 Million Keystrokes. CHI 2018. Resumo da Universidade de Cambridge
- Palin, K., Feit, A. M., Kim, S., Kristensson, P. O., Oulasvirta, A. How do People Type on Mobile Devices? Observations from a Study with 37,000 Volunteers. MobileHCI 2019. Página do projeto
- Ruan, S., Wobbrock, J. O., Liou, K., Ng, A., Landay, J. A. Comparing Speech and Keyboard Text Entry for Short Messages in Two Languages on Touchscreen Phones. Proceedings of the ACM on Interactive, Mobile, Wearable and Ubiquitous Technologies, 2017. arXiv:1608.07323
Perguntas
O que é uma boa WER?
Depende do áudio e da tarefa. Um ditado claro num lugar silencioso com um modelo recente costuma ter WER de poucos pontos percentuais, enquanto gravações barulhentas com várias vozes podem ficar bem acima disso. Compare sistemas só com o mesmo áudio e as mesmas regras.
A WER pode passar de 100%?
Sim. As inserções também contam: um sistema que acrescenta muitas palavras não ditas pode cometer mais erros do que havia palavras.
Leia também
 Primeiros passos
Como ditar bem: 9 hábitos para um texto limpo de primeira
Como falar para que o ditado acerte de primeira: segurar a tecla, dizer ideias completas, se corrigir em voz alta, ditar listas e o que fazer quando uma palavra sai errada.
MacWindowsiPhoneAndroid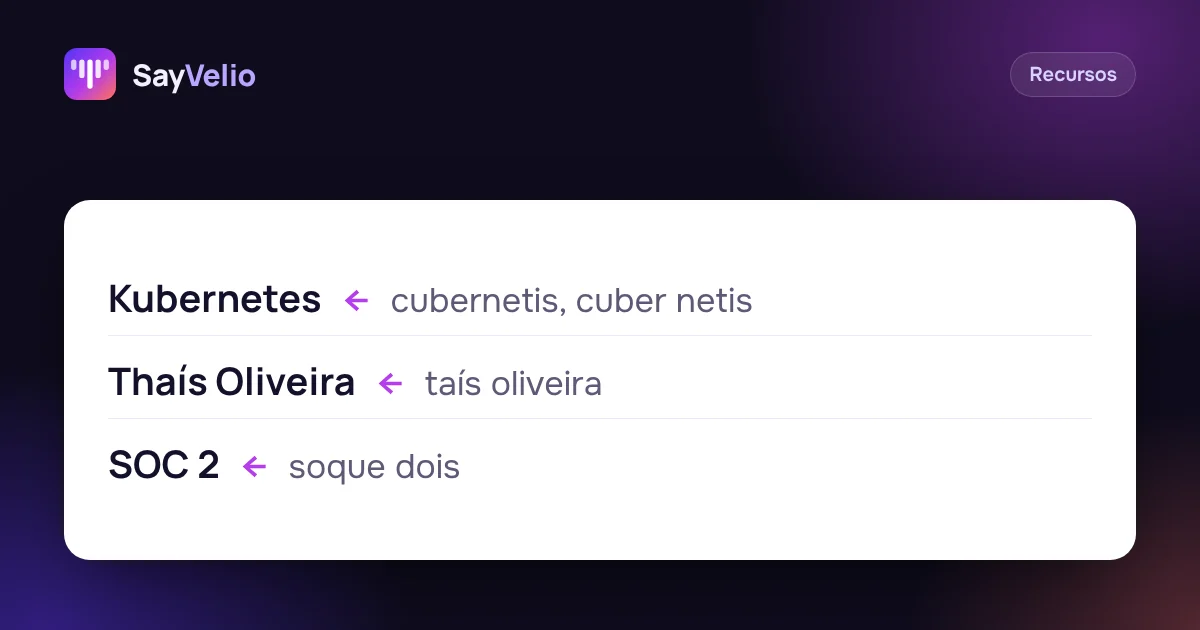 Recursos
Dicionário pessoal: ensine ao ditado seus nomes, marcas e jargões
O que colocar no seu dicionário do SayVelio e o que deixar de fora, como corrigir uma palavra que sempre sai errada e por que um dicionário curto funciona melhor que um longo.
MacWindowsiPhoneAndroid Recursos
Rápido, Equilibrado ou Máxima qualidade: qual modo de ditado escolher
O que cada modo do SayVelio faz com a sua voz, quanto tempo leva, por que frases curtas pulam a limpeza e qual modo combina com chats, e-mails e ditados longos.
MacWindowsiPhoneAndroid