
Preparando a voz para o reconhecimento: redução de ruído, controle de eco e detecção de voz
O que acontece com o áudio antes do reconhecimento de fala: controle automático de ganho, redução de ruído, cancelamento de eco, detecção de atividade de voz e espectrogramas, e por que um áudio mais limpo nem sempre é melhor.
Resumindo
Antes do reconhecimento, o áudio pode ser nivelado, limpo de eco e ruído e recortado nas partes que têm voz. Cada uma dessas etapas tem uma função precisa, nenhuma entende palavras e nenhuma é obrigatória. Uma redução de ruído forte demais pode até piorar as coisas, porque apaga as consoantes fracas que diferenciam uma palavra da outra.
Você disse
oi tomás segue a fatura em anexo me avisa se os números batem
O SayVelio escreveu
Oi Tomás,
segue a fatura em anexo. Me avisa se os números batem.
Processar o sinal não é reconhecer a fala
O processamento de sinal trabalha com o som, não com a língua. Ele pode deixar a voz mais alta, mais baixa ou mais nítida, ou decidir onde ela começa e termina, mas nunca decide quais palavras você disse. Isso é trabalho do modelo de reconhecimento, descrito em como funciona o reconhecimento de fala.
Quais etapas um app usa depende da situação. Uma chamada precisa de cancelamento de eco, porque a voz da outra pessoa sai pelo seu alto-falante. Um app de ditado sem nada tocando pode nem precisar disso.
Quatro ferramentas, quatro funções
| Ferramenta | O que faz | O que não consegue fazer |
|---|---|---|
| Controle automático de ganho | Sobe ou desce o nível de gravação | Recuperar uma voz que nunca foi bem captada |
| Redução de ruído | Atenua ruídos constantes como ventiladores ou trânsito | Separar duas pessoas falando ao mesmo tempo |
| Cancelamento de eco | Remove o som do seu alto-falante que volta para o microfone | Ajudar quando nada está tocando |
| Detecção de atividade de voz | Estima em quais momentos há voz | Saber o que foi dito |
O cancelamento de eco é o mais certeiro. Ele sabe exatamente o que o seu dispositivo está tocando, porque recebe uma cópia de referência, e subtrai a parte que o microfone capta de novo. A redução de ruído, por outro lado, precisa adivinhar o que é ruído.
Detecção de atividade de voz: encontrar a fala
Um detector de atividade de voz (VAD) examina trechos curtos de áudio, muitas vezes de 10 a 30 milissegundos, e estima a probabilidade de cada um conter voz. A versão mais simples olha só o volume, mas uma porta batendo passa do limite e uma voz baixa pode ficar abaixo dele. Os detectores melhores estimam uma probabilidade de voz por trecho, juntam as partes de fala próximas e descartam as curtas demais para serem palavras.
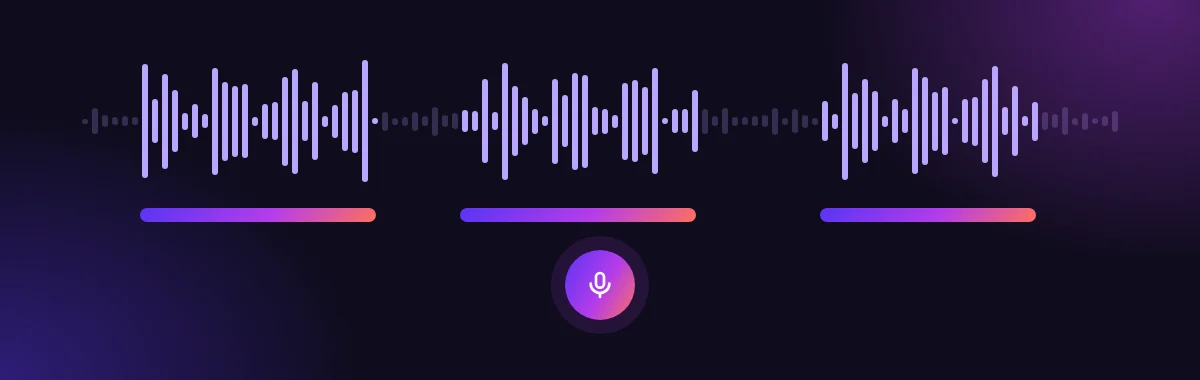
A detecção serve para pular o silêncio e perceber quando você terminou uma frase. Com «segure e fale», como no SayVelio, é você quem decide o início e o fim da gravação: ela dura exatamente o tempo em que a tecla de ditado está pressionada.
Por que mais limpo nem sempre é melhor
Dá vontade de achar que tirar mais ruído sempre ajuda. Não é assim. Consoantes como «s», «f», «t» e «ch» são sons fracos, parecidos com ruído, e uma redução agressiva pode afiná-las junto com o fundo. Para um ouvido humano o áudio parece mais limpo, mas o reconhecimento perdeu as pistas que separam «sete» de «seis».
Os modelos modernos são treinados com muita fala real e barulhenta, então muitas vezes se saem melhor com o som original do que com um áudio muito processado. Um bom processamento é delicado e testado em ditados reais, não só de ouvido.
Espectrogramas: como uma máquina vê o som
Muitos sistemas de reconhecimento não usam a forma de onda diretamente. Eles passam uma janela curta (normalmente de 20 a 30 ms) pelo áudio e medem quais frequências existem em cada uma. O resultado é um espectrograma: uma imagem com o tempo na horizontal, a altura na vertical e o brilho como energia.
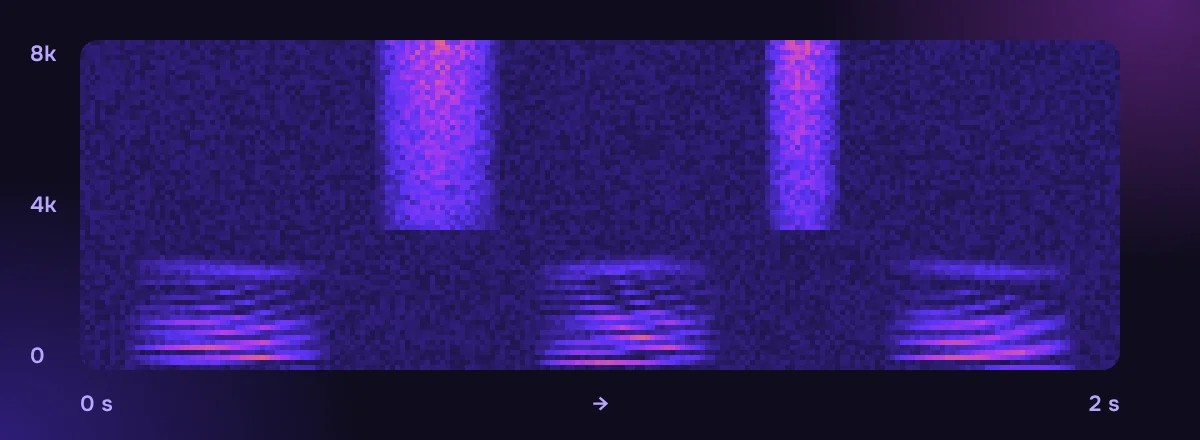
Um espectrograma não é uma transcrição. Ele mostra padrões sonoros que um modelo aprende a associar aos sons da fala. O tamanho da janela é um meio-termo: janelas curtas mostram bem o tempo, janelas longas mostram bem a altura. Alguns modelos mais recentes pulam essa etapa e aprendem direto das amostras.
O que você pode fazer
- Dite no lugar mais silencioso que tiver. Nem um bom processamento elimina um colega falando ao seu lado: a voz dele também é voz.
- Abaixe música e vídeos enquanto dita.
- Mantenha uma distância constante do microfone, assim o nível fica estável. Mais dicas em como ditar bem.
Perguntas
Uma qualidade de áudio melhor sempre dá um texto melhor?
Nem sempre. O que mais ajuda é uma voz clara em bom nível. Uma redução de ruído pesada, distorção ou um formato de áudio errado podem tirar detalhes que o reconhecimento precisa, e também contam o treinamento, o idioma e o vocabulário do modelo.
Dá para ditar num café barulhento?
Muitas vezes sim, principalmente com o microfone de um headset perto da boca. Um ruído constante, como a máquina de café, é mais fácil de lidar do que outras vozes por perto.
Leia também
 Como funciona a digitação por voz
Da onda sonora ao áudio digital: o que o seu microfone grava quando você dita
Como o microfone e o dispositivo transformam a voz em números: taxa de amostragem, profundidade de bits, áudio mono, reamostragem e por que a posição do microfone importa mais que as especificações.
MacWindowsiPhoneAndroid Como funciona a digitação por voz
Como o reconhecimento de fala transforma som em palavras
Por que a fala é difícil para o computador, como funcionavam os reconhecedores clássicos com modelos acústico, de pronúncia e de linguagem, o que os modelos ponta a ponta (CTC, encoder-decoder, transducers) mudaram e por que o texto em streaming pode mudar enquanto você fala.
MacWindowsiPhoneAndroid Primeiros passos
Como ditar bem: 9 hábitos para um texto limpo de primeira
Como falar para que o ditado acerte de primeira: segurar a tecla, dizer ideias completas, se corrigir em voz alta, ditar listas e o que fazer quando uma palavra sai errada.
MacWindowsiPhoneAndroid