
Audioformate und Kompression bei der Spracheingabe
Digitales Audio, Kodierung und Kompression sind drei verschiedene Dinge. Wie verlustfreie und verlustbehaftete Kompression funktionieren, warum kein Verfahren jede Datei verkleinern kann, wie Sprachcodecs wie Opus Größe gegen Verzögerung abwägen und was das fürs Diktieren heißt.
Kurz gesagt
Unkomprimiertes Sprach-Audio sind etwa 32 KB pro Sekunde. Kompression macht es kleiner: Verlustfrei bleibt jedes Bit erhalten, verlustbehaftet fallen Details weg, die Menschen kaum hören. Sprachcodecs wie Opus sind sehr effizient, aber zu starkes Komprimieren kann Laute entfernen, die die Erkennung braucht. Kompression betrifft den Transport von Audio, mit dem Verstehen von Wörtern hat sie nichts zu tun.
Du sagst
die aufnahme ist zu groß für eine mail ich schicke lieber einen link
SayVelio schrieb
Die Aufnahme ist zu groß für eine Mail, ich schicke lieber einen Link.
Drei Begriffe, die oft verwechselt werden
- Digitales Audio ist Ton als Zahlen: Abtastwerte, viele Male pro Sekunde genommen (siehe wie Mikrofone Sprache aufnehmen).
- Kodierung heißt, diese Information in einem bestimmten Format zu schreiben, mit vereinbarten Regeln, wie man sie zurückliest.
- Kompression ist eine Kodierung, die weniger Bits braucht als die einfache Darstellung.
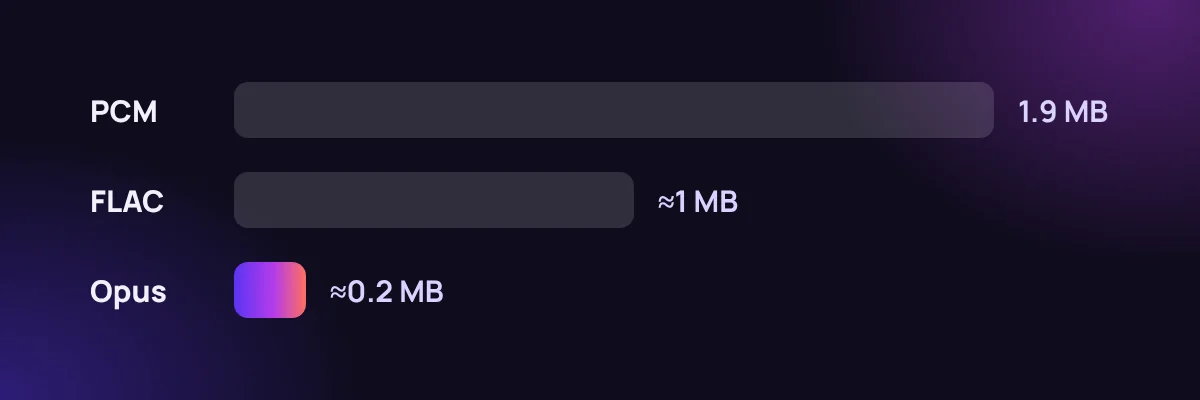
Unkomprimiertes Audio, meist PCM genannt, speichert jeden Abtastwert direkt. Eine WAV-Datei ist typischerweise PCM mit einem kleinen Dateikopf. Komprimierte Formate beschreiben denselben Ton mit Regeln und weniger Daten.
Verlustfrei und verlustbehaftet
Verlustfreie Kompression wie bei FLAC stellt die ursprünglichen Abtastwerte exakt wieder her. Sie nutzt Struktur: Benachbarte Werte in Sprache ähneln sich, also ist es günstiger, eine Vorhersage plus eine kleine Korrektur zu speichern als jeden Wert vollständig. Bei Audio spart das meist moderat, oft etwa die Hälfte.
Verlustbehaftete Kompression wie bei MP3, AAC oder Opus wirft bewusst Information weg, die Hörer kaum bemerken, und behält den Rest. Das spart viel mehr, oft das Zehnfache oder mehr, aber das Original lässt sich nicht wiederherstellen.
Warum sich nicht alles komprimieren lässt
Es gibt eine harte mathematische Grenze: Kein verlustfreies Verfahren kann jede mögliche Datei verkleinern. Könnte es das, ließe sich die Ausgabe immer wieder komprimieren, bis jede Datei ein Bit groß wäre, und dann müssten sich zwei verschiedene Dateien dieselbe komprimierte Form teilen. Kompression funktioniert nur, wenn Daten Muster haben. Zufällig wirkende oder schon komprimierte Daten schrumpfen kaum. Deshalb bringt es fast nichts, eine MP3 zu zippen.
Sprachcodecs: für die Stimme gebaut
Die Stimme hat Struktur, die allgemeine Kompression nicht kennt: Der Vokaltrakt formt Klang auf vorhersagbare Weise. Sprachcodecs nutzen das. Opus, der offene Codec, den die IETF 2012 standardisiert hat und den viele Telefonie-Apps und Browser nutzen, kombiniert zwei Ansätze:
- SILK, basierend auf linearer Prädiktion, modelliert, wie der Vokaltrakt Klang formt. Sehr effizient für Sprache.
- CELT, basierend auf einer Frequenztransformation (MDCT), kann Musik und breitbandigen Klang gut.
- Ein Hybrid-Modus nutzt beide für unterschiedliche Frequenzbereiche.
Opus arbeitet mit Bitraten von 6 bis 510 kbit/s, verglichen mit 256 kbit/s für rohe 16-kHz-Sprache.
Größe, Qualität und Verzögerung ziehen in verschiedene Richtungen
Bei Live-Audio ist Kompression ein Ausgleich zwischen drei Dingen:
| Wenn du wählst | Gewinn | Preis |
|---|---|---|
| Niedrigere Bitrate | Weniger Daten, klappt auch in schwachen Netzen | Verlorene Details, vor allem Konsonanten |
| Längere Frames (bis 60 ms bei Opus) | Weniger Overhead pro Sekunde | Mehr Verzögerung; ein verlorenes Paket kostet mehr Sprache |
| Kürzere Frames (ab 2,5 ms) | Weniger Verzögerung | Mehr Overhead pro Sekunde |
Ein Telefonat braucht vor allem geringe Verzögerung. Ein Diktat, das nach dem Sprechen erkannt wird, braucht eher die Details, auf die die Erkennung angewiesen ist, denn die entscheiden, ob „fünfzehn“ als „fünfzig“ herauskommt.
Was das fürs Diktieren heißt
Kompression ist eine Transportentscheidung, kein Teil der Erkennung. Ein Erkenner kann unkomprimiertes PCM, einen komprimierten Stream oder ein anderes unterstütztes Format erhalten, und keine Diktier-App muss einen bestimmten Codec nutzen. Für dich zählt:
- Moderate Kompression ist in Ordnung. Moderne Sprachmodelle kommen mit gut kodiertem Audio problemlos klar.
- Aggressive Kompression kostet Genauigkeit. Sehr niedrige Bitraten verwischen genau die leisen Laute, die ähnliche Wörter unterscheiden.
- Bluetooth-Headsets komprimieren auch. Viele schalten bei aktivem Mikrofon in einen schmalen Modus mit niedriger Bitrate, was oft mehr kostet als alles, was die App tut.
Häufige Fragen
Macht Kompression Diktieren ungenauer?
Leichte Kompression spielt kaum eine Rolle. Sehr starke Kompression oder ein Bluetooth-Headset im schwachen Telefonmodus können Details entfernen und ähnliche Wörter schwerer unterscheidbar machen.
Ist Kompression dasselbe wie Verschlüsselung?
Nein. Kompression macht Daten kleiner, Verschlüsselung macht sie für alle ohne Schlüssel unlesbar. Eine Aufnahme kann komprimiert, verschlüsselt, beides oder keins davon sein. Verschlüsselung behandelt der Artikel Datenschutz bei der Spracheingabe.
Weiterlesen
 So funktioniert Spracheingabe
Von der Schallwelle zum digitalen Audio: was dein Mikrofon beim Diktieren aufnimmt
Wie Mikrofon und Gerät Sprache in Zahlen verwandeln: Abtastrate, Bittiefe, Mono, Resampling und warum die Position des Mikrofons wichtiger ist als technische Daten.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Wie Spracherkennung aus Ton Wörter macht
Warum Sprache für Computer schwer ist, wie klassische Erkenner mit akustischem Modell, Aussprachewörterbuch und Sprachmodell arbeiteten, was End-to-End-Modelle (CTC, Encoder-Decoder, Transducer) geändert haben und warum sich Text beim Streaming noch ändert.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Spracherkennung und Sprachsynthese: Was ist der Unterschied?
Spracherkennung macht aus Stimme Text, Sprachsynthese aus Text Stimme. Wie beides funktioniert, wo sie sich treffen (Zahlen, Daten, Namen), wie sich Sprachcodecs von beiden unterscheiden und warum eine Diktier-App keinen Text vorliest.
MacWindowsiPhoneAndroid