
Spracherkennung und Sprachsynthese: Was ist der Unterschied?
Spracherkennung macht aus Stimme Text, Sprachsynthese aus Text Stimme. Wie beides funktioniert, wo sie sich treffen (Zahlen, Daten, Namen), wie sich Sprachcodecs von beiden unterscheiden und warum eine Diktier-App keinen Text vorliest.
Kurz gesagt
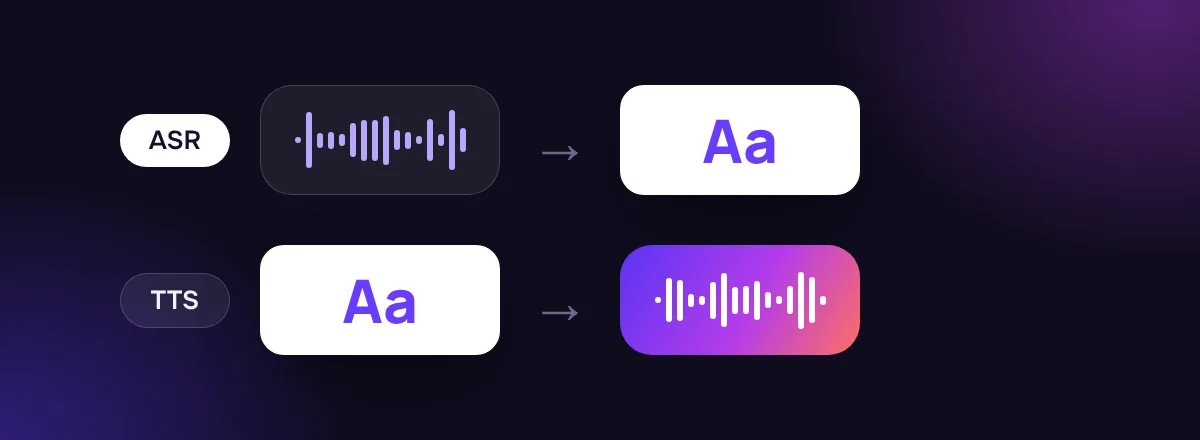
Spracherkennung (ASR) hört zu und schreibt: Audio rein, Text raus. Sprachsynthese (TTS) liest und spricht: Text rein, Audio raus. Sie treten in Sprachassistenten oft gemeinsam auf, sind aber getrennte Technologien mit anderem Training, anderen Ergebnissen und anderen Qualitätsmaßen. Eine dritte Technologie, der Sprachcodec, verkleinert Audio nur für den Versand und macht keins von beidem.
Du sagst
das meeting wurde auf den zwölften um fünfzehn uhr dreißig verschoben
SayVelio schrieb
Das Meeting wurde auf den 12. um 15:30 Uhr verschoben.
Entgegengesetzte Richtungen
| Spracherkennung (ASR) | Sprachsynthese (TTS) | Sprachcodec | |
|---|---|---|---|
| Eingabe | Audio einer sprechenden Person | Geschriebener Text | Audio |
| Ausgabe | Text | Synthetisches Sprach-Audio | Dasselbe Audio, kleiner |
| Kernfrage | Welche Wörter wurden gesagt? | Wie soll dieser Text klingen? | Wie verschickt man diesen Ton effizient? |
| Typischer Einsatz | Diktieren, Untertitel, Sprachsuche | Bildschirmleser, Navigation, Hörbücher | Telefonate, Sprachnachrichten |
| Qualität gemessen an | Wortfehlerrate | Bewertungen von Natürlichkeit und Verständlichkeit | Hörtests bei gegebener Bitrate |
Ein Sprachassistent nutzt beides: Erkennung, um deine Frage zu verstehen, Synthese, um laut zu antworten. Aber das eine bedingt nicht das andere. SayVelio ist eine Diktier-App: Sie erkennt Sprache und schreibt Text, liest aber nichts vor.
Wie Sprachsynthese funktioniert
Ein typisches TTS-System arbeitet in Stufen:
- Textanalyse. Abkürzungen und Zahlen in Wörter auflösen („Str.“ heißt „Straße“ oder „Strecke“?) und die richtige Aussprache für gleich geschriebene, verschieden gesprochene Wörter wählen („umfahren“ als Umweg oder als Unfall).
- Prosodie. Rhythmus, Pausen, Betonung und Tonhöhe festlegen, damit eine Frage wie eine Frage klingt.
- Akustisches Modell. Vorhersagen, wie die Sprache über die Zeit klingen soll, oft als Spektrogramm.
- Vocoder. Aus dieser Vorhersage eine echte Wellenform machen, die man abspielen kann.
Ein bekanntes Beispiel ist Tacotron 2 von Google (2018), das aus Text ein Mel-Spektrogramm vorhersagt und mit einem neuronalen Vocoder den Ton erzeugt. Viele neuere Systeme fassen diese Stufen zusammen oder ordnen sie neu, aber die Aufgabe jeder Stufe bleibt.
Entwickler können TTS mit SSML (Speech Synthesis Markup Language) steuern, einem W3C-Standard, um Pausen, Betonung, Aussprache und das Vorlesen von Daten und Ähnlichem auszuzeichnen. Wie viel von SSML unterstützt wird, ist je nach Engine verschieden.
Wo sich beide treffen: Zahlen, Daten und Namen
Beide Richtungen kämpfen mit denselben Dingen, nur von entgegengesetzten Seiten:
- Diktieren muss gesprochenes „zwölf fünfzig“ in Schrift übertragen: 12:50? 1250? 12,50 €? Das ist inverse Textnormalisierung, beschrieben in vom Transkript zum Text.
- Sprachsynthese muss geschriebenes „12/05“ in Sprache übertragen: der fünfte Dezember oder der zwölfte Mai? Das ist Textnormalisierung.
Beides hängt zusammen, ist aber kein exaktes Spiegelbild, weil die richtige Antwort in beiden Richtungen vom Kontext abhängt. Namen sind in beiden Richtungen schwer: Ein Erkenner muss wissen, wie ein gehörter Name geschrieben wird (dafür gibt es das Wörterbuch), ein Synthesizer, wie ein gelesener Name ausgesprochen wird.
Codecs sind eine dritte, eigene Sache
Ein Sprachcodec wie Opus stellt schon vorhandenes Audio mit weniger Bits dar, damit es verschickt oder gespeichert werden kann. Er erzeugt keine Sprache aus Text und entscheidet nicht, welche Wörter jemand gesagt hat. Ein Produkt, das Sprache transkribiert, muss weder Sprache synthetisieren noch einen bestimmten Codec nutzen. Mehr dazu im Artikel Audiokompression für Sprache.
Beide nutzen maschinelles Lernen, aber anders
Moderne ASR und TTS bauen beide auf neuronalen Netzen auf und lernen beide aus Paaren von Audio und Text. Ihre Ziele sind aber gegensätzlich: ASR wird danach beurteilt, ob die Wörter stimmen, TTS danach, ob Menschen die Stimme natürlich und verständlich finden. Ein Modell, das das eine hervorragend kann, kann das andere nicht automatisch.
Häufige Fragen
Kann SayVelio mir meinen Text vorlesen?
Nein. SayVelio ist zum Schreiben per Stimme da. Zum Vorlesen nutz die eingebaute Funktion deines Systems: „Gesprochene Inhalte“ auf Mac und iPhone, die Sprachausgabe (Narrator) unter Windows, „Vorlesen“ (Select to Speak) auf Android.
Ist „Sprache zu Text“ dasselbe wie „Stimmerkennung“?
Meist ist dasselbe gemeint, aber streng genommen kann Stimmerkennung auch heißen, zu erkennen, wer spricht. SayVelio erkennt, was du sagst, nicht wer du bist.
Weiterlesen
 So funktioniert Spracheingabe
Wie Spracherkennung aus Ton Wörter macht
Warum Sprache für Computer schwer ist, wie klassische Erkenner mit akustischem Modell, Aussprachewörterbuch und Sprachmodell arbeiteten, was End-to-End-Modelle (CTC, Encoder-Decoder, Transducer) geändert haben und warum sich Text beim Streaming noch ändert.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Vom Roh-Transkript zum lesbaren Text: Satzzeichen, Zahlen und Bereinigung
Warum ein rohes Sprach-Transkript nicht versandfertig ist, wie Satzzeichen, Großschreibung, Zahlen und Listen dazukommen, warum „fünf fünfzig“ mehrdeutig ist und wie die Bereinigung deinen Sinn nicht verändert.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Audioformate und Kompression bei der Spracheingabe
Digitales Audio, Kodierung und Kompression sind drei verschiedene Dinge. Wie verlustfreie und verlustbehaftete Kompression funktionieren, warum kein Verfahren jede Datei verkleinern kann, wie Sprachcodecs wie Opus Größe gegen Verzögerung abwägen und was das fürs Diktieren heißt.
MacWindowsiPhoneAndroid