
Formatos de áudio e compressão na digitação por voz
Áudio digital, codificação e compressão são três coisas diferentes. Como funcionam a compressão sem perdas e com perdas, por que nenhum algoritmo reduz todo arquivo, como codecs de voz como o Opus equilibram tamanho e atraso e o que isso significa para o ditado.
Resumindo
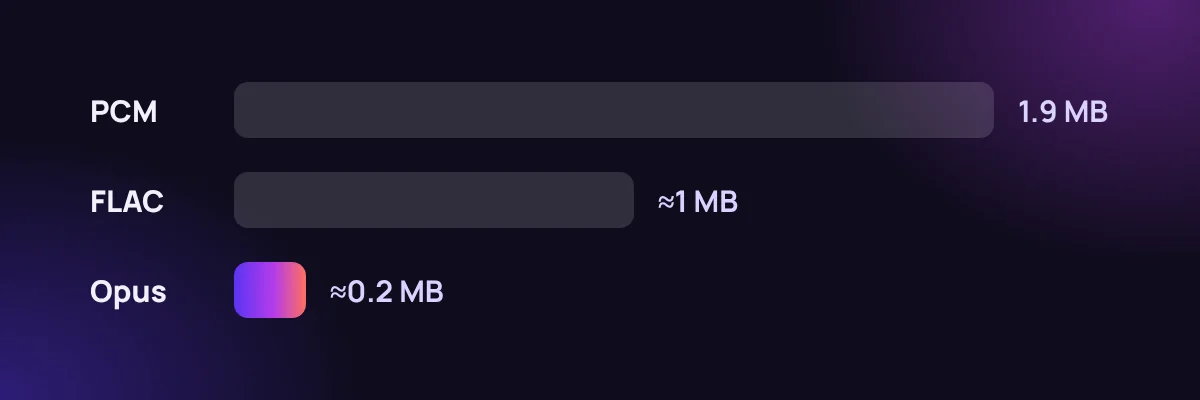
Áudio de fala sem compressão ocupa cerca de 32 KB por segundo. A compressão o deixa menor: a compressão sem perdas mantém cada bit, a com perdas descarta detalhes que dificilmente alguém ouviria. Codecs de voz como o Opus são muito eficientes, mas apertar demais pode remover sons de que o reconhecimento precisa. A compressão serve para transportar o áudio; não tem nada a ver com entender palavras.
Você disse
a gravação é grande demais pra mandar por e-mail então vou compartilhar um link
O SayVelio escreveu
A gravação é grande demais pra mandar por e-mail, então vou compartilhar um link.
Três palavras que costumam se confundir
- Áudio digital é o som representado como números: amostras tiradas muitas vezes por segundo (veja como o microfone grava a voz).
- Codificação é escrever essa informação num formato específico, com regras combinadas para lê-la de volta.
- Compressão é uma codificação que usa menos bits que a representação simples.
O áudio sem compressão, normalmente chamado de PCM, guarda cada amostra diretamente. Um arquivo WAV costuma ser PCM com um pequeno cabeçalho. Os formatos comprimidos usam regras para descrever o mesmo som com menos dados.
Sem perdas e com perdas
A compressão sem perdas, como o FLAC, permite reconstruir exatamente as amostras originais. Ela funciona encontrando estrutura: na fala, amostras vizinhas são parecidas, então sai mais barato guardar uma previsão mais uma pequena correção do que cada amostra inteira. A economia típica para áudio é modesta, muitas vezes por volta da metade.
A compressão com perdas, como MP3, AAC ou Opus, descarta de propósito informações que quem ouve dificilmente notaria e mantém o resto. A economia é bem maior, muitas vezes dez vezes ou mais, mas o original não pode ser recuperado.
Por que nada comprime tudo
Existe um limite matemático rígido: nenhum método sem perdas consegue diminuir todos os arquivos possíveis. Se conseguisse, daria para comprimir o resultado de novo e de novo até cada arquivo ter um bit, e aí dois arquivos diferentes teriam que dividir a mesma forma comprimida. A compressão só funciona quando os dados têm padrões para aproveitar. Dados com cara de aleatórios, ou já comprimidos, quase não diminuem. Por isso zipar um MP3 praticamente não faz nada.
Codecs de voz: feitos para a voz
A voz tem uma estrutura que a compressão genérica não conhece: o trato vocal molda o som de formas previsíveis. Os codecs de voz aproveitam isso. O Opus, codec aberto padronizado pela IETF em 2012 e usado em muitos apps de chamada e navegadores, combina duas abordagens:
- SILK, baseado em predição linear, modela como o trato vocal dá forma ao som. É muito eficiente para fala.
- CELT, baseado numa transformada de frequência (MDCT), lida bem com música e som de banda larga.
- Um modo híbrido usa os dois em faixas de frequência diferentes.
O Opus trabalha com taxas de 6 a 510 kbit/s, contra 256 kbit/s da fala sem compressão a 16 kHz.
Tamanho, qualidade e atraso puxam para lados opostos
Para áudio ao vivo, a compressão é um equilíbrio entre três coisas:
| Se você escolhe | Você ganha | Você paga |
|---|---|---|
| Taxa de bits menor | Menos dados, funciona em redes fracas | Detalhes perdidos, principalmente consoantes |
| Quadros mais longos (até 60 ms no Opus) | Menos sobrecarga por segundo | Mais atraso; um pacote perdido leva mais fala |
| Quadros mais curtos (até 2,5 ms) | Menos atraso | Mais sobrecarga por segundo |
Uma ligação precisa, acima de tudo, de pouco atraso. Um ditado reconhecido depois que você termina de falar se importa mais em manter os detalhes de que o reconhecimento precisa, porque são eles que decidem se «sete» vira «seis».
O que isso significa para o ditado
A compressão é uma decisão de transporte, não parte do reconhecimento. Um reconhecedor pode receber PCM sem compressão, um fluxo comprimido ou outro formato aceito, e nenhum app de ditado é obrigado a usar um codec específico. O que importa para você:
- Compressão moderada não tem problema. Os modelos de fala modernos lidam bem com áudio bem codificado.
- Compressão agressiva custa precisão. Taxas muito baixas borram justamente os sons fracos que separam palavras parecidas.
- Fones Bluetooth também comprimem. Muitos passam para um modo limitado e de baixa taxa quando o microfone está em uso, o que costuma ser uma perda maior que qualquer coisa que o app faça.
Perguntas
A compressão deixa o ditado menos preciso?
Uma compressão leve quase não faz diferença. Uma compressão muito forte, ou um fone Bluetooth no modo de chamada de baixa qualidade, pode remover detalhes e dificultar a distinção entre palavras parecidas.
Compressão é o mesmo que criptografia?
Não. A compressão deixa os dados menores; a criptografia os torna ilegíveis para quem não tem a chave. Uma gravação pode ser comprimida, criptografada, as duas coisas ou nenhuma. A criptografia é tratada em privacidade na digitação por voz.
Leia também
 Como funciona a digitação por voz
Da onda sonora ao áudio digital: o que o seu microfone grava quando você dita
Como o microfone e o dispositivo transformam a voz em números: taxa de amostragem, profundidade de bits, áudio mono, reamostragem e por que a posição do microfone importa mais que as especificações.
MacWindowsiPhoneAndroid Como funciona a digitação por voz
Como o reconhecimento de fala transforma som em palavras
Por que a fala é difícil para o computador, como funcionavam os reconhecedores clássicos com modelos acústico, de pronúncia e de linguagem, o que os modelos ponta a ponta (CTC, encoder-decoder, transducers) mudaram e por que o texto em streaming pode mudar enquanto você fala.
MacWindowsiPhoneAndroid Como funciona a digitação por voz
Reconhecimento de fala e síntese de voz: qual é a diferença
O reconhecimento de fala transforma voz em texto; a síntese de voz transforma texto em voz. Como cada um funciona, onde se encontram (números, datas, nomes), em que os codecs de voz diferem dos dois e por que um app de ditado não lê o texto em voz alta.
MacWindowsiPhoneAndroid