
Formats et compression audio dans la saisie vocale
Audio numérique, encodage et compression sont trois choses distinctes. Comment fonctionnent la compression sans perte et avec perte, pourquoi aucun algorithme ne peut réduire tous les fichiers, comment les codecs vocaux comme Opus arbitrent entre taille et latence, et ce que cela change pour la dictée.
En bref
De la parole non compressée, c'est environ 32 Ko par seconde. La compression réduit ce volume : sans perte, chaque bit est conservé ; avec perte, on jette des détails qu'on n'entendrait guère. Les codecs vocaux comme Opus sont très efficaces, mais trop compresser peut retirer des sons dont la reconnaissance a besoin. La compression concerne le transport du son, pas la compréhension des mots.
Vous avez dit
l'enregistrement est trop lourd pour un mail donc je t'envoie plutôt un lien
SayVelio a écrit
L'enregistrement est trop lourd pour un mail, donc je t'envoie plutôt un lien.
Trois mots souvent confondus
- L'audio numérique, c'est le son représenté par des nombres : des échantillons pris de nombreuses fois par seconde (voir comment le micro capte la voix).
- Encoder, c'est écrire ces informations dans un format donné, avec des règles convenues pour les relire.
- Compresser, c'est encoder en utilisant moins de bits que la représentation brute.
L'audio non compressé, souvent appelé PCM, stocke chaque échantillon directement. Un fichier WAV est généralement du PCM avec un petit en-tête. Les formats compressés décrivent le même son avec moins de données, selon leurs propres règles.
Sans perte et avec perte
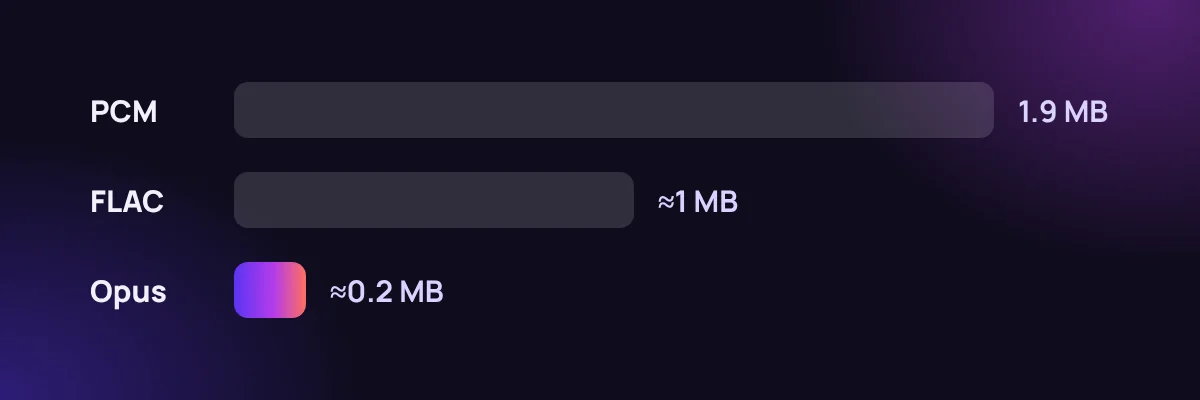
La compression sans perte, comme FLAC, permet de reconstruire exactement les échantillons d'origine. Elle exploite la structure : des échantillons voisins de parole se ressemblent, il est donc plus économique de stocker une prédiction et une petite correction que chaque échantillon en entier. Pour l'audio, le gain reste modeste, souvent autour de la moitié.
La compression avec perte, comme MP3, AAC ou Opus, jette volontairement des informations que l'auditeur remarquera difficilement et garde le reste. Le gain est bien plus grand, souvent dix fois ou plus, mais l'original ne peut pas être restauré.
Pourquoi on ne peut pas tout compresser
Il existe une limite mathématique stricte : aucune méthode sans perte ne peut réduire tous les fichiers possibles. Si c'était le cas, on pourrait recompresser le résultat encore et encore jusqu'à ce que chaque fichier fasse un bit, et deux fichiers différents partageraient alors la même forme compressée. La compression ne marche que si les données ont des régularités. Des données d'apparence aléatoire, ou déjà compressées, rétrécissent à peine. C'est pourquoi zipper un MP3 ne sert presque à rien.
Les codecs vocaux : conçus pour la voix
La voix a une structure que la compression généraliste ignore : le conduit vocal façonne le son de manière prévisible. Les codecs vocaux en tirent parti. Opus, codec ouvert normalisé par l'IETF en 2012 et utilisé par de nombreuses apps d'appel et navigateurs, combine deux approches :
- SILK, fondé sur la prédiction linéaire, modélise la façon dont le conduit vocal façonne le son. Très efficace pour la parole.
- CELT, fondé sur une transformée fréquentielle (MDCT), gère bien la musique et le son large bande.
- Un mode hybride utilise les deux pour des plages de fréquences différentes.
Opus fonctionne de 6 à 510 kbit/s, contre 256 kbit/s pour de la parole brute à 16 kHz.
Taille, qualité et latence tirent dans des sens opposés
En audio en direct, compresser, c'est équilibrer trois choses :
| Si vous choisissez | Vous gagnez | Vous payez |
|---|---|---|
| Un débit plus bas | Moins de données, fonctionne sur réseau faible | Perte de détails, surtout les consonnes |
| Des trames plus longues (jusqu'à 60 ms avec Opus) | Moins de surcoût par seconde | Plus de latence ; un paquet perdu emporte plus de parole |
| Des trames plus courtes (dès 2,5 ms) | Moins de latence | Plus de surcoût par seconde |
Un appel a surtout besoin d'une faible latence. Une dictée reconnue après que vous avez fini de parler a davantage besoin de garder les détails utiles à la reconnaissance : ce sont eux qui évitent que « seize » devienne « six ».
Ce que cela change pour la dictée
La compression est un choix de transport, pas une partie de la reconnaissance. Un système de reconnaissance peut recevoir du PCM non compressé, un flux compressé ou un autre format pris en charge, et aucune app de dictée n'est tenue d'utiliser un codec précis. Ce qui compte pour vous :
- Une compression modérée ne pose pas de problème. Les modèles vocaux actuels gèrent sans souci un son bien encodé.
- Une compression agressive coûte en précision. Des débits très bas brouillent justement les sons discrets qui distinguent des mots proches.
- Les casques Bluetooth compressent aussi. Beaucoup passent dans un mode étroit à bas débit quand le micro est actif, ce qui coûte souvent plus que tout ce que fait l'app.
Questions fréquentes
La compression rend-elle la dictée moins précise ?
Une compression légère n'a presque pas d'effet. Une compression très forte, ou un casque Bluetooth en mode appel basse qualité, peut retirer des détails et rendre les mots proches plus difficiles à distinguer.
Compresser, est-ce chiffrer ?
Non. Compresser rend les données plus petites ; chiffrer les rend illisibles sans la clé. Un enregistrement peut être compressé, chiffré, les deux ou aucun. Le chiffrement est expliqué dans la confidentialité de la saisie vocale.
À lire aussi
 Comment fonctionne la saisie vocale
De l'onde sonore à l'audio numérique : ce que votre micro enregistre pendant la dictée
Comment le micro et l'appareil transforment la parole en nombres : fréquence d'échantillonnage, résolution, mono, rééchantillonnage, et pourquoi la position du micro compte plus que ses caractéristiques.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
Comment la reconnaissance vocale transforme le son en mots
Pourquoi la parole est difficile pour un ordinateur, comment fonctionnaient les systèmes classiques avec modèles acoustique, de prononciation et de langage, ce que les modèles de bout en bout (CTC, encodeur-décodeur, transducteurs) ont changé, et pourquoi le texte en streaming bouge pendant que vous parlez.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
Reconnaissance vocale et synthèse vocale : quelle différence ?
La reconnaissance vocale transforme la voix en texte, la synthèse vocale le texte en voix. Comment fonctionne chacune, où elles se rejoignent (nombres, dates, noms), en quoi les codecs vocaux diffèrent des deux, et pourquoi une app de dictée ne lit pas le texte à voix haute.
MacWindowsiPhoneAndroid