
Formati audio e compressione nella dettatura vocale
Audio digitale, codifica e compressione sono tre cose diverse. Come funzionano la compressione senza perdita e con perdita, perché nessun algoritmo può ridurre ogni file, come i codec vocali come Opus bilanciano dimensione e ritardo e cosa significa per la dettatura.
In breve
L'audio vocale non compresso occupa circa 32 KB al secondo. La compressione lo rende più piccolo: quella senza perdita conserva ogni bit, quella con perdita elimina dettagli che difficilmente si sentono. I codec vocali come Opus sono molto efficienti, ma comprimere troppo può togliere suoni che servono al riconoscimento. La compressione serve a trasportare l'audio; non ha niente a che fare con il capire le parole.
Hai detto
la registrazione è troppo pesante per l'email quindi condivido un link
SayVelio ha scritto
La registrazione è troppo pesante per l'email, quindi condivido un link.
Tre parole che spesso si confondono
- L'audio digitale è il suono rappresentato come numeri: campioni presi molte volte al secondo (vedi come il microfono registra la voce).
- La codifica è il modo in cui queste informazioni vengono scritte in un certo formato, con regole condivise per rileggerle.
- La compressione è una codifica che usa meno bit della rappresentazione semplice.
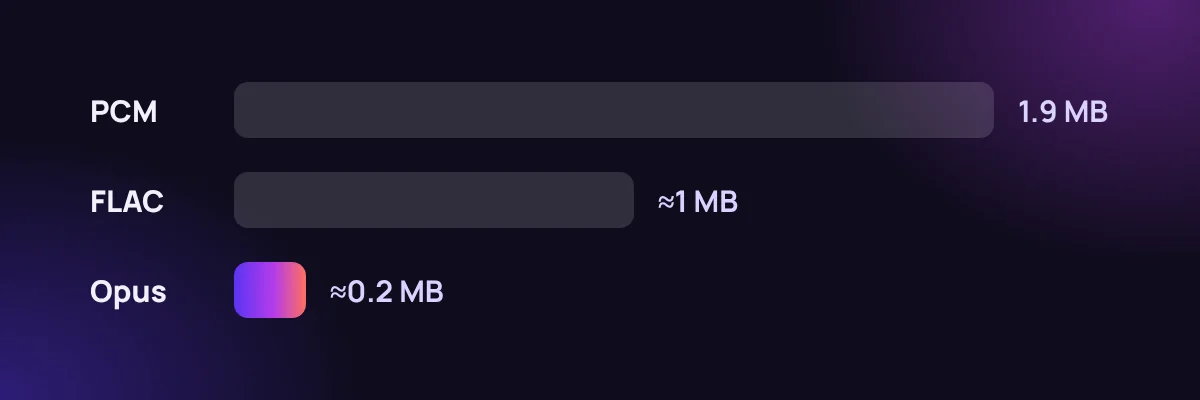
L'audio non compresso, di solito chiamato PCM, memorizza ogni campione direttamente. Un file WAV è in genere PCM con un piccolo header. I formati compressi usano delle regole per descrivere lo stesso suono con meno dati.
Senza perdita e con perdita
La compressione senza perdita, come FLAC, permette di ricostruire esattamente i campioni originali. Funziona trovando una struttura: nel parlato i campioni vicini si somigliano, quindi costa meno salvare una previsione più una piccola correzione che ogni campione per intero. Per l'audio il risparmio tipico è moderato, spesso intorno alla metà.
La compressione con perdita, come MP3, AAC o Opus, elimina di proposito le informazioni che chi ascolta difficilmente noterebbe e conserva il resto. Il risparmio è molto maggiore, spesso dieci volte o più, ma l'originale non si può ripristinare.
Perché niente può comprimere tutto
C'è un limite matematico rigido: nessun metodo senza perdita può rendere più piccolo ogni file possibile. Se potesse, potresti comprimere il risultato ancora e ancora finché ogni file non fosse di un solo bit, e a quel punto due file diversi dovrebbero condividere la stessa forma compressa. La compressione funziona solo quando i dati hanno schemi da sfruttare. I dati dall'aspetto casuale, o già compressi, si riducono appena. Per questo zippare un MP3 non serve quasi a nulla.
Codec vocali: fatti per la voce
La voce ha una struttura che la compressione generica non conosce: il tratto vocale modella il suono in modi prevedibili. I codec vocali ne approfittano. Opus, il codec aperto standardizzato dall'IETF nel 2012 e usato in molte app di chiamata e nei browser, unisce due approcci:
- SILK, basato sulla predizione lineare, modella come il tratto vocale dà forma al suono. È molto efficiente per il parlato.
- CELT, basato su una trasformata in frequenza (MDCT), gestisce bene la musica e il suono a banda larga.
- Una modalità ibrida li usa entrambi su gamme di frequenza diverse.
Opus lavora a bitrate da 6 a 510 kbit/s, contro i 256 kbit/s del parlato non compresso a 16 kHz.
Dimensione, qualità e ritardo tirano in direzioni opposte
Per l'audio in diretta, la compressione è un equilibrio tra tre cose:
| Se scegli | Guadagni | Paghi |
|---|---|---|
| Bitrate più basso | Meno dati, funziona su reti deboli | Dettagli persi, soprattutto le consonanti |
| Frame più lunghi (fino a 60 ms in Opus) | Meno overhead al secondo | Più ritardo; un pacchetto perso fa perdere più parlato |
| Frame più corti (fino a 2,5 ms) | Ritardo minore | Più overhead al secondo |
Una telefonata ha bisogno soprattutto di un ritardo basso. Una dettatura riconosciuta dopo che hai finito di parlare tiene di più a conservare i dettagli che servono al riconoscimento, perché decidono se «sedici» diventa «sei».
Cosa significa per la dettatura
La compressione è una scelta di trasporto, non parte del riconoscimento. Un riconoscitore può ricevere PCM non compresso, un flusso compresso o un altro formato supportato, e nessuna app di dettatura è obbligata a usare un codec in particolare. Cosa conta per te:
- Una compressione moderata va bene. I modelli vocali moderni gestiscono senza problemi un audio ben codificato.
- Una compressione aggressiva costa precisione. Bitrate molto bassi sfocano proprio i suoni deboli che distinguono parole simili.
- Anche le cuffie Bluetooth comprimono. Molte passano a una modalità ristretta a basso bitrate quando il microfono è in uso, e spesso è una perdita maggiore di qualsiasi cosa faccia l'app.
Domande frequenti
La compressione rende la dettatura meno precisa?
Una compressione leggera conta pochissimo. Una compressione molto forte, o delle cuffie Bluetooth nella modalità chiamata di bassa qualità, possono togliere dettagli e rendere più difficile distinguere parole simili.
Compressione e cifratura sono la stessa cosa?
No. La compressione rende i dati più piccoli; la cifratura li rende illeggibili a chi non ha la chiave. Una registrazione può essere compressa, cifrata, entrambe le cose o nessuna. Della cifratura si parla in privacy nella dettatura vocale.
Leggi anche
 Come funziona la dettatura vocale
Dall'onda sonora all'audio digitale: cosa registra il tuo microfono quando detti
Come microfono e dispositivo trasformano la voce in numeri: frequenza di campionamento, profondità di bit, audio mono, ricampionamento e perché la posizione del microfono conta più delle specifiche.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Come il riconoscimento vocale trasforma il suono in parole
Perché il parlato è difficile per un computer, come funzionavano i riconoscitori classici con modelli acustici, di pronuncia e linguistici, cosa hanno cambiato i modelli end-to-end (CTC, encoder-decoder, transducer) e perché il testo in streaming può cambiare mentre parli.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Riconoscimento vocale e sintesi vocale: qual è la differenza
Il riconoscimento vocale trasforma la voce in testo, la sintesi vocale il testo in voce. Come funziona ciascuno, dove si incontrano (numeri, date, nomi), in cosa i codec vocali sono diversi da entrambi e perché un'app di dettatura non legge il testo ad alta voce.
MacWindowsiPhoneAndroid