
Wie Spracherkennung aus Ton Wörter macht
Warum Sprache für Computer schwer ist, wie klassische Erkenner mit akustischem Modell, Aussprachewörterbuch und Sprachmodell arbeiteten, was End-to-End-Modelle (CTC, Encoder-Decoder, Transducer) geändert haben und warum sich Text beim Streaming noch ändert.
Kurz gesagt
Sprache hat keine klaren Pausen zwischen Wörtern, und jeder spricht anders, deshalb „liest“ ein Erkenner Wörter nie einfach vom Audio ab. Er schätzt die wahrscheinlichste Wortfolge aus dem Ton und aus Mustern, die er im Training gelernt hat. Ältere Systeme nutzten getrennte Modelle für Akustik, Aussprache und Sprache; die meisten modernen lernen den ganzen Weg vom Audio zum Text in einem Netz.
Du sagst
wir treffen uns am mittwoch um acht vor dem kino
SayVelio schrieb
Wir treffen uns am Mittwoch um 8 vor dem Kino.
Warum Spracherkennung schwer ist
Geschriebener Text hat Leerzeichen zwischen den Wörtern. Gesprochene Sprache nicht. Laute fließen ineinander: „Mehrwert“ und „mehr wert“ klingen gleich, „Stiefel“ und „Stiel“ beginnen fast identisch. Laute verändern sich je nach Nachbarn, Menschen sprechen in unterschiedlichem Tempo und unterschiedlicher Tonhöhe, und jeder Akzent färbt die Vokale.
Derselbe Audioabschnitt kann also zu mehreren Wortfolgen passen. Ein Erkenner entschlüsselt Wörter nicht mit Gewissheit: Er wägt die Möglichkeiten ab und nimmt die wahrscheinlichste. Deshalb kann ein Ergebnis gut lesbar und trotzdem falsch sein.
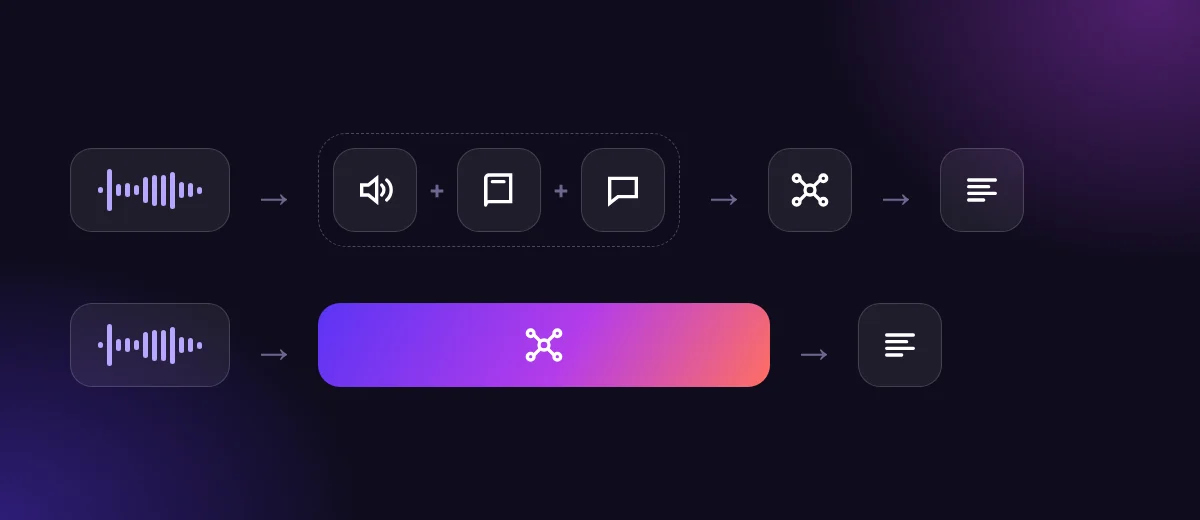
Der klassische Ansatz: drei Modelle und ein Decoder
Jahrzehntelang bestand Spracherkennung aus getrennten Teilen:
- Ein akustisches Modell verband kurze Audioabschnitte mit Sprachlauten (Phonemen).
- Ein Aussprachewörterbuch hielt fest, wie jedes Wort als Folge dieser Laute klingen kann.
- Ein Sprachmodell bewertete, wie wahrscheinlich eine Wortfolge in der Sprache ist („Mehrwert schaffen“ ist weit wahrscheinlicher als „mehr wert schaffen“).
- Ein Decoder durchsuchte die Kombinationen nach dem besten Gesamttreffer.
Dieser Aufbau erklärt das Problem bis heute am anschaulichsten, und manche Systeme nutzen Teile davon. Aber so funktionieren die meisten modernen Erkenner nicht.
End-to-End-Modelle: ein Netz vom Audio zum Text
Moderne Systeme lernen die direkte Zuordnung von Audio zu Text in einem einzigen neuronalen Netz, trainiert mit riesigen Mengen transkribierter Sprache. Es gibt drei verbreitete Familien:
- CTC (Connectionist Temporal Classification) sagt für jeden kurzen Audio-Frame ein Zeichen oder Wortstück voraus, inklusive eines speziellen „leeren“ Symbols, fasst dann Wiederholungen zusammen und entfernt die leeren Symbole. Niemand muss dafür in den Trainingsaufnahmen markieren, wo jedes Wort beginnt.
- Attention-basierte Encoder-Decoder-Modelle verwandeln erst die ganze Aufnahme in eine interne Darstellung und schreiben dann den Text Stück für Stück, wobei sie für jedes nächste Stück auf die passenden Stellen im Audio „zurückschauen“.
- Transducer (RNN-T und ähnliche) kombinieren einen Audio-Encoder mit einer Komponente, die sich an den bisher geschriebenen Text erinnert. Das macht sie gut geeignet, Text schon während des Sprechens zu liefern.
Echte Produkte mischen diese Ideen, und manche ergänzen weitere Schritte wie Kontexthinweise für seltene Wörter (siehe wie Kontext der Erkennung hilft). Einer Diktier-App sieht man nicht an, welche Architektur dahintersteckt, und das musst du auch nicht wissen: Für dich zählen Genauigkeit, Tempo und was mit deinen Daten passiert.
Ganze Aufnahme oder Streaming
Die Erkennung kann auf der fertigen Aufnahme laufen, nachdem du aufgehört hast, oder fortlaufend, während du sprichst:
- Streaming zeigt Wörter fast sofort, aber frühe Vermutungen können sich ändern, wenn spätere Wörter Kontext liefern. „Mehrwert“ erscheint vielleicht kurz als „mehr wert“ und korrigiert sich dann.
- Erkennung der ganzen Aufnahme wartet, bis du fertig bist, sieht dafür aber den ganzen Satz auf einmal, was Genauigkeit und Zeichensetzung oft hilft.
Die Verzögerung, die du bemerkst, umfasst auch das Erkennen deines Sprechendes, die Netzwerkzeit und eine eventuelle Bereinigung. In SayVelio hältst du beim Sprechen die Taste, deshalb ist das Ende der Aufnahme exakt, und der Text wird eingefügt, wenn er fertig ist, nicht Wort für Wort.
Warum das Ergebnis eine Wahrscheinlichkeit ist, keine Tatsache
Weil das System immer die wahrscheinlichste Option wählt, sehen seine Fehler plausibel aus: ein echtes, richtig geschriebenes Wort, das du nicht gesagt hast. Namen, Zahlen und seltene Begriffe sind am stärksten gefährdet, weil das Modell sie seltener gesehen hat. Zwei praktische Gegenmittel:
- Bring dem System deine Wörter mit einem eigenen Wörterbuch bei.
- Lies wichtige Texte vor dem Senden, besonders Beträge, Daten und „nicht“.
Häufige Fragen
Versteht Spracherkennung, was ich meine?
Nicht im menschlichen Sinn. Sie schätzt, welche Wörter gesagt wurden. Bedeutung fließt nur über Muster ein, die aus Texten gelernt wurden, und hilft bei der Wahl zwischen ähnlich klingenden Wendungen.
Warum liegt mein Diktat bei einem Wort jedes Mal daneben?
Meist, weil das Wort selten ist oder wie ein häufigeres klingt. Nimm es ins Wörterbuch auf, mit seiner Aussprache als Variante, dann sind die meisten dieser Fälle gelöst.
Weiterlesen
 So funktioniert Spracheingabe
Wie Spracherkennung lernt und warum Kontext bei Namen und Fachbegriffen hilft
Training und Alltagseinsatz, warum Modelle mit unbekannten Namen und Akzenten kämpfen, wie Kontexthinweise und Wörterbücher die Erkennung lenken und warum Diktieren nicht heißt, dass deine Stimme das Modell trainiert.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Vom Roh-Transkript zum lesbaren Text: Satzzeichen, Zahlen und Bereinigung
Warum ein rohes Sprach-Transkript nicht versandfertig ist, wie Satzzeichen, Großschreibung, Zahlen und Listen dazukommen, warum „fünf fünfzig“ mehrdeutig ist und wie die Bereinigung deinen Sinn nicht verändert.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Wie genau ist Spracheingabe? Wortfehlerrate, Tempo und echte Grenzen
Wie die Genauigkeit von Spracherkennung gemessen wird (Wortfehlerrate), was Studien zum Tempo von Diktieren und Tippen sagen, was Ergebnisse verschlechtert und welche Wörter du immer prüfen solltest.
MacWindowsiPhoneAndroid