
Formatos y compresión de audio en el dictado por voz
El audio digital, la codificación y la compresión son tres cosas distintas. Cómo funciona la compresión con y sin pérdida, por qué ningún algoritmo puede reducir cualquier archivo, cómo los códecs de voz como Opus equilibran tamaño y retardo, y qué significa para el dictado.
En resumen
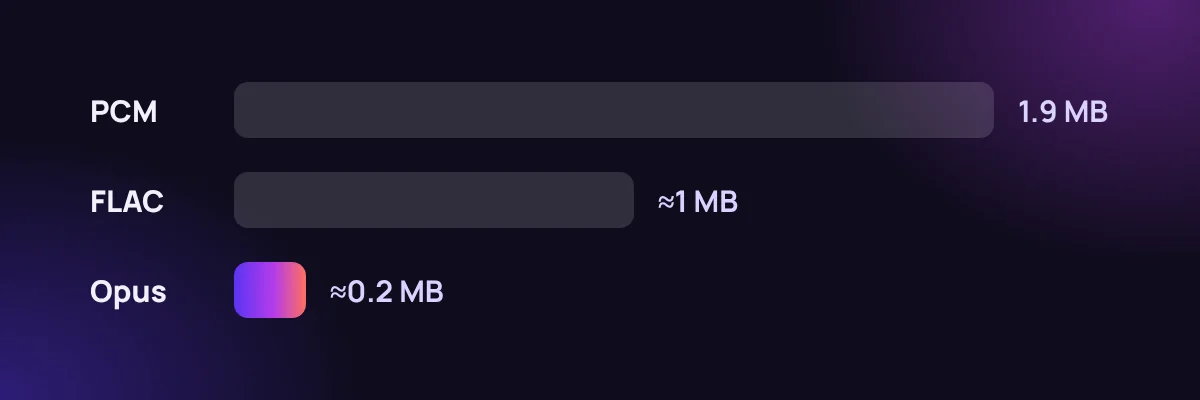
El audio de voz sin comprimir ocupa unos 32 KB por segundo. La compresión lo reduce: sin pérdida se conserva cada bit; con pérdida se descartan detalles que la gente difícilmente oiría. Los códecs de voz como Opus son muy eficientes, pero apretar demasiado puede quitar sonidos que el reconocedor necesita. La compresión trata de mover el audio, no de entender palabras.
Dijiste
la grabación pesa demasiado para enviarla por correo así que te paso un enlace
SayVelio escribió
La grabación pesa demasiado para enviarla por correo, así que te paso un enlace.
Tres palabras que se confunden a menudo
- El audio digital es sonido representado con números: muestras tomadas muchas veces por segundo (ver cómo graba la voz el micrófono).
- Codificar es escribir esa información en un formato concreto, con reglas acordadas para leerla de nuevo.
- Comprimir es codificar usando menos bits que la representación simple.
El audio sin comprimir, normalmente llamado PCM, guarda cada muestra directamente. Un archivo WAV suele ser PCM con una pequeña cabecera. Los formatos comprimidos describen el mismo sonido con menos datos siguiendo sus propias reglas.
Sin pérdida y con pérdida
La compresión sin pérdida, como la de FLAC, permite reconstruir exactamente las muestras originales. Funciona aprovechando la estructura: las muestras vecinas de la voz se parecen, así que sale más barato guardar una predicción y una pequeña corrección que cada muestra completa. Con audio el ahorro suele ser modesto, a menudo cerca de la mitad.
La compresión con pérdida, como la de MP3, AAC u Opus, descarta a propósito información que el oyente difícilmente notará y conserva el resto. El ahorro es mucho mayor, a menudo de diez veces o más, pero el original no se puede recuperar.
Por qué no se puede comprimir todo
Hay un límite matemático: ningún método sin pérdida puede reducir todos los archivos posibles. Si pudiera, podrías comprimir el resultado una y otra vez hasta que cada archivo ocupara un bit, y entonces dos archivos distintos tendrían que compartir la misma forma comprimida. La compresión solo funciona cuando los datos tienen patrones. Los datos que parecen aleatorios, o que ya están comprimidos, apenas se reducen. Por eso comprimir un MP3 en un ZIP casi no sirve de nada.
Códecs de voz: hechos para la voz
La voz tiene una estructura que la compresión general no conoce: el tracto vocal da forma al sonido de manera predecible. Los códecs de voz lo aprovechan. Opus, el códec abierto estandarizado por el IETF en 2012 y usado en muchas apps de llamadas y navegadores, combina dos enfoques:
- SILK, basado en predicción lineal, modela cómo el tracto vocal da forma al sonido. Muy eficiente con la voz.
- CELT, basado en una transformada de frecuencia (MDCT), maneja bien la música y el sonido de banda ancha.
- Un modo híbrido usa ambos para distintos rangos de frecuencia.
Opus trabaja con tasas de 6 a 510 kbit/s, frente a los 256 kbit/s de la voz en bruto a 16 kHz.
Tamaño, calidad y retardo tiran en direcciones opuestas
En audio en directo, comprimir es equilibrar tres cosas:
| Si eliges | Ganas | Pagas |
|---|---|---|
| Menos bitrate | Menos datos, funciona en redes débiles | Se pierde detalle, sobre todo en consonantes |
| Tramas más largas (hasta 60 ms en Opus) | Menos sobrecarga por segundo | Más retardo; un paquete perdido se lleva más voz |
| Tramas más cortas (desde 2,5 ms) | Menos retardo | Más sobrecarga por segundo |
Una llamada necesita sobre todo poco retardo. Un dictado que se reconoce después de que termines de hablar necesita más conservar los detalles que usa el reconocedor, porque de ellos depende que «quince» no salga como «cincuenta».
Qué significa para el dictado
La compresión es una decisión de transporte, no parte del reconocimiento. Un reconocedor puede recibir PCM sin comprimir, un flujo comprimido u otro formato compatible, y ninguna app de dictado está obligada a usar un códec concreto. Lo que te importa:
- Una compresión moderada está bien. Los modelos de voz actuales manejan sin problemas un audio bien codificado.
- Una compresión agresiva cuesta precisión. Las tasas muy bajas difuminan justo los sonidos suaves que separan palabras parecidas.
- Los auriculares Bluetooth también comprimen. Muchos pasan a un modo estrecho de baja calidad mientras usan el micrófono, lo que suele costar más que cualquier cosa que haga la app.
Preguntas frecuentes
¿La compresión hace el dictado menos preciso?
Una compresión ligera apenas influye. Una muy fuerte, o unos auriculares Bluetooth en su modo de llamada de baja calidad, pueden quitar detalles y hacer más difícil distinguir palabras parecidas.
¿Comprimir es lo mismo que cifrar?
No. Comprimir hace los datos más pequeños; cifrar los hace ilegibles para quien no tenga la clave. Una grabación puede estar comprimida, cifrada, ambas cosas o ninguna. El cifrado se explica en privacidad en el dictado por voz.
Lecturas relacionadas
 Cómo funciona el dictado por voz
De la onda sonora al audio digital: qué graba tu micrófono al dictar
Cómo el micrófono y tu dispositivo convierten la voz en números: frecuencia de muestreo, profundidad de bits, audio mono, remuestreo y por qué la posición del micrófono importa más que las especificaciones.
MacWindowsiPhoneAndroid Cómo funciona el dictado por voz
Cómo el reconocimiento de voz convierte el sonido en palabras
Por qué el habla es difícil para un ordenador, cómo funcionaban los reconocedores clásicos con modelos acústico, de pronunciación y de lenguaje, qué cambiaron los modelos de extremo a extremo (CTC, codificador-decodificador, transductores) y por qué el texto en streaming cambia mientras hablas.
MacWindowsiPhoneAndroid Cómo funciona el dictado por voz
Reconocimiento de voz y texto a voz: en qué se diferencian
El reconocimiento de voz convierte la voz en texto; la síntesis, el texto en voz. Cómo funciona cada uno, dónde se cruzan (números, fechas, nombres), en qué se distinguen de ambos los códecs de voz y por qué una app de dictado no lee el texto en voz alta.
MacWindowsiPhoneAndroid