
Como o reconhecimento de fala transforma som em palavras
Por que a fala é difícil para o computador, como funcionavam os reconhecedores clássicos com modelos acústico, de pronúncia e de linguagem, o que os modelos ponta a ponta (CTC, encoder-decoder, transducers) mudaram e por que o texto em streaming pode mudar enquanto você fala.
Resumindo
Na fala não há pausas claras entre as palavras, e cada pessoa pronuncia de um jeito, então um reconhecedor nunca «lê» palavras no áudio. Ele estima a sequência de palavras mais provável a partir do som e dos padrões aprendidos no treinamento. Sistemas mais antigos usavam modelos separados para acústica, pronúncia e língua; a maioria dos modernos aprende o caminho inteiro do áudio ao texto numa única rede.
Você disse
a gente se vê no concerto e depois no conserto do carro
O SayVelio escreveu
A gente se vê no concerto e depois no conserto do carro.
Por que reconhecer a fala é difícil
O texto escrito tem espaços entre as palavras. A fala não. Quando você diz «a gente», os sons se juntam, e «agente» soa praticamente igual. Os sons também mudam conforme os vizinhos, as pessoas falam em velocidades e alturas diferentes, e os sotaques moldam cada vogal.
Assim, o mesmo trecho de áudio pode combinar com várias sequências de palavras. Um reconhecedor não decodifica palavras com certeza: ele pesa as opções e escolhe a mais provável. Por isso um resultado pode ficar ótimo de ler e mesmo assim estar errado.
A abordagem clássica: três modelos e um decodificador
Por décadas, o reconhecimento de fala foi construído com partes separadas:
- Um modelo acústico ligava trechos curtos de áudio aos sons da fala (fonemas).
- Um dicionário de pronúncia listava como cada palavra pode ser pronunciada como sequência desses sons.
- Um modelo de linguagem avaliava a probabilidade de uma sequência de palavras na língua («levei o carro ao conserto» é muito mais provável que «levei o carro ao concerto»).
- Um decodificador buscava entre as combinações a que melhor se encaixava no geral.
Esse desenho continua sendo a forma mais clara de entender o problema, e alguns sistemas ainda usam partes dele. Mas não é assim que funciona a maioria dos reconhecedores modernos.
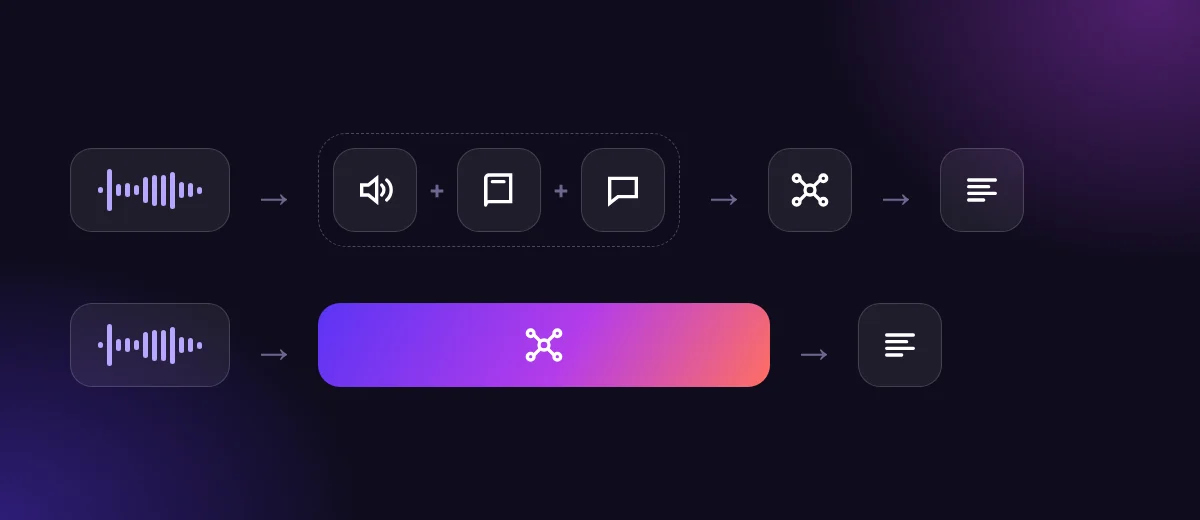
Modelos ponta a ponta: uma rede do áudio ao texto
Os sistemas modernos aprendem um mapeamento direto do áudio para o texto numa única rede neural, treinada com quantidades enormes de fala transcrita. Há três famílias comuns:
- CTC (connectionist temporal classification) prevê um caractere ou pedaço de palavra para cada trecho curto de áudio, incluindo um símbolo especial «vazio», e depois junta as repetições e remove os vazios. Ninguém precisa marcar onde cada palavra começa no áudio de treinamento.
- Modelos encoder-decoder com atenção primeiro transformam a gravação inteira numa representação interna e depois escrevem o texto pedaço por pedaço, «olhando de volta» para as partes relevantes do áudio a cada novo pedaço.
- Transducers (RNN-T e parecidos) combinam um codificador de áudio com um componente que lembra o texto já produzido, o que os deixa bem adaptados para escrever enquanto você ainda está falando.
Os produtos reais misturam essas ideias, e alguns acrescentam etapas como dicas de contexto para palavras raras (veja como o contexto ajuda o reconhecimento). Um app de ditado não conta qual arquitetura usa, e nem precisa: o que importa para você é precisão, velocidade e o que acontece com seus dados.
Gravação inteira ou streaming
O reconhecimento pode rodar sobre a gravação completa depois que você para, ou continuamente enquanto você fala:
- O streaming mostra as palavras quase na hora, mas os primeiros palpites podem mudar quando as palavras seguintes trazem contexto. «Concerto do carro» pode aparecer por um instante e depois virar «conserto do carro».
- O reconhecimento da gravação inteira espera você terminar, mas vê a frase toda de uma vez, o que muitas vezes ajuda na precisão e na pontuação.
A demora que você percebe inclui ainda o tempo para notar que você parou, a rede e a eventual limpeza. No SayVelio você segura a tecla enquanto fala, então o fim da gravação é exato, e o texto é inserido quando está pronto, não palavra por palavra.
Por que o resultado é uma probabilidade, não um fato
Como o sistema sempre escolhe a opção mais provável, seus erros parecem plausíveis: uma palavra real, escrita certinho, que você não disse. Nomes, números e termos raros correm mais risco, porque o modelo os viu menos vezes. Duas defesas práticas:
- Ensine suas palavras ao sistema com um dicionário pessoal.
- Leia os textos importantes antes de enviar, principalmente valores, datas e «não».
Perguntas
O reconhecimento de fala entende o que eu quero dizer?
Não no sentido humano. Ele estima quais palavras foram ditas. O significado entra só por meio de padrões aprendidos em textos, que o ajudam a escolher entre frases de som parecido.
Por que o ditado erra sempre a mesma palavra?
Geralmente porque a palavra é rara ou soa como uma mais comum. Colocá-la no dicionário, com o jeito como ela soa como variante, resolve a maioria desses casos.
Leia também
 Como funciona a digitação por voz
Como o reconhecimento de fala aprende e por que o contexto ajuda com nomes e jargão
Treinamento e uso no dia a dia, por que os modelos têm dificuldade com nomes pouco conhecidos e sotaques, como dicas de contexto e dicionários orientam o reconhecimento e por que ditar não significa treinar o modelo com a sua voz.
MacWindowsiPhoneAndroid Como funciona a digitação por voz
Da transcrição bruta ao texto legível: pontuação, números e limpeza
Por que uma transcrição bruta não está pronta para enviar, como entram pontuação, maiúsculas, números e listas, por que «cinco e cinquenta» é ambíguo e como evitar que a limpeza mude o que você quis dizer.
MacWindowsiPhoneAndroid Como funciona a digitação por voz
Qual é a precisão da digitação por voz? Taxa de erro, velocidade e limites reais
Como se mede a precisão do reconhecimento de fala (taxa de erro de palavras), o que os estudos dizem sobre a velocidade do ditado em comparação com a digitação, o que piora os resultados e quais palavras conferir sempre.
MacWindowsiPhoneAndroid