
Reconhecimento de fala e síntese de voz: qual é a diferença
O reconhecimento de fala transforma voz em texto; a síntese de voz transforma texto em voz. Como cada um funciona, onde se encontram (números, datas, nomes), em que os codecs de voz diferem dos dois e por que um app de ditado não lê o texto em voz alta.
Resumindo
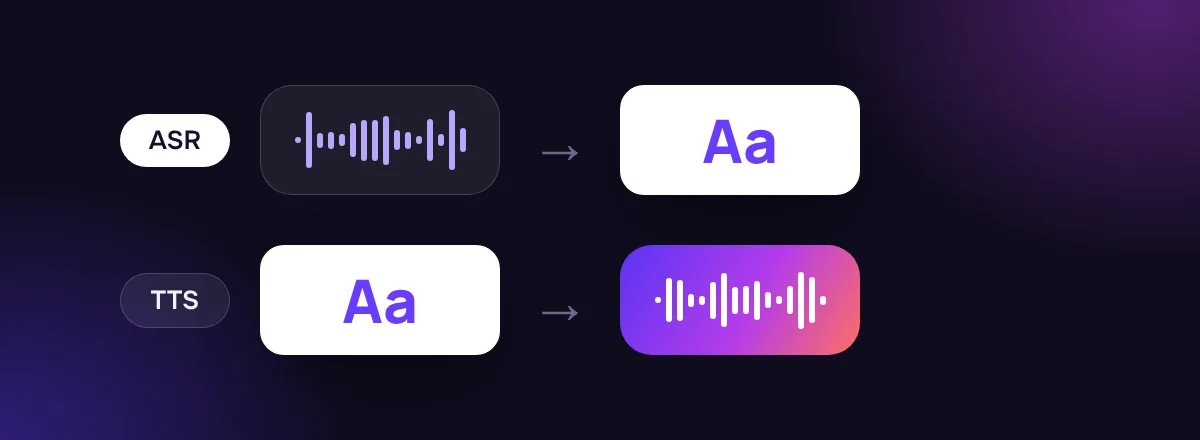
O reconhecimento de fala (ASR) escuta e escreve: som na entrada, texto na saída. A síntese de voz (TTS) lê e fala: texto na entrada, som na saída. Muitas vezes aparecem juntos nos assistentes de voz, mas são tecnologias distintas, com treinamento, resultado e medidas de qualidade diferentes. Uma terceira tecnologia, o codec de voz, apenas reduz o som para transmiti-lo e não faz nem uma coisa nem outra.
Você disse
a reunião passou para o dia doze às quinze e trinta
O SayVelio escreveu
A reunião passou para o dia 12 às 15h30.
Dois sentidos opostos
| Reconhecimento de fala (ASR) | Síntese de voz (TTS) | Codec de voz | |
|---|---|---|---|
| Entrada | O som de uma pessoa falando | Texto escrito | Som |
| Saída | Texto | Uma voz sintética | O mesmo som, mais leve |
| Pergunta central | Quais palavras foram ditas? | Como este texto deve soar? | Como transmitir este som com eficiência? |
| Uso típico | Ditado, legendas, busca por voz | Leitores de tela, GPS, audiolivros | Ligações, mensagens de voz |
| Qualidade medida por | Taxa de erro de palavras | Notas de naturalidade e inteligibilidade | Testes de audição a uma dada taxa de bits |
Um assistente de voz usa os dois: o reconhecimento para entender sua pergunta, a síntese para responder em voz alta. Mas um não implica o outro. O SayVelio é um app de ditado: reconhece a fala e escreve texto, e não lê nada em voz alta.
Como funciona a síntese de voz
Um sistema TTS típico trabalha em etapas:
- Análise do texto. Expandir abreviações e números em palavras («Dr.» se lê «doutor» ou «doutora»?) e escolher a pronúncia certa de palavras que se escrevem igual mas se falam diferente («o almoço» e «eu almoço»).
- Prosódia. Decidir ritmo, pausas, ênfase e entonação, para que uma pergunta soe como pergunta.
- Modelo acústico. Prever como a voz deve soar ao longo do tempo, muitas vezes na forma de espectrograma.
- Vocoder. Transformar essa previsão numa forma de onda real que dá para ouvir.
Um exemplo conhecido é o Tacotron 2, do Google (2018), que prevê um espectrograma mel a partir do texto e usa um vocoder neural para produzir o som. Muitos sistemas mais novos juntam ou reorganizam essas etapas, mas o papel de cada uma continua.
Os desenvolvedores podem controlar a síntese com SSML (Speech Synthesis Markup Language), um padrão do W3C para marcar pausas, ênfase, pronúncia e a leitura de datas e outros elementos. O suporte a cada recurso do SSML varia entre os motores.
Onde se encontram: números, datas e nomes
Os dois sentidos tropeçam nas mesmas coisas, cada um do seu lado:
- O ditado precisa transformar «doze e cinquenta» falado em escrito: 12h50? 1250? R$ 12,50? É a normalização inversa de texto, descrita em da transcrição ao texto.
- A síntese precisa transformar «12/05» escrito em fala: doze de maio ou cinco de dezembro? É a normalização de texto.
As duas estão ligadas sem ser espelhos exatos, porque nos dois sentidos a resposta certa depende do contexto. Os nomes são difíceis nas duas direções: um sistema de reconhecimento precisa saber como se escreve um nome que ouve (é o papel do dicionário), e um sintetizador, como se pronuncia um nome que lê.
Os codecs são uma terceira coisa, à parte
Um codec de voz como o Opus representa com menos bits um som que já existe, para transmiti-lo ou armazená-lo. Ele não cria fala a partir de texto e não decide quais palavras foram ditas. Um produto que transcreve fala não precisa sintetizar voz nem usar um codec específico. Mais detalhes em compressão de áudio para fala.
Os dois usam aprendizado de máquina, de formas diferentes
ASR e TTS modernos se baseiam em redes neurais e ambos aprendem com pares de som e texto. Mas os objetivos são opostos: o ASR é julgado pela exatidão das palavras, o TTS pela naturalidade e clareza da voz para quem ouve. Um modelo excelente numa área não sabe fazer a outra automaticamente.
Perguntas
O SayVelio pode ler meu texto para mim?
Não. O SayVelio serve para escrever com a voz. Para ouvir um texto, use o recurso do próprio sistema: Conteúdo Falado no Mac e no iPhone, Narrador no Windows, Selecionar para ouvir no Android.
«Voz para texto» e «reconhecimento de voz» são a mesma coisa?
Muitas vezes são usados como sinônimos, mas, a rigor, reconhecimento de voz também pode significar identificar quem está falando. O SayVelio reconhece o que você diz, não quem você é.
Leia também
 Como funciona a digitação por voz
Como o reconhecimento de fala transforma som em palavras
Por que a fala é difícil para o computador, como funcionavam os reconhecedores clássicos com modelos acústico, de pronúncia e de linguagem, o que os modelos ponta a ponta (CTC, encoder-decoder, transducers) mudaram e por que o texto em streaming pode mudar enquanto você fala.
MacWindowsiPhoneAndroid Como funciona a digitação por voz
Da transcrição bruta ao texto legível: pontuação, números e limpeza
Por que uma transcrição bruta não está pronta para enviar, como entram pontuação, maiúsculas, números e listas, por que «cinco e cinquenta» é ambíguo e como evitar que a limpeza mude o que você quis dizer.
MacWindowsiPhoneAndroid Como funciona a digitação por voz
Formatos de áudio e compressão na digitação por voz
Áudio digital, codificação e compressão são três coisas diferentes. Como funcionam a compressão sem perdas e com perdas, por que nenhum algoritmo reduz todo arquivo, como codecs de voz como o Opus equilibram tamanho e atraso e o que isso significa para o ditado.
MacWindowsiPhoneAndroid