
Die Stimme für die Erkennung vorbereiten: Rauschunterdrückung, Echounterdrückung und Sprachaktivitätserkennung
Was mit dem Audio vor der Spracherkennung passiert: automatische Pegelregelung, Rauschunterdrückung, Echounterdrückung, Sprachaktivitätserkennung und Spektrogramme, und warum „sauberer“ nicht immer besser ist.
Kurz gesagt
Vor der Erkennung kann Audio ausgepegelt, von Echo und Rauschen befreit und in die Abschnitte mit Sprache zerlegt werden. Jeder dieser Schritte hat eine enge Aufgabe, keiner versteht Wörter, und keiner ist Pflicht. Starke Rauschunterdrückung kann sogar schaden, weil sie leise Konsonanten löscht, an denen man Wörter unterscheidet.
Du sagst
hallo tom die rechnung ist im anhang sag bescheid ob die zahlen stimmen
SayVelio schrieb
Hallo Tom,
die Rechnung ist im Anhang. Sag Bescheid, ob die Zahlen stimmen.
Signalverarbeitung ist keine Spracherkennung
Signalverarbeitung arbeitet mit Ton, nicht mit Sprache im Sinne von Wörtern. Sie kann Sprache lauter, leiser oder klarer machen oder entscheiden, wo sie anfängt und aufhört, aber sie entscheidet nie, welche Wörter du gesagt hast. Das ist Aufgabe des Erkennungsmodells, beschrieben in wie Spracherkennung funktioniert.
Welche Schritte eine App nutzt, hängt von der Situation ab. Ein Anruf braucht Echounterdrückung, weil die Stimme des Gegenübers aus deinem Lautsprecher kommt. Eine Diktier-App, bei der nichts abgespielt wird, braucht sie womöglich gar nicht.
Vier Werkzeuge, vier Aufgaben
| Werkzeug | Was es tut | Was es nicht kann |
|---|---|---|
| Automatische Pegelregelung | Hebt oder senkt den Aufnahmepegel | Eine Stimme retten, die nie klar aufgenommen wurde |
| Rauschunterdrückung | Dämpft gleichmäßige Geräusche wie Lüfter oder Verkehr | Zwei gleichzeitig Sprechende trennen |
| Echounterdrückung | Entfernt den Ton deines Lautsprechers, der zurück ins Mikrofon gelangt | Helfen, wenn nichts abgespielt wird |
| Sprachaktivitätserkennung | Schätzt, in welchen Momenten gesprochen wird | Erkennen, was gesagt wurde |
Echounterdrückung ist das gezielteste davon. Sie weiß genau, was dein Gerät abspielt, weil sie eine Referenzkopie dieses Tons erhält, und zieht den Teil ab, den das Mikrofon wieder auffängt. Rauschunterdrückung muss dagegen raten, was Rauschen ist.
Sprachaktivitätserkennung: die Sprache finden
Eine Sprachaktivitätserkennung (VAD) betrachtet kurze Audioabschnitte, oft 10 bis 30 Millisekunden, und schätzt, wie wahrscheinlich in jedem Sprache steckt. Die einfachste Variante prüft nur die Lautstärke, aber eine zuknallende Tür überschreitet die Schwelle, und eine leise Stimme kann darunter bleiben. Bessere Detektoren schätzen pro Abschnitt eine Sprachwahrscheinlichkeit, verbinden benachbarte Sprachbereiche und verwerfen solche, die zu kurz für Wörter sind.
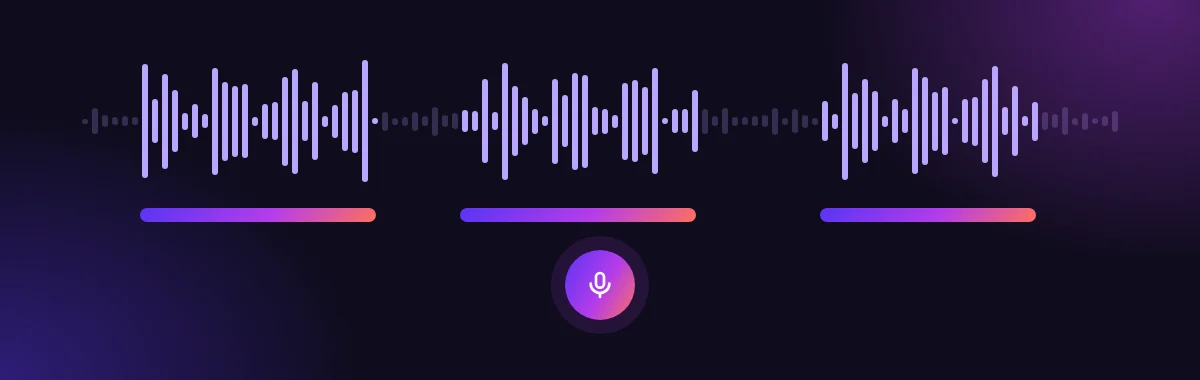
Die Erkennung hilft, Stille zu überspringen und zu merken, dass ein Satz zu Ende ist. Bei Halten-und-Sprechen, wie in SayVelio, bestimmst du Anfang und Ende der Aufnahme selbst: Sie läuft genau so lange, wie du die Diktiertaste hältst.
Warum sauberer nicht immer besser ist
Es ist verlockend zu glauben, mehr Rauschentfernung helfe immer. Tut sie nicht. Konsonanten wie „s“, „f“, „t“ und „k“ sind leise, rauschähnliche Laute, und aggressive Rauschunterdrückung kann sie mit dem Hintergrund ausdünnen. Für Menschen klingt das Audio sauberer, aber die Erkennung hat die Hinweise verloren, die „fünfzehn“ von „fünfzig“ unterscheiden.
Moderne Erkennungsmodelle sind mit viel echter, verrauschter Sprache trainiert und kommen oft besser mit dem Originalton klar als mit stark bearbeitetem Audio. Gute Verarbeitung ist behutsam und wird an echten Diktaten getestet, nicht nur nach Gehör beurteilt.
Spektrogramme: wie Maschinen Ton sehen
Viele Erkenner nutzen nicht direkt die Wellenform. Sie schieben ein kurzes Fenster (meist 20 bis 30 ms) über das Audio und messen, welche Frequenzen in jedem Fenster stecken. Das Ergebnis ist ein Spektrogramm: ein Bild mit der Zeit nach rechts, der Tonhöhe nach oben und der Helligkeit als Energie.
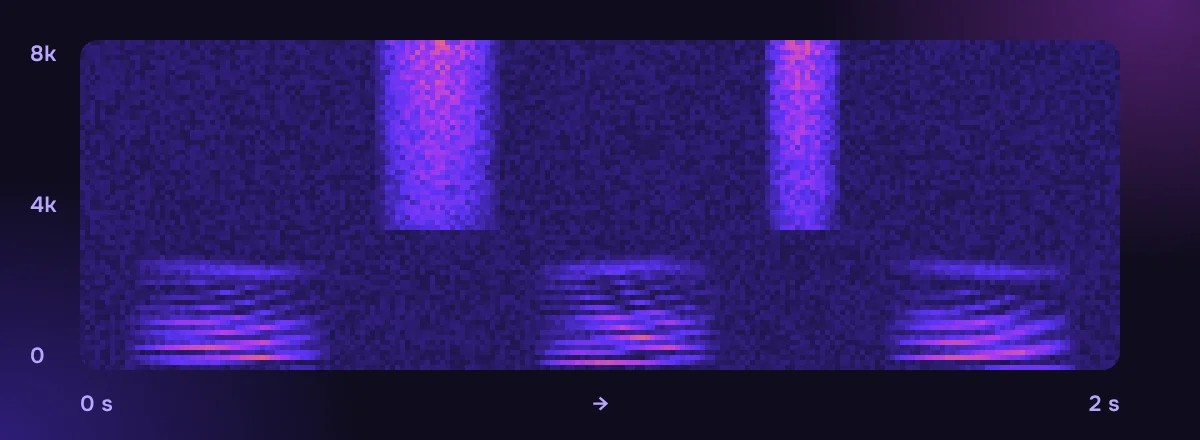
Ein Spektrogramm ist kein Transkript. Es zeigt Klangmuster, die ein Modell mit Sprachlauten zu verbinden lernt. Die Fenstergröße ist ein Kompromiss: Kurze Fenster zeigen das Timing genau, lange die Tonhöhe. Manche neuere Modelle überspringen diesen Schritt und lernen direkt aus den Abtastwerten.
Was du tun kannst
- Diktiere am ruhigsten Ort, den du hast. Auch gute Verarbeitung entfernt keine Kollegin, die neben dir spricht: Ihre Stimme ist auch Sprache.
- Dreh Musik und Videos leiser, während du diktierst.
- Halte einen gleichmäßigen Abstand zum Mikrofon, damit der Pegel stabil bleibt. Mehr Tipps im Leitfaden gut diktieren.
Häufige Fragen
Liefert bessere Audioqualität immer besseren Text?
Nicht immer. Am meisten hilft klare Sprache mit gutem Pegel. Starke Rauschentfernung, Verzerrung oder ein falsches Audioformat können Details entfernen, die die Erkennung braucht, und Training, Sprache und Wortschatz des Modells zählen ebenfalls.
Kann man in einem lauten Café diktieren?
Oft ja, besonders mit einem Headset-Mikrofon nah am Mund. Gleichmäßiges Rauschen wie eine Kaffeemaschine ist leichter zu verkraften als andere Stimmen in der Nähe.
Weiterlesen
 So funktioniert Spracheingabe
Von der Schallwelle zum digitalen Audio: was dein Mikrofon beim Diktieren aufnimmt
Wie Mikrofon und Gerät Sprache in Zahlen verwandeln: Abtastrate, Bittiefe, Mono, Resampling und warum die Position des Mikrofons wichtiger ist als technische Daten.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Wie Spracherkennung aus Ton Wörter macht
Warum Sprache für Computer schwer ist, wie klassische Erkenner mit akustischem Modell, Aussprachewörterbuch und Sprachmodell arbeiteten, was End-to-End-Modelle (CTC, Encoder-Decoder, Transducer) geändert haben und warum sich Text beim Streaming noch ändert.
MacWindowsiPhoneAndroid Erste Schritte
Richtig diktieren: 9 Gewohnheiten für sauberen Text beim ersten Mal
So sprichst du, damit die Diktierfunktion dich beim ersten Mal versteht: Taste halten, ganze Gedanken sagen, dich laut korrigieren, Listen diktieren und was tun, wenn ein Wort falsch herauskommt.
MacWindowsiPhoneAndroid