
Preparar la voz para el reconocimiento: supresión de ruido, control de eco y detección de voz
Qué le pasa al audio antes del reconocimiento de voz: control automático de ganancia, supresión de ruido, cancelación de eco, detección de actividad de voz y espectrogramas, y por qué un audio más limpio no siempre es mejor.
En resumen
Antes del reconocimiento, el audio puede nivelarse, limpiarse de eco y ruido y recortarse en las partes que contienen voz. Cada uno de estos pasos tiene una tarea concreta, ninguno entiende palabras y ninguno es obligatorio. Una supresión de ruido fuerte puede incluso perjudicar, porque borra consonantes suaves que distinguen unas palabras de otras.
Dijiste
hola tomás te adjunto la factura avísame si las cifras están bien
SayVelio escribió
Hola, Tomás:
Te adjunto la factura. Avísame si las cifras están bien.
Procesar la señal no es reconocer la voz
El procesamiento de señal trabaja con el sonido, no con el lenguaje. Puede hacer la voz más fuerte, más baja o más clara, o decidir dónde empieza y termina, pero nunca decide qué palabras dijiste. Eso es trabajo del modelo de reconocimiento, descrito en cómo funciona el reconocimiento de voz.
Qué pasos usa una app depende de la situación. Una llamada necesita cancelación de eco porque la voz de la otra persona sale por tu altavoz. Una app de dictado sin nada sonando puede no necesitarla en absoluto.
Cuatro herramientas, cuatro tareas
| Herramienta | Qué hace | Qué no puede hacer |
|---|---|---|
| Control automático de ganancia | Sube o baja el nivel de grabación | Arreglar una voz que nunca se captó con claridad |
| Supresión de ruido | Reduce ruidos constantes como ventiladores o tráfico | Separar a dos personas hablando a la vez |
| Cancelación de eco | Quita el sonido de tu altavoz que vuelve al micrófono | Ayudar cuando no suena nada |
| Detección de actividad de voz | Estima en qué momentos hay voz | Saber qué se dijo |
La cancelación de eco es la más específica. Sabe exactamente qué está reproduciendo tu dispositivo, porque recibe una copia de referencia de ese sonido, y resta la parte que el micrófono vuelve a captar. La supresión de ruido, en cambio, tiene que adivinar qué es ruido.
Detección de actividad de voz: encontrar el habla
Un detector de actividad de voz (VAD) examina fragmentos cortos de audio, a menudo de 10 a 30 milisegundos, y estima la probabilidad de que cada uno contenga voz. La versión más simple solo mira el volumen, pero un portazo supera el umbral y alguien que habla bajito puede quedarse por debajo. Los detectores mejores estiman una probabilidad de voz por fragmento, unen las zonas de voz cercanas y descartan las demasiado cortas para ser palabras.
La detección sirve para saltarse el silencio y saber cuándo has terminado una frase. Con mantener para hablar, como en SayVelio, eres tú quien decide dónde empieza y termina la grabación: dura exactamente lo que mantienes pulsada la tecla de dictado.
Por qué más limpio no siempre es mejor
Es tentador pensar que quitar más ruido siempre ayuda. No es así. Consonantes como la «s», la «f», la «t» y la «k» son sonidos suaves, parecidos al ruido, y una supresión agresiva puede adelgazarlas junto con el fondo. A una persona el audio le suena más limpio, pero el reconocedor ha perdido las pistas que separan «quince» de «cincuenta».
Los modelos actuales se entrenan con muchísima voz real y ruidosa, así que a menudo se las arreglan mejor con el sonido original que con un audio muy procesado. Un buen procesamiento es suave y se prueba con dictados reales, no solo de oído.
Espectrogramas: cómo ve el sonido una máquina
Muchos reconocedores no usan directamente la forma de onda. Deslizan una ventana corta (normalmente de 20 a 30 ms) por el audio y miden qué frecuencias hay en cada ventana. El resultado es un espectrograma: una imagen con el tiempo en horizontal, el tono en vertical y el brillo como energía.
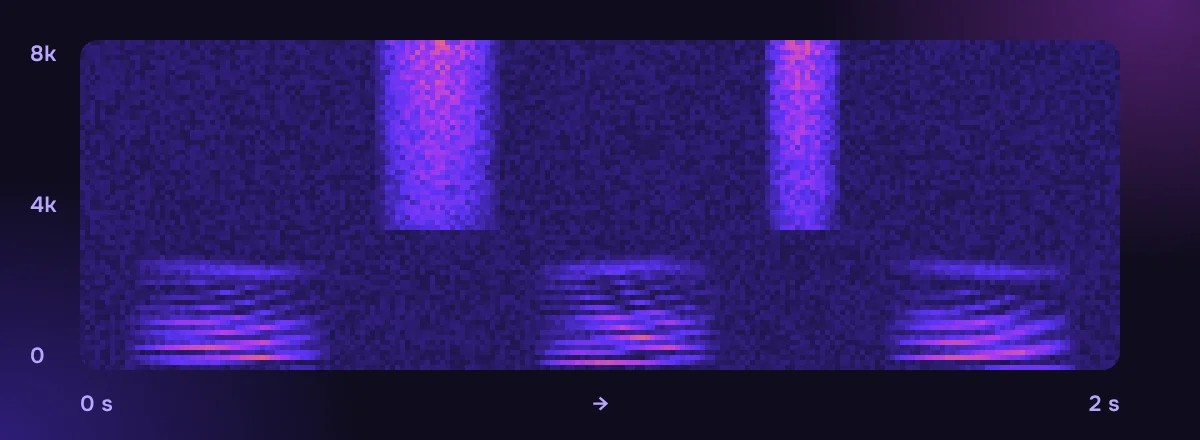
Un espectrograma no es una transcripción. Muestra patrones de sonido que un modelo aprende a asociar con los sonidos del habla. El tamaño de la ventana es un compromiso: las ventanas cortas muestran bien el tiempo y las largas, el tono. Algunos modelos más nuevos se saltan este paso y aprenden directamente de las muestras.
Qué puedes hacer tú
- Dicta en el sitio más tranquilo que tengas. Ni el mejor procesamiento elimina a un compañero hablando a tu lado: su voz también es voz.
- Baja la música y los vídeos mientras dictas.
- Mantén una distancia constante al micrófono, para que el nivel sea estable. Más consejos en cómo dictar bien.
Preguntas frecuentes
¿Mejor calidad de audio siempre da mejor texto?
No siempre. Lo que más ayuda es una voz clara a buen nivel. Una reducción de ruido fuerte, la distorsión o un formato de audio inadecuado pueden quitar detalles que el reconocedor necesita, y también cuentan el entrenamiento, el idioma y el vocabulario del modelo.
¿Se puede dictar en una cafetería ruidosa?
A menudo sí, sobre todo con el micrófono de unos auriculares cerca de la boca. Un ruido constante como el de la cafetera es más fácil de llevar que otras voces cerca.
Lecturas relacionadas
 Cómo funciona el dictado por voz
De la onda sonora al audio digital: qué graba tu micrófono al dictar
Cómo el micrófono y tu dispositivo convierten la voz en números: frecuencia de muestreo, profundidad de bits, audio mono, remuestreo y por qué la posición del micrófono importa más que las especificaciones.
MacWindowsiPhoneAndroid Cómo funciona el dictado por voz
Cómo el reconocimiento de voz convierte el sonido en palabras
Por qué el habla es difícil para un ordenador, cómo funcionaban los reconocedores clásicos con modelos acústico, de pronunciación y de lenguaje, qué cambiaron los modelos de extremo a extremo (CTC, codificador-decodificador, transductores) y por qué el texto en streaming cambia mientras hablas.
MacWindowsiPhoneAndroid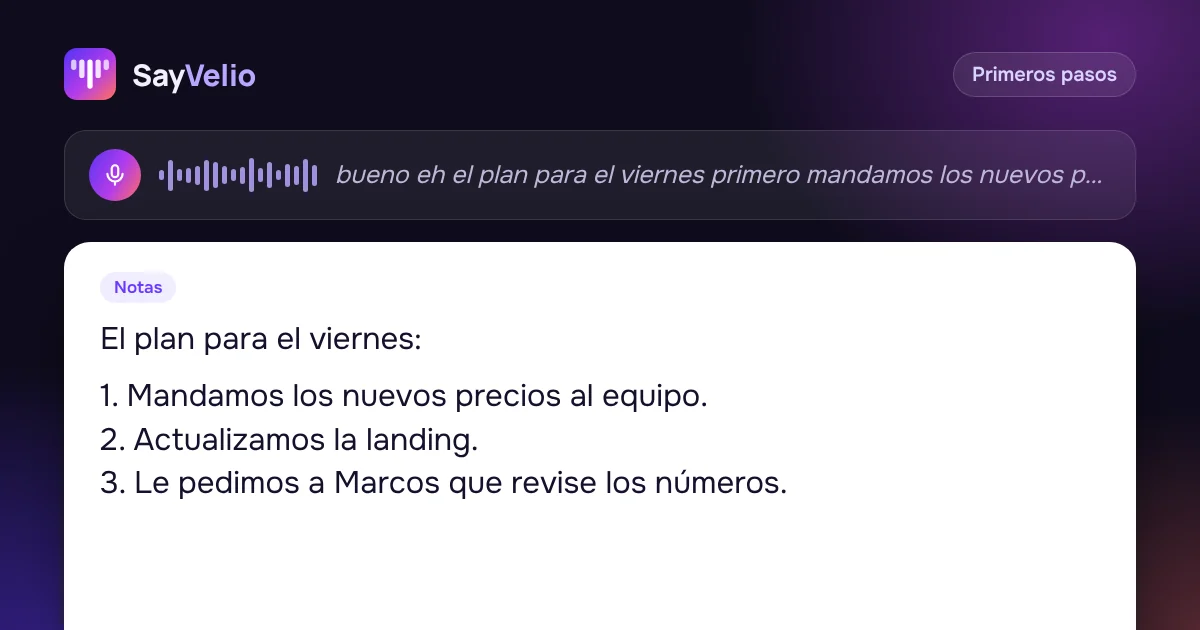 Primeros pasos
Cómo dictar bien: 9 hábitos para un texto limpio a la primera
Cómo hablar para que el dictado te entienda a la primera: mantener la tecla, decir ideas completas, corregirte en voz alta, dictar listas y qué hacer cuando una palabra sale mal.
MacWindowsiPhoneAndroid