
Как голос готовят к распознаванию: шумоподавление, подавление эха и детектор голоса
Что происходит со звуком до распознавания речи: автоматическая регулировка уровня, шумоподавление, подавление эха, детектор голосовой активности и спектрограммы, и почему «чище» не всегда значит лучше.
Коротко
До распознавания звук могут выровнять по громкости, очистить от эха и шума и разрезать на фрагменты с речью. У каждого из этих шагов одна узкая задача, ни один из них не понимает слов и ни один не обязателен. Сильное шумоподавление может даже навредить: вместе с шумом оно стирает тихие согласные, по которым различаются слова.
Вы сказали
привет том счёт во вложении дай знать если цифры правильные
SayVelio напечатал
Привет, Том!
Счёт во вложении. Дай знать, если цифры правильные.
Обработка сигнала — это не распознавание речи
Обработка сигнала работает со звуком, а не с языком. Она может сделать речь громче, тише или чище, может решить, где речь начинается и заканчивается, но никогда не решает, какие слова вы сказали. Это работа модели распознавания, о ней — в статье как работает распознавание речи.
Какие шаги использует приложение, зависит от ситуации. Звонку нужно подавление эха, потому что голос собеседника звучит из вашего динамика. Приложению для диктовки, когда ничего не играет, оно может быть вовсе не нужно.
Четыре инструмента, четыре разные задачи
| Инструмент | Что делает | Чего не может |
|---|---|---|
| Автоматическая регулировка уровня | Повышает или понижает уровень записи | Исправить голос, который изначально записан нечётко |
| Шумоподавление | Уменьшает постоянный фон: вентилятор, улицу | Разделить двух говорящих одновременно |
| Подавление эха | Убирает звук вашего динамика, который снова попал в микрофон | Помочь, когда ничего не играет |
| Детектор голосовой активности | Оценивает, в какие моменты звучит речь | Понять, что сказано |
Подавление эха — самое конкретное из них. Оно точно знает, что играет устройство, потому что получает эталонную копию этого звука, и вычитает ту часть, которую снова поймал микрофон. Шумоподавление же вынуждено угадывать, что считать шумом.
Детектор голоса: где в записи речь
Детектор голосовой активности (VAD) смотрит на короткие кусочки звука, часто по 10–30 миллисекунд, и оценивает, насколько вероятно, что в каждом есть речь. Простейший вариант просто проверяет громкость, но хлопок двери перешагнёт порог громкости, а тихий голос может оказаться ниже. Детекторы получше оценивают вероятность речи в каждом кусочке, склеивают соседние участки речи и отбрасывают слишком короткие, чтобы быть словами.
Детектор полезен, чтобы пропускать тишину и понимать, что вы закончили фразу. При записи «удерживай и говори», как в SayVelio, начало и конец записи определяете вы сами: она идёт ровно столько, сколько вы держите клавишу диктовки.
Почему «чище» не всегда лучше
Кажется, что чем сильнее убрать шум, тем лучше. Это не так. Согласные вроде «с», «ф», «т» и «к» — тихие, шумоподобные звуки, и агрессивное шумоподавление может «подъесть» их вместе с фоном. Человеку звук кажется чище, а распознавание потеряло подсказки, отличающие «пятнадцать» от «пятьдесят».
Современные модели распознавания обучены на огромном количестве реальной, шумной речи, поэтому часто справляются с исходным звуком лучше, чем с сильно обработанным. Хорошая обработка — мягкая, и её проверяют на настоящих диктовках, а не только на слух.
Спектрограммы: как машина «видит» звук
Многие распознаватели не работают с волной напрямую. Они ведут по записи короткое окно (обычно 20–30 мс) и измеряют, какие частоты есть в каждом окне. Получается спектрограмма: картинка, где по горизонтали время, по вертикали высота звука, а яркость показывает энергию.
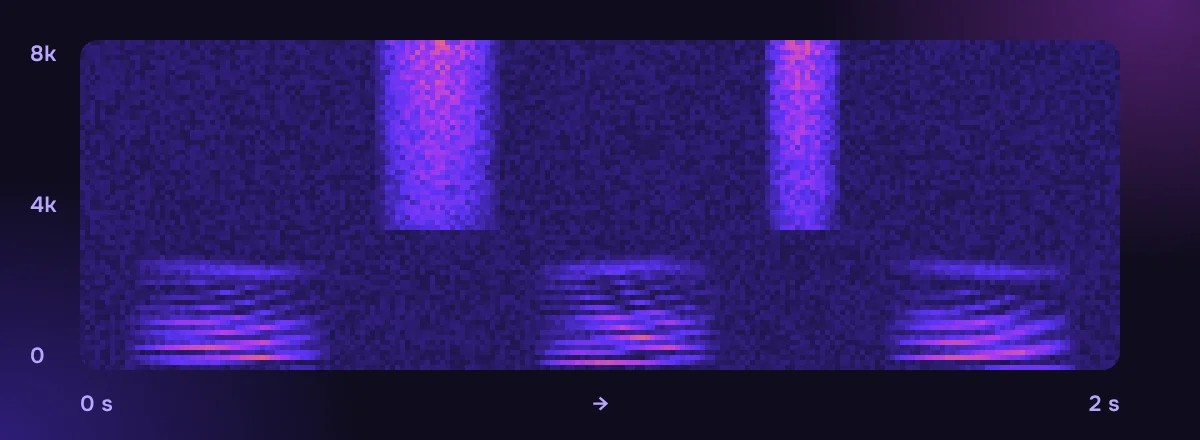
Спектрограмма — это не расшифровка. Она показывает звуковые узоры, которые модель учится связывать со звуками речи. Размер окна — компромисс: короткие окна точно показывают время, длинные — высоту. Некоторые новые модели пропускают этот шаг и учатся прямо на отсчётах.
Что можете сделать вы
- Диктуйте в самом тихом месте, какое есть. Даже хорошая обработка не уберёт коллегу, который говорит рядом: его голос — тоже речь.
- Приглушайте музыку и видео, пока диктуете.
- Держите одинаковое расстояние до микрофона, чтобы уровень был ровным. Больше советов — в гайде как хорошо диктовать.
Частые вопросы
Всегда ли лучшее качество звука даёт лучший текст?
Не всегда. Больше всего помогает чёткая речь с нормальным уровнем. Сильное шумоподавление, искажения или неподходящий формат звука могут убрать детали, нужные распознаванию, а ещё важны обучение модели, язык и словарь.
Можно ли диктовать в шумном кафе?
Часто да, особенно с микрофоном гарнитуры у рта. Постоянный шум вроде кофемашины даётся легче, чем голоса других людей рядом.
Похожие материалы
 Как устроен голосовой ввод
От звуковой волны к цифровому звуку: что записывает микрофон при диктовке
Как микрофон и устройство превращают речь в числа: частота дискретизации, разрядность, моно, передискретизация и почему расположение микрофона важнее характеристик.
MacWindowsiPhoneAndroid Как устроен голосовой ввод
Как распознавание речи превращает звук в слова
Почему речь трудна для компьютера, как работали классические распознаватели с акустической, произносительной и языковой моделями, что изменили сквозные модели (CTC, кодер-декодер, трансдьюсеры) и почему текст при потоковом распознавании меняется на ходу.
MacWindowsiPhoneAndroid С чего начать
Как правильно диктовать: 9 привычек для чистого текста с первого раза
Как говорить, чтобы диктовка понимала вас с первого раза: держать клавишу, говорить мыслями целиком, исправляться вслух, диктовать списки и что делать, если слово пишется неправильно.
MacWindowsiPhoneAndroid