
Préparer la voix pour la reconnaissance : réduction du bruit, suppression de l'écho et détection de la voix
Ce qui arrive au son avant la reconnaissance vocale : contrôle automatique du gain, réduction du bruit, suppression de l'écho, détection d'activité vocale et spectrogrammes, et pourquoi un son plus propre n'est pas toujours meilleur.
En bref
Avant la reconnaissance, le son peut être nivelé, débarrassé de l'écho et du bruit, et découpé en passages contenant de la parole. Chacune de ces étapes a une tâche précise, aucune ne comprend les mots et aucune n'est obligatoire. Une réduction du bruit trop forte peut même nuire : elle efface les consonnes discrètes qui permettent de distinguer les mots.
Vous avez dit
bonjour thomas la facture est en pièce jointe dites-moi si les chiffres sont bons
SayVelio a écrit
Bonjour Thomas,
La facture est en pièce jointe. Dites-moi si les chiffres sont bons.
Traiter le signal n'est pas reconnaître la parole
Le traitement du signal agit sur le son, pas sur la langue. Il peut rendre la voix plus forte, plus faible ou plus nette, ou décider où elle commence et s'arrête, mais il ne décide jamais quels mots vous avez dits. C'est le rôle du modèle de reconnaissance, présenté dans comment fonctionne la reconnaissance vocale.
Les étapes utilisées dépendent de la situation. Un appel a besoin de suppression d'écho, car la voix de votre interlocuteur sort de votre haut-parleur. Une app de dictée sans rien qui joue peut s'en passer.
Quatre outils, quatre rôles
| Outil | Ce qu'il fait | Ce qu'il ne peut pas faire |
|---|---|---|
| Contrôle automatique du gain | Monte ou baisse le niveau d'enregistrement | Sauver une voix jamais captée clairement |
| Réduction du bruit | Atténue les bruits constants : ventilateur, circulation | Séparer deux personnes qui parlent en même temps |
| Suppression de l'écho | Retire le son de votre haut-parleur qui revient dans le micro | Aider quand rien ne joue |
| Détection d'activité vocale | Estime à quels moments il y a de la parole | Savoir ce qui a été dit |
La suppression de l'écho est la plus ciblée. Elle sait exactement ce que joue votre appareil, car elle en reçoit une copie de référence, et soustrait la part que le micro capte à nouveau. La réduction du bruit, elle, doit deviner ce qui est du bruit.
Détection d'activité vocale : trouver la parole
Un détecteur d'activité vocale (VAD) examine de courts extraits de son, souvent de 10 à 30 millisecondes, et estime la probabilité que chacun contienne de la parole. La version la plus simple se fie au volume, mais une porte qui claque dépasse le seuil et une voix douce peut rester dessous. Les meilleurs détecteurs estiment une probabilité de parole par extrait, fusionnent les zones de parole voisines et écartent celles trop courtes pour être des mots.
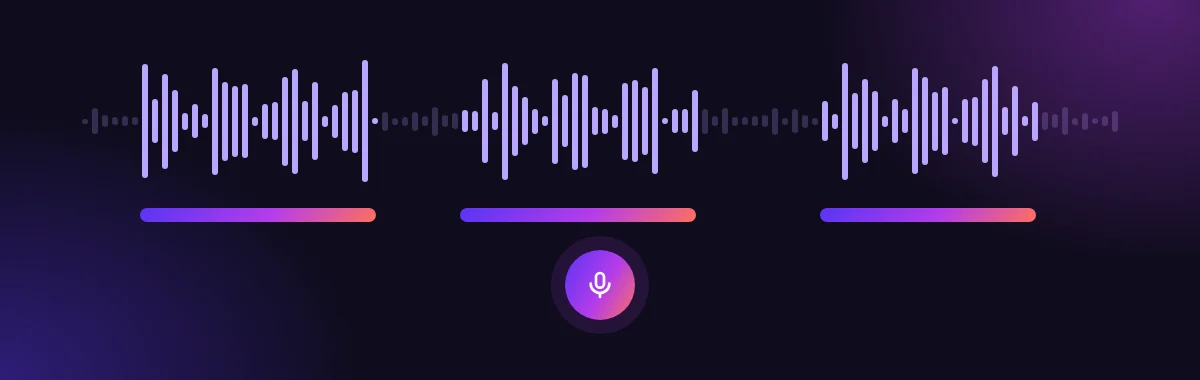
La détection sert à ignorer le silence et à savoir que vous avez fini une phrase. Avec l'appui maintenu, comme dans SayVelio, c'est vous qui fixez le début et la fin : l'enregistrement dure exactement le temps où vous maintenez la touche de dictée.
Pourquoi plus propre n'est pas toujours mieux
On pourrait croire que retirer plus de bruit aide toujours. Ce n'est pas le cas. Les consonnes comme « s », « f », « t » et « k » sont des sons faibles, proches du bruit, et une réduction agressive peut les gommer avec le fond. À l'oreille, le son paraît plus propre, mais la reconnaissance a perdu les indices qui séparent « seize » de « six ».
Les modèles actuels sont entraînés sur énormément de parole réelle et bruitée ; ils s'en sortent donc souvent mieux avec le son d'origine qu'avec un son très traité. Un bon traitement est doux et se teste sur de vraies dictées, pas seulement à l'oreille.
Spectrogrammes : comment une machine « voit » le son
Beaucoup de systèmes n'utilisent pas directement la forme d'onde. Ils font glisser une courte fenêtre (souvent 20 à 30 ms) sur le son et mesurent les fréquences présentes dans chacune. On obtient un spectrogramme : une image avec le temps à l'horizontale, la hauteur à la verticale et la luminosité pour l'énergie.
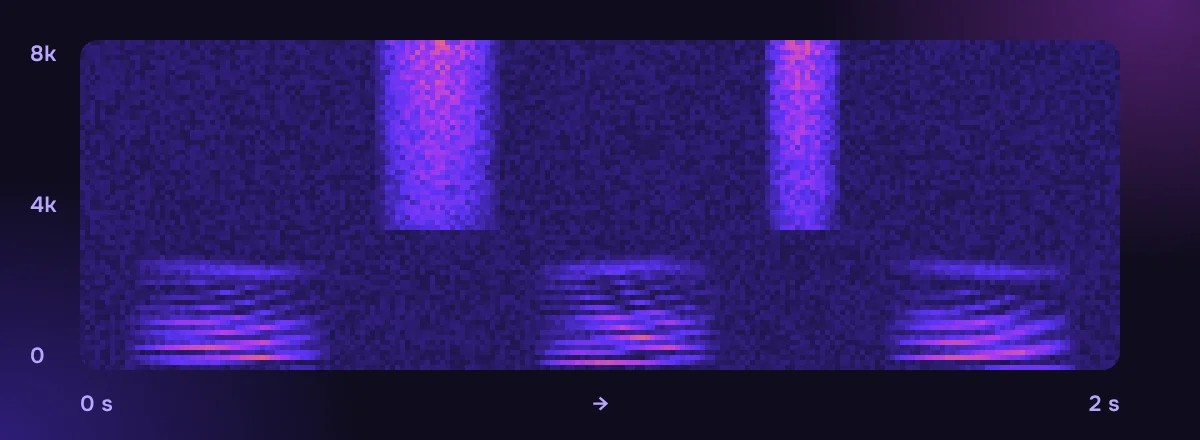
Un spectrogramme n'est pas une transcription. Il montre des motifs sonores qu'un modèle apprend à relier aux sons de la parole. La taille de la fenêtre est un compromis : courte, elle montre précisément le temps ; longue, la hauteur. Certains modèles récents sautent cette étape et apprennent directement à partir des échantillons.
Ce que vous pouvez faire
- Dictez dans l'endroit le plus calme possible. Même un bon traitement n'efface pas un collègue qui parle à côté : sa voix est aussi de la parole.
- Baissez la musique et les vidéos pendant la dictée.
- Gardez une distance constante avec le micro, pour un niveau stable. D'autres conseils dans bien dicter.
Questions fréquentes
Une meilleure qualité audio donne-t-elle toujours un meilleur texte ?
Pas toujours. Ce qui aide le plus, c'est une voix claire à bon niveau. Une réduction du bruit poussée, de la distorsion ou un mauvais format audio peuvent retirer des détails utiles à la reconnaissance, et l'entraînement, la langue et le vocabulaire du modèle comptent aussi.
Peut-on dicter dans un café bruyant ?
Souvent oui, surtout avec le micro d'un casque près de la bouche. Un bruit constant comme une machine à café se gère mieux que d'autres voix à proximité.
À lire aussi
 Comment fonctionne la saisie vocale
De l'onde sonore à l'audio numérique : ce que votre micro enregistre pendant la dictée
Comment le micro et l'appareil transforment la parole en nombres : fréquence d'échantillonnage, résolution, mono, rééchantillonnage, et pourquoi la position du micro compte plus que ses caractéristiques.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
Comment la reconnaissance vocale transforme le son en mots
Pourquoi la parole est difficile pour un ordinateur, comment fonctionnaient les systèmes classiques avec modèles acoustique, de prononciation et de langage, ce que les modèles de bout en bout (CTC, encodeur-décodeur, transducteurs) ont changé, et pourquoi le texte en streaming bouge pendant que vous parlez.
MacWindowsiPhoneAndroid Bien démarrer
Bien dicter : 9 habitudes pour un texte propre du premier coup
Comment parler pour que la dictée vous comprenne du premier coup : maintenir la touche, dire des idées entières, se corriger à voix haute, dicter des listes, et que faire quand un mot sort mal.
MacWindowsiPhoneAndroid