
Preparare la voce al riconoscimento: riduzione del rumore, controllo dell'eco e rilevamento della voce
Cosa succede all'audio prima del riconoscimento vocale: controllo automatico del guadagno, riduzione del rumore, cancellazione dell'eco, rilevamento dell'attività vocale e spettrogrammi, e perché un audio più pulito non è sempre migliore.
In breve
Prima del riconoscimento l'audio può essere livellato, ripulito da eco e rumore e tagliato nelle parti che contengono voce. Ognuno di questi passaggi ha un compito preciso, nessuno capisce le parole e nessuno è obbligatorio. Una riduzione del rumore troppo forte può addirittura peggiorare le cose, perché cancella le consonanti deboli che distinguono una parola dall'altra.
Hai detto
ciao tommaso ti allego la fattura fammi sapere se i numeri tornano
SayVelio ha scritto
Ciao Tommaso,
ti allego la fattura. Fammi sapere se i numeri tornano.
Elaborare il segnale non è riconoscere il parlato
L'elaborazione del segnale lavora sul suono, non sulla lingua. Può rendere la voce più forte, più debole o più chiara, o decidere dove inizia e finisce, ma non decide mai quali parole hai detto. Quello è il compito del modello di riconoscimento, descritto in come funziona il riconoscimento vocale.
Quali passaggi usa un'app dipende dalla situazione. Una chiamata ha bisogno della cancellazione dell'eco, perché la voce dell'altra persona esce dal tuo altoparlante. Un'app di dettatura senza nulla in riproduzione può non averne bisogno affatto.
Quattro strumenti, quattro compiti
| Strumento | Cosa fa | Cosa non può fare |
|---|---|---|
| Controllo automatico del guadagno | Alza o abbassa il livello di registrazione | Recuperare una voce mai catturata bene |
| Riduzione del rumore | Attenua rumori costanti come ventole o traffico | Separare due persone che parlano insieme |
| Cancellazione dell'eco | Toglie il suono del tuo altoparlante che rientra nel microfono | Aiutare quando non suona nulla |
| Rilevamento dell'attività vocale | Stima in quali momenti c'è voce | Sapere cosa è stato detto |
La cancellazione dell'eco è la più mirata. Sa esattamente cosa sta riproducendo il tuo dispositivo, perché ne riceve una copia di riferimento, e sottrae la parte che il microfono ricattura. La riduzione del rumore, invece, deve indovinare cosa sia rumore.
Rilevamento dell'attività vocale: trovare il parlato
Un rilevatore di attività vocale (VAD) esamina brevi frammenti di audio, spesso da 10 a 30 millisecondi, e stima la probabilità che ognuno contenga voce. La versione più semplice guarda solo il volume, ma una porta che sbatte supera la soglia e una voce sommessa può restare sotto. I rilevatori migliori stimano una probabilità di voce per frammento, uniscono le zone di parlato vicine e scartano quelle troppo brevi per essere parole.
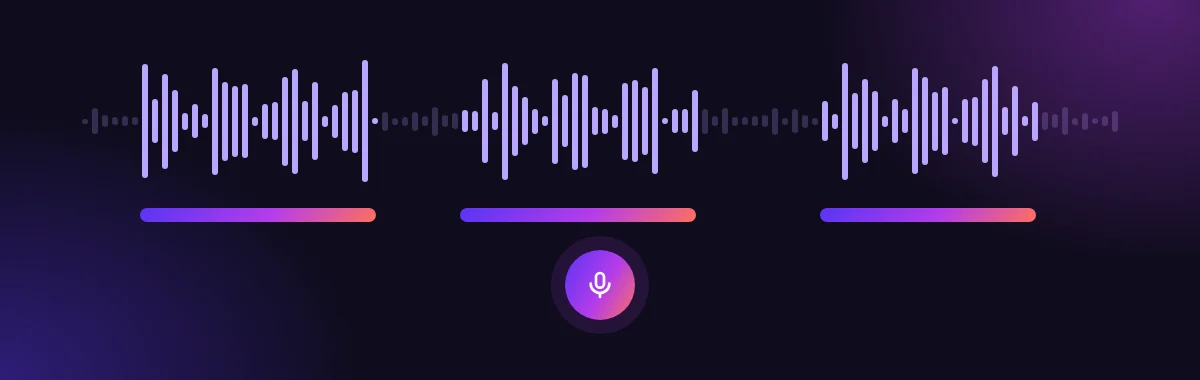
Il rilevamento serve a saltare il silenzio e a capire quando hai finito una frase. Con «tieni premuto e parla», come in SayVelio, sei tu a decidere inizio e fine della registrazione: dura esattamente quanto tieni premuto il tasto di dettatura.
Perché più pulito non è sempre meglio
Viene da pensare che togliere più rumore aiuti sempre. Non è così. Consonanti come «s», «f», «t» e «c» dura sono suoni deboli, simili al rumore, e una riduzione aggressiva può assottigliarle insieme allo sfondo. A un orecchio umano l'audio sembra più pulito, ma il riconoscimento ha perso gli indizi che separano «sedici» da «sei».
I modelli moderni sono addestrati su tantissimo parlato reale e rumoroso, quindi spesso se la cavano meglio con il suono originale che con un audio molto elaborato. Una buona elaborazione è delicata e viene testata su dettature vere, non solo a orecchio.
Spettrogrammi: come una macchina vede il suono
Molti sistemi di riconoscimento non usano direttamente la forma d'onda. Fanno scorrere una finestra breve (di solito 20–30 ms) sull'audio e misurano quali frequenze ci sono in ciascuna. Il risultato è uno spettrogramma: un'immagine con il tempo in orizzontale, l'altezza in verticale e la luminosità come energia.
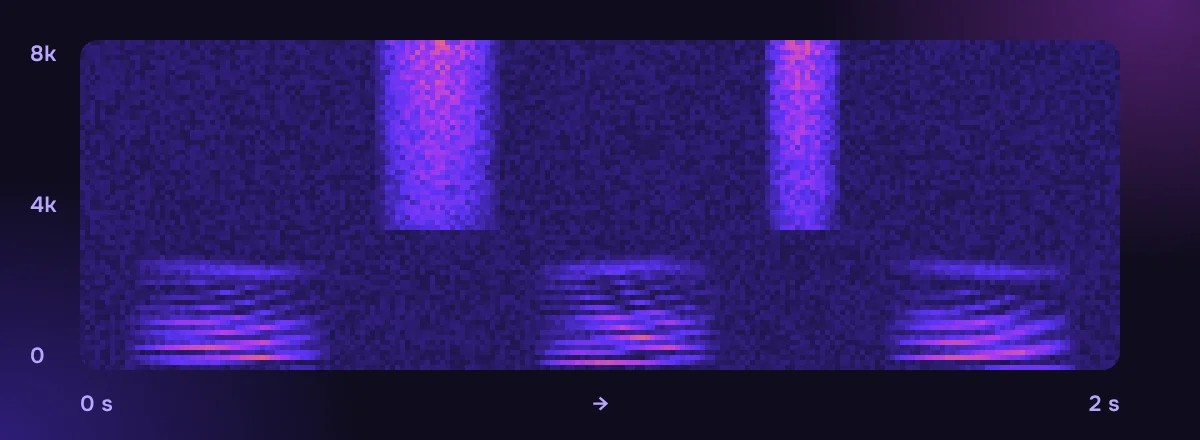
Uno spettrogramma non è una trascrizione. Mostra schemi sonori che un modello impara ad associare ai suoni del parlato. La dimensione della finestra è un compromesso: finestre corte mostrano bene i tempi, finestre lunghe l'altezza. Alcuni modelli più recenti saltano questo passaggio e imparano direttamente dai campioni.
Cosa puoi fare tu
- Detta nel posto più tranquillo che hai. Nemmeno una buona elaborazione elimina un collega che parla accanto a te: anche la sua è voce.
- Abbassa musica e video mentre detti.
- Mantieni una distanza costante dal microfono, così il livello resta stabile. Altri consigli in come dettare bene.
Domande frequenti
Una migliore qualità audio dà sempre un testo migliore?
Non sempre. Aiuta soprattutto una voce chiara a buon livello. Una riduzione del rumore pesante, la distorsione o un formato audio sbagliato possono togliere dettagli che servono al riconoscimento, e contano anche addestramento, lingua e vocabolario del modello.
Si può dettare in un bar rumoroso?
Spesso sì, soprattutto con il microfono di un auricolare vicino alla bocca. Un rumore costante come la macchina del caffè si gestisce meglio di altre voci vicine.
Leggi anche
 Come funziona la dettatura vocale
Dall'onda sonora all'audio digitale: cosa registra il tuo microfono quando detti
Come microfono e dispositivo trasformano la voce in numeri: frequenza di campionamento, profondità di bit, audio mono, ricampionamento e perché la posizione del microfono conta più delle specifiche.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Come il riconoscimento vocale trasforma il suono in parole
Perché il parlato è difficile per un computer, come funzionavano i riconoscitori classici con modelli acustici, di pronuncia e linguistici, cosa hanno cambiato i modelli end-to-end (CTC, encoder-decoder, transducer) e perché il testo in streaming può cambiare mentre parli.
MacWindowsiPhoneAndroid Per iniziare
Come dettare bene: 9 abitudini per un testo pulito al primo colpo
Come parlare perché la dettatura ti capisca al primo colpo: tenere premuto il tasto, dire pensieri interi, correggerti a voce, dettare elenchi e cosa fare quando una parola esce sbagliata.
MacWindowsiPhoneAndroid