
Cómo el reconocimiento de voz convierte el sonido en palabras
Por qué el habla es difícil para un ordenador, cómo funcionaban los reconocedores clásicos con modelos acústico, de pronunciación y de lenguaje, qué cambiaron los modelos de extremo a extremo (CTC, codificador-decodificador, transductores) y por qué el texto en streaming cambia mientras hablas.
En resumen
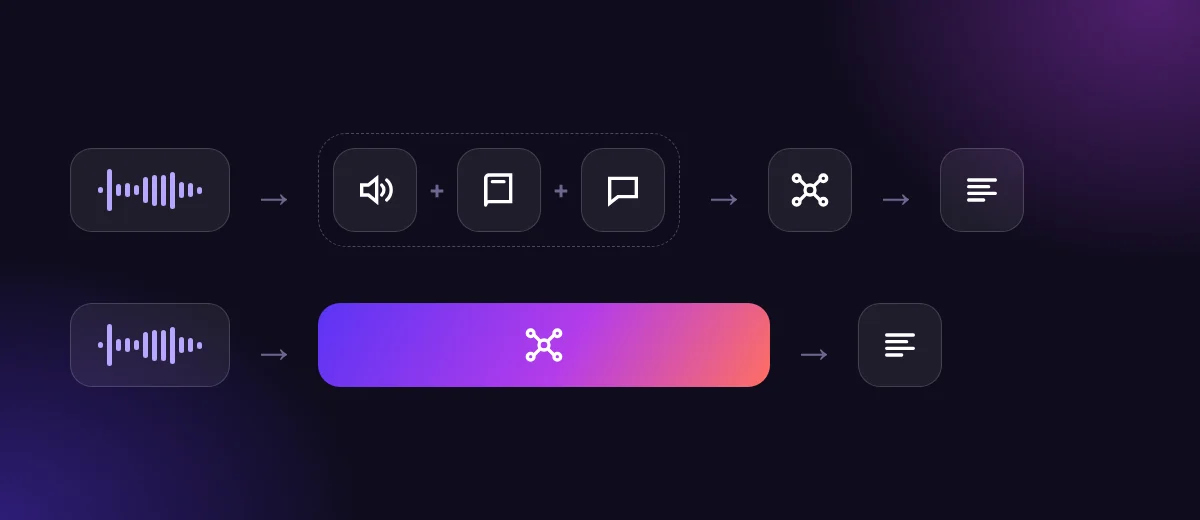
El habla no tiene pausas claras entre palabras y cada persona pronuncia distinto, así que un reconocedor nunca «lee» las palabras del audio. Estima la secuencia de palabras más probable a partir del sonido y de los patrones aprendidos en el entrenamiento. Los sistemas antiguos usaban modelos separados de acústica, pronunciación y lenguaje; la mayoría de los actuales aprenden todo el camino del audio al texto en una sola red.
Dijiste
si vienes a verme te enseño la casa nueva
SayVelio escribió
Si vienes a verme, te enseño la casa nueva.
Por qué reconocer la voz es difícil
El texto escrito tiene espacios entre palabras. El habla, no. Los sonidos se encadenan: «si vienes» y «sí, vienes» suenan igual, y «a ver» y «haber» son idénticos al oído. Los sonidos cambian según sus vecinos, la gente habla a distintas velocidades y tonos, y cada acento colorea las vocales.
Así que un mismo trozo de audio puede encajar con varias secuencias de palabras. Un reconocedor no descifra las palabras con certeza: sopesa las opciones y elige la más probable. Por eso un resultado puede leerse perfectamente y aun así estar mal.
El enfoque clásico: tres modelos y un decodificador
Durante décadas, el reconocimiento de voz se construyó con piezas separadas:
- Un modelo acústico relacionaba fragmentos cortos de audio con sonidos del habla (fonemas).
- Un diccionario de pronunciación recogía cómo puede sonar cada palabra como secuencia de esos sonidos.
- Un modelo de lenguaje puntuaba lo probable que es una secuencia de palabras en el idioma («vamos a ver la película» es mucho más probable que «vamos haber la película»).
- Un decodificador recorría las combinaciones para encontrar la mejor coincidencia global.
Este diseño sigue siendo la forma más clara de entender el problema, y algunos sistemas usan partes de él. Pero no es así como funcionan la mayoría de los reconocedores actuales.
Modelos de extremo a extremo: una red del audio al texto
Los sistemas actuales aprenden una correspondencia directa del audio al texto en una única red neuronal entrenada con enormes cantidades de voz transcrita. Hay tres familias habituales:
- CTC (clasificación temporal conexionista) predice un carácter o trozo de palabra para cada fotograma corto de audio, incluido un símbolo «vacío» especial, y luego junta las repeticiones y quita los vacíos. No necesita que nadie marque dónde empieza cada palabra en el audio de entrenamiento.
- Los modelos codificador-decodificador con atención convierten primero toda la grabación en una representación interna y luego escriben el texto pieza a pieza, «mirando» las partes relevantes del audio para cada pieza nueva.
- Los transductores (RNN-T y similares) combinan un codificador de audio con un componente que recuerda el texto ya producido, lo que los hace muy adecuados para dar texto mientras todavía hablas.
Los productos reales mezclan estas ideas, y algunos añaden pasos como pistas de contexto para palabras raras (ver cómo ayuda el contexto al reconocimiento). Una app de dictado no te dice qué arquitectura usa, y no hace falta: lo que te importa es la precisión, la velocidad y qué pasa con tus datos.
Grabación completa o streaming
El reconocimiento puede hacerse sobre la grabación completa cuando terminas o de forma continua mientras hablas:
- El streaming muestra palabras casi al instante, pero las primeras suposiciones pueden cambiar cuando las palabras siguientes aportan contexto. «A ver si llegas» puede aparecer un momento como «haber si llegas» y corregirse.
- El reconocimiento de la grabación completa espera a que termines, pero ve la frase entera de una vez, lo que suele ayudar a la precisión y la puntuación.
El retraso que notas incluye también detectar que has terminado, el tiempo de red y la limpieza, si la hay. En SayVelio mantienes la tecla mientras hablas, así que el final de la grabación es exacto, y el texto se inserta cuando es definitivo, no palabra por palabra.
Por qué el resultado es una probabilidad, no un hecho
Como el sistema siempre elige la opción más probable, sus errores parecen creíbles: una palabra real, bien escrita, que no dijiste. Los nombres, los números y los términos raros son los más expuestos, porque el modelo los ha visto menos. Dos defensas prácticas:
- Enseña tus palabras al sistema con un diccionario personal.
- Lee los textos importantes antes de enviarlos, sobre todo importes, fechas y el «no».
Preguntas frecuentes
¿El reconocimiento de voz entiende lo que quiero decir?
No en el sentido humano. Estima qué palabras se dijeron. El significado solo entra a través de patrones aprendidos de textos, que ayudan a elegir entre frases que suenan parecido.
¿Por qué mi dictado falla siempre en la misma palabra?
Normalmente porque la palabra es rara o suena como otra más común. Añadirla a tu diccionario, con cómo suena como variante, arregla la mayoría de estos casos.
Lecturas relacionadas
 Cómo funciona el dictado por voz
Cómo aprende el reconocimiento de voz y por qué el contexto ayuda con nombres y jerga
Entrenamiento frente a uso diario, por qué los modelos fallan con nombres y acentos poco habituales, cómo las pistas de contexto y los diccionarios guían el reconocimiento y por qué dictar no significa que tu voz entrene al modelo.
MacWindowsiPhoneAndroid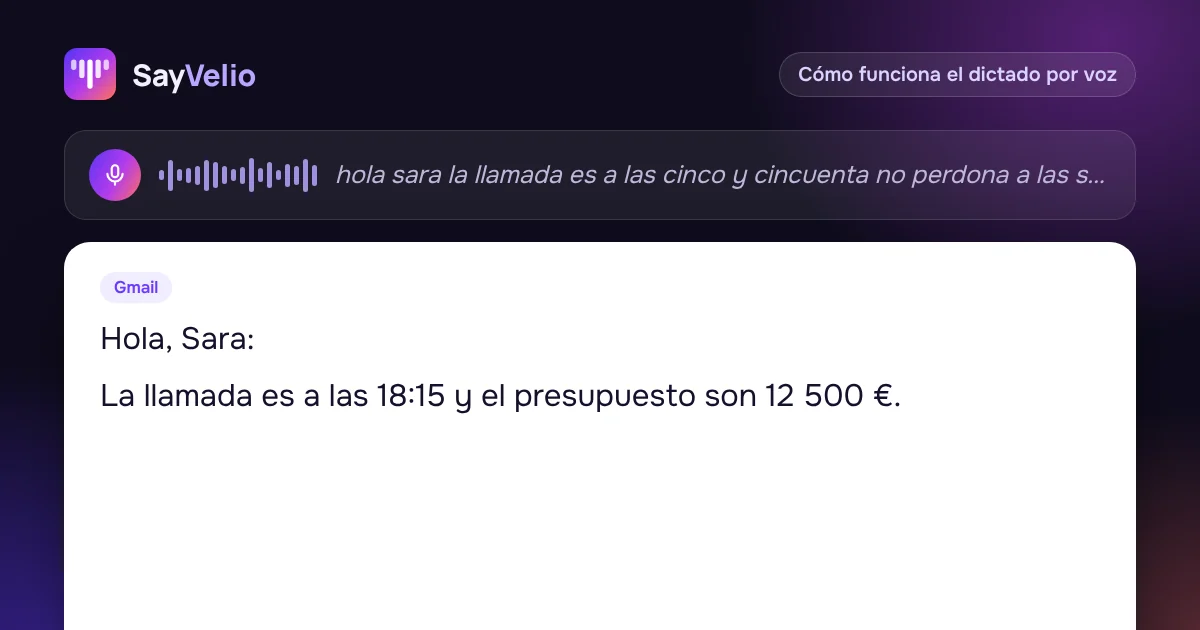 Cómo funciona el dictado por voz
De la transcripción en bruto al texto legible: puntuación, números y limpieza
Por qué una transcripción en bruto no está lista para enviar, cómo se añaden puntuación, mayúsculas, números y listas, por qué «cinco cincuenta» es ambiguo y cómo evitar que la limpieza cambie lo que querías decir.
MacWindowsiPhoneAndroid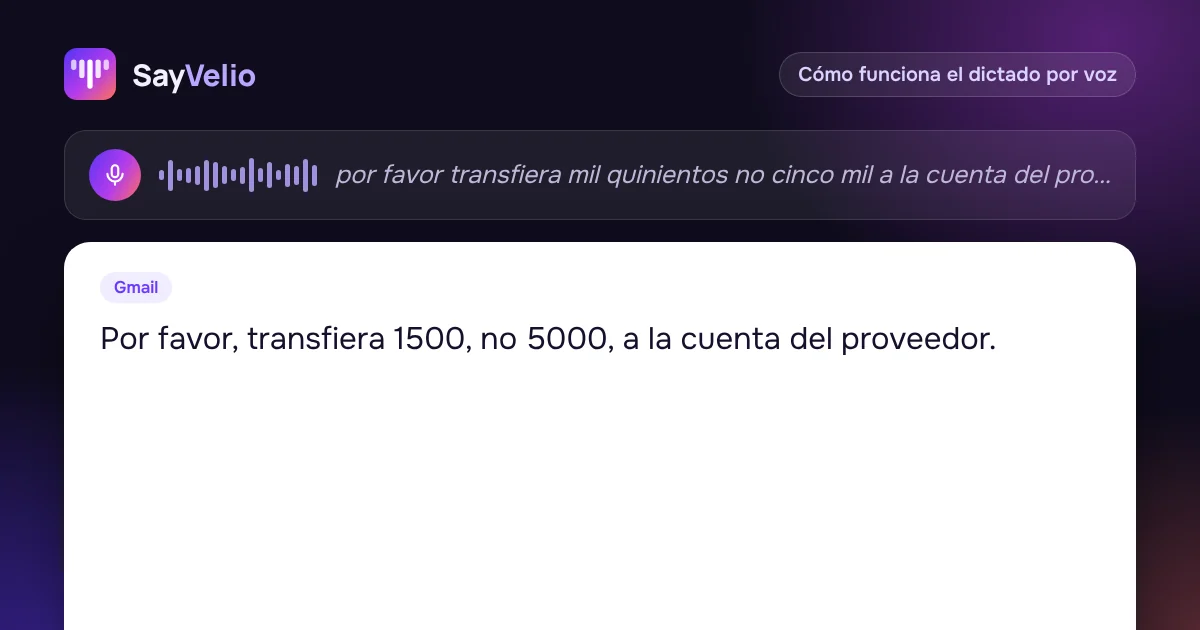 Cómo funciona el dictado por voz
¿Qué precisión tiene el dictado por voz? Tasa de error, velocidad y límites reales
Cómo se mide la precisión del reconocimiento de voz (tasa de error de palabras), qué dicen los estudios sobre la velocidad del dictado frente a teclear, qué empeora los resultados y qué palabras conviene revisar siempre.
MacWindowsiPhoneAndroid