
Reconocimiento de voz y texto a voz: en qué se diferencian
El reconocimiento de voz convierte la voz en texto; la síntesis, el texto en voz. Cómo funciona cada uno, dónde se cruzan (números, fechas, nombres), en qué se distinguen de ambos los códecs de voz y por qué una app de dictado no lee el texto en voz alta.
En resumen
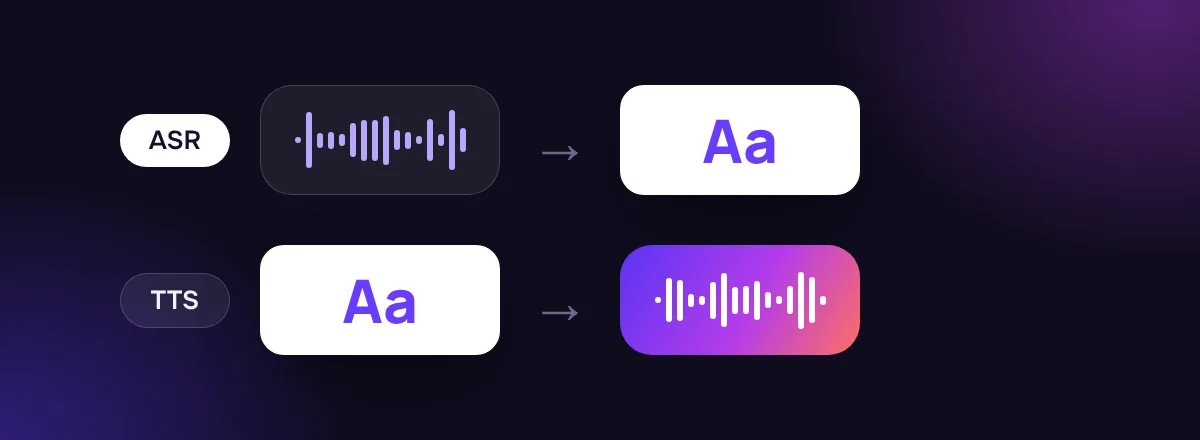
El reconocimiento de voz (ASR) escucha y escribe: entra audio, sale texto. La síntesis de voz (TTS) lee y habla: entra texto, sale audio. A menudo aparecen juntos en los asistentes de voz, pero son tecnologías distintas, con entrenamiento, resultado y medidas de calidad diferentes. Una tercera tecnología, el códec de voz, solo reduce el audio para enviarlo y no hace ninguna de las dos cosas.
Dijiste
la reunión se ha movido al doce a las tres y media de la tarde
SayVelio escribió
La reunión se ha movido al día 12 a las 15:30.
Direcciones opuestas
| Reconocimiento de voz (ASR) | Síntesis de voz (TTS) | Códec de voz | |
|---|---|---|---|
| Entrada | Audio de alguien hablando | Texto escrito | Audio |
| Salida | Texto | Audio de voz sintética | El mismo audio, más pequeño |
| Pregunta clave | ¿Qué palabras se dijeron? | ¿Cómo debe sonar este texto? | ¿Cómo enviar este sonido con eficiencia? |
| Uso típico | Dictado, subtítulos, búsqueda por voz | Lectores de pantalla, navegación, audiolibros | Llamadas, mensajes de voz |
| Calidad medida por | Tasa de error de palabras | Valoraciones de naturalidad e inteligibilidad | Pruebas de escucha a un bitrate dado |
Un asistente de voz usa los dos: reconocimiento para entender tu pregunta y síntesis para responder en voz alta. Pero uno no implica el otro. SayVelio es una app de dictado: reconoce la voz y escribe texto, y no lee nada en voz alta.
Cómo funciona la síntesis de voz
Un sistema TTS típico trabaja por etapas:
- Análisis del texto. Desarrollar abreviaturas y números en palabras (¿«Dr.» es «doctor» o «doctora»?) y elegir la pronunciación correcta cuando hace falta contexto («el 1/2» puede ser «un medio» o «uno de febrero»).
- Prosodia. Decidir el ritmo, las pausas, el énfasis y la entonación, para que una pregunta suene a pregunta.
- Modelo acústico. Predecir cómo debe sonar la voz a lo largo del tiempo, a menudo como un espectrograma.
- Vocoder. Convertir esa predicción en una forma de onda real que se pueda reproducir.
Un ejemplo conocido es Tacotron 2 de Google (2018), que predice un espectrograma mel a partir del texto y usa un vocoder neuronal para producir el audio. Muchos sistemas más nuevos fusionan o reordenan estas etapas, pero la tarea de cada una sigue ahí.
Los desarrolladores pueden guiar la síntesis con SSML (Speech Synthesis Markup Language), un estándar del W3C para marcar pausas, énfasis, pronunciación y cómo leer fechas y similares. El soporte de cada función de SSML varía según el motor.
Donde se cruzan: números, fechas y nombres
Las dos direcciones tropiezan con lo mismo, desde lados opuestos:
- El dictado tiene que convertir «doce cincuenta» dicho en voz en algo escrito: ¿12:50? ¿1250? ¿12,50 €? Es la normalización inversa del texto, descrita en de la transcripción al texto.
- La síntesis tiene que convertir «12/05» escrito en voz: ¿doce de mayo o cinco de diciembre? Es la normalización del texto.
Están relacionadas, pero no son espejos exactos, porque la respuesta correcta depende del contexto en ambos sentidos. Los nombres también son difíciles en las dos direcciones: un reconocedor tiene que saber cómo se escribe un nombre que oye (para eso está el diccionario) y un sintetizador, cómo se pronuncia uno que lee.
Los códecs son una tercera cosa aparte
Un códec de voz como Opus representa con menos bits un audio que ya existe, para enviarlo o guardarlo. No crea voz a partir de texto ni decide qué palabras dijo alguien. Un producto que transcribe voz no tiene por qué sintetizarla ni usar un códec concreto. Más en compresión de audio para voz.
Los dos usan aprendizaje automático, de forma distinta
ASR y TTS modernos se basan en redes neuronales y aprenden de pares de audio y texto. Pero sus objetivos son opuestos: a ASR se le juzga por acertar las palabras, y a TTS, por si la gente encuentra la voz natural y fácil de entender. Un modelo excelente en una cosa no sabe hacer automáticamente la otra.
Preguntas frecuentes
¿SayVelio puede leerme mi texto en voz alta?
No. SayVelio sirve para escribir con la voz. Para que te lean un texto, usa la función integrada de tu sistema: Contenido leído en Mac y iPhone, Narrador en Windows y Seleccionar para pronunciar en Android.
¿«Voz a texto» es lo mismo que «reconocimiento de voz»?
Normalmente se usan como sinónimos, pero en sentido estricto el reconocimiento de voz también puede referirse a identificar quién habla. SayVelio reconoce lo que dices, no quién eres.
Lecturas relacionadas
 Cómo funciona el dictado por voz
Cómo el reconocimiento de voz convierte el sonido en palabras
Por qué el habla es difícil para un ordenador, cómo funcionaban los reconocedores clásicos con modelos acústico, de pronunciación y de lenguaje, qué cambiaron los modelos de extremo a extremo (CTC, codificador-decodificador, transductores) y por qué el texto en streaming cambia mientras hablas.
MacWindowsiPhoneAndroid Cómo funciona el dictado por voz
De la transcripción en bruto al texto legible: puntuación, números y limpieza
Por qué una transcripción en bruto no está lista para enviar, cómo se añaden puntuación, mayúsculas, números y listas, por qué «cinco cincuenta» es ambiguo y cómo evitar que la limpieza cambie lo que querías decir.
MacWindowsiPhoneAndroid Cómo funciona el dictado por voz
Formatos y compresión de audio en el dictado por voz
El audio digital, la codificación y la compresión son tres cosas distintas. Cómo funciona la compresión con y sin pérdida, por qué ningún algoritmo puede reducir cualquier archivo, cómo los códecs de voz como Opus equilibran tamaño y retardo, y qué significa para el dictado.
MacWindowsiPhoneAndroid