
Comment la reconnaissance vocale transforme le son en mots
Pourquoi la parole est difficile pour un ordinateur, comment fonctionnaient les systèmes classiques avec modèles acoustique, de prononciation et de langage, ce que les modèles de bout en bout (CTC, encodeur-décodeur, transducteurs) ont changé, et pourquoi le texte en streaming bouge pendant que vous parlez.
En bref
La parole n'a pas de pauses nettes entre les mots et chacun prononce différemment : un système de reconnaissance ne « lit » donc jamais les mots dans le son. Il estime la suite de mots la plus probable à partir du son et des régularités apprises à l'entraînement. Les anciens systèmes utilisaient des modèles séparés pour l'acoustique, la prononciation et la langue ; la plupart des modèles actuels apprennent tout le trajet du son au texte dans un seul réseau.
Vous avez dit
il est venu avec ses amis et ils sont arrivés vers huit heures
SayVelio a écrit
Il est venu avec ses amis et ils sont arrivés vers 8 h.
Pourquoi reconnaître la parole est difficile
Le texte écrit a des espaces entre les mots. La parole, non. Les sons s'enchaînent : « l'avoir » et « la voir » sonnent pareil, « ces amis » et « ses amis » sont identiques à l'oreille. Les sons changent selon leurs voisins, les gens parlent à des vitesses et des hauteurs différentes, et chaque accent colore les voyelles.
Un même passage peut donc correspondre à plusieurs suites de mots. Le système ne déchiffre pas les mots avec certitude : il pèse les possibilités et choisit la plus probable. C'est pourquoi un résultat peut se lire parfaitement et pourtant être faux.
L'approche classique : trois modèles et un décodeur
Pendant des décennies, la reconnaissance vocale a été construite avec des pièces séparées :
- Un modèle acoustique reliait de courts extraits de son à des sons de la langue (phonèmes).
- Un dictionnaire de prononciation indiquait comment chaque mot peut se prononcer sous forme de suite de ces sons.
- Un modèle de langage évaluait la probabilité d'une suite de mots dans la langue (« je veux la voir demain » est bien plus probable que « je veux l'avoir demain » dans ce contexte).
- Un décodeur parcourait les combinaisons pour trouver la meilleure correspondance globale.
Ce schéma reste la façon la plus claire de comprendre le problème, et certains systèmes en utilisent des morceaux. Mais ce n'est pas ainsi que fonctionnent la plupart des systèmes actuels.
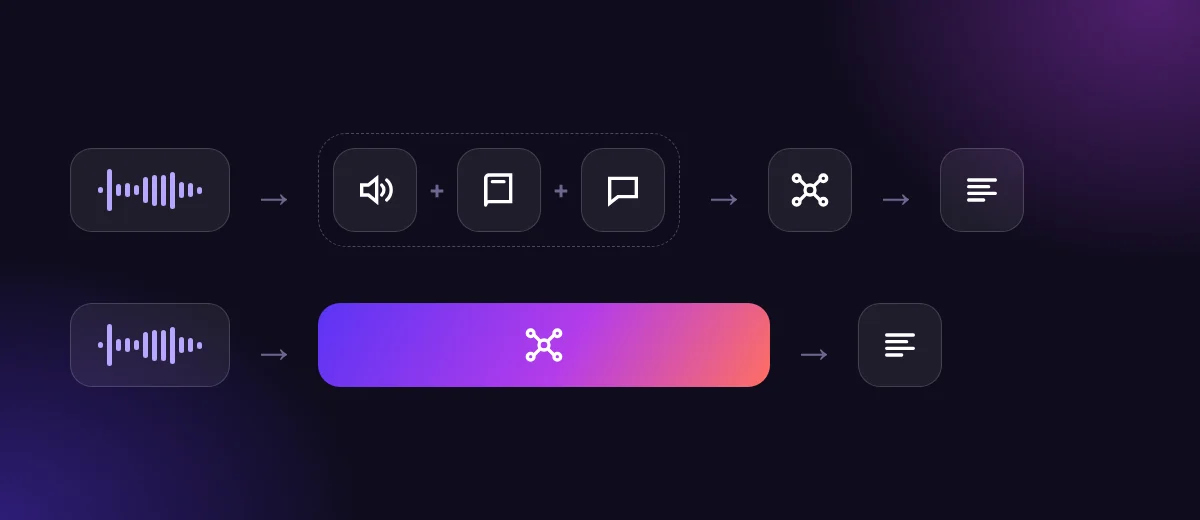
Modèles de bout en bout : un seul réseau du son au texte
Les systèmes modernes apprennent directement à passer du son au texte dans un seul réseau de neurones, entraîné sur d'énormes quantités de parole transcrite. Trois familles sont courantes :
- La CTC (classification temporelle connexionniste) prédit un caractère ou un morceau de mot pour chaque courte trame de son, y compris un symbole « vide » spécial, puis fusionne les répétitions et retire les vides. Personne n'a besoin de marquer où commence chaque mot dans les enregistrements d'entraînement.
- Les modèles encodeur-décodeur à attention transforment d'abord tout l'enregistrement en représentation interne, puis écrivent le texte morceau par morceau en « regardant » les passages utiles du son pour chaque nouveau morceau.
- Les transducteurs (RNN-T et apparentés) associent un encodeur audio à un composant qui se souvient du texte déjà produit, ce qui les rend bien adaptés pour produire du texte pendant que vous parlez encore.
Les produits réels mélangent ces idées, et certains ajoutent des étapes comme des indices de contexte pour les mots rares (voir comment le contexte aide la reconnaissance). Une app de dictée ne dit pas quelle architecture elle utilise, et vous n'en avez pas besoin : ce qui compte, c'est la précision, la rapidité et ce qui arrive à vos données.
Enregistrement complet ou streaming
La reconnaissance peut porter sur l'enregistrement terminé ou se faire en continu pendant que vous parlez :
- Le streaming affiche les mots presque aussitôt, mais les premières hypothèses peuvent changer quand les mots suivants apportent du contexte. « Ils sont arrivés » peut apparaître un instant comme « il sont arrivé » puis se corriger.
- La reconnaissance de l'enregistrement complet attend que vous ayez fini, mais voit toute la phrase d'un coup, ce qui aide souvent la précision et la ponctuation.
Le délai que vous remarquez inclut aussi la détection de la fin de la parole, le temps réseau et l'éventuel nettoyage. Dans SayVelio, vous maintenez la touche pendant que vous parlez : la fin de l'enregistrement est donc exacte, et le texte est inséré une fois définitif, pas mot à mot.
Pourquoi le résultat est une probabilité, pas un fait
Comme le système choisit toujours l'option la plus probable, ses erreurs ont l'air plausibles : un vrai mot, bien écrit, que vous n'avez pas dit. Les noms, les nombres et les termes rares sont les plus exposés, car le modèle les a moins vus. Deux parades pratiques :
- Apprenez vos mots au système avec un dictionnaire personnel.
- Relisez les textes importants avant de les envoyer, surtout les montants, les dates et les « ne… pas ».
Questions fréquentes
La reconnaissance vocale comprend-elle ce que je veux dire ?
Pas au sens humain. Elle estime quels mots ont été prononcés. Le sens n'intervient qu'à travers des régularités apprises dans des textes, qui aident à choisir entre des phrases qui se ressemblent à l'oreille.
Pourquoi ma dictée se trompe-t-elle toujours sur le même mot ?
Souvent parce que le mot est rare ou ressemble à un mot plus courant. L'ajouter à votre dictionnaire, avec sa prononciation en variante, règle la plupart de ces cas.
À lire aussi
 Comment fonctionne la saisie vocale
Comment la reconnaissance vocale apprend, et pourquoi le contexte aide pour les noms et le jargon
Entraînement et usage quotidien, pourquoi les modèles butent sur les noms et accents peu courants, comment les indices de contexte et les dictionnaires guident la reconnaissance, et pourquoi dicter ne veut pas dire que votre voix entraîne le modèle.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
De la transcription brute au texte lisible : ponctuation, nombres et nettoyage
Pourquoi une transcription brute n'est pas prête à envoyer, comment s'ajoutent ponctuation, majuscules, nombres et listes, pourquoi « cinq cinquante » est ambigu, et comment éviter que le nettoyage change votre propos.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
Quelle est la précision de la saisie vocale ? Taux d'erreur, vitesse et vraies limites
Comment on mesure la précision de la reconnaissance vocale (taux d'erreur sur les mots), ce que disent les études sur la vitesse de la dictée face à la frappe, ce qui dégrade les résultats et quels mots toujours vérifier.
MacWindowsiPhoneAndroid