
Reconnaissance vocale et synthèse vocale : quelle différence ?
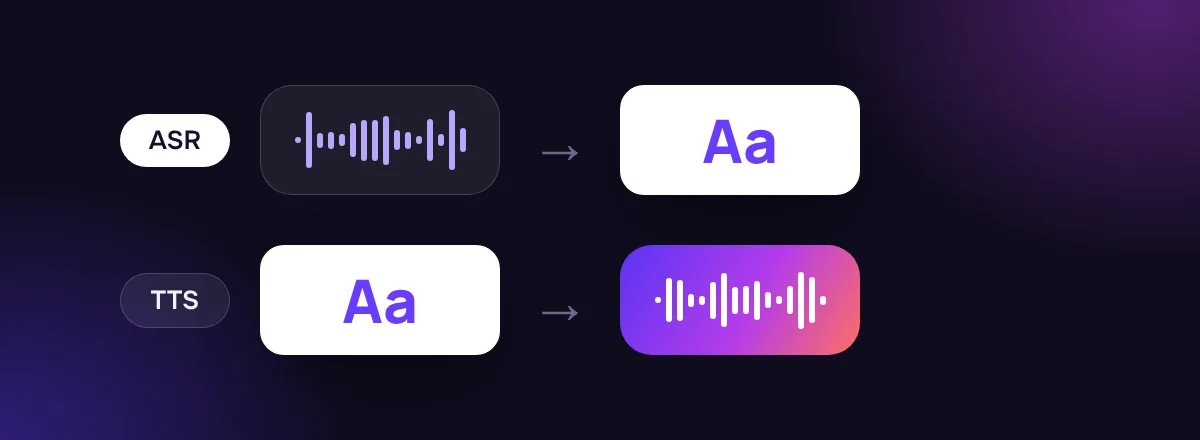
La reconnaissance vocale transforme la voix en texte, la synthèse vocale le texte en voix. Comment fonctionne chacune, où elles se rejoignent (nombres, dates, noms), en quoi les codecs vocaux diffèrent des deux, et pourquoi une app de dictée ne lit pas le texte à voix haute.
En bref
La reconnaissance vocale (ASR) écoute et écrit : du son en entrée, du texte en sortie. La synthèse vocale (TTS) lit et parle : du texte en entrée, du son en sortie. On les trouve souvent ensemble dans les assistants vocaux, mais ce sont des technologies distinctes, avec un entraînement, un résultat et des mesures de qualité différents. Une troisième technologie, le codec vocal, se contente de réduire le son pour le transmettre et ne fait ni l'un ni l'autre.
Vous avez dit
la réunion est décalée au douze à quinze heures trente
SayVelio a écrit
La réunion est décalée au 12 à 15 h 30.
Deux sens opposés
| Reconnaissance vocale (ASR) | Synthèse vocale (TTS) | Codec vocal | |
|---|---|---|---|
| Entrée | Le son d'une personne qui parle | Du texte écrit | Du son |
| Sortie | Du texte | Une voix de synthèse | Le même son, plus léger |
| Question centrale | Quels mots ont été dits ? | Comment ce texte doit-il sonner ? | Comment transmettre ce son efficacement ? |
| Usage typique | Dictée, sous-titres, recherche vocale | Lecteurs d'écran, GPS, livres audio | Appels, messages vocaux |
| Qualité mesurée par | Le taux d'erreur sur les mots | Des notes de naturel et d'intelligibilité | Des tests d'écoute à débit donné |
Un assistant vocal utilise les deux : la reconnaissance pour comprendre votre question, la synthèse pour répondre à voix haute. Mais l'une n'implique pas l'autre. SayVelio est une app de dictée : elle reconnaît la parole et écrit du texte, et ne lit rien à voix haute.
Comment fonctionne la synthèse vocale
Un système TTS typique travaille par étapes :
- Analyse du texte. Développer abréviations et nombres en mots (« St » se lit « saint » ou « Saint-Étienne » ?) et choisir la bonne prononciation des mots qui s'écrivent pareil mais se disent autrement (« les poules du couvent couvent »).
- Prosodie. Décider du rythme, des pauses, de l'accentuation et de la mélodie, pour qu'une question sonne comme une question.
- Modèle acoustique. Prédire comment la voix doit sonner au fil du temps, souvent sous forme de spectrogramme.
- Vocodeur. Transformer cette prédiction en une vraie forme d'onde qu'on peut écouter.
Un exemple connu est Tacotron 2 de Google (2018), qui prédit un spectrogramme mel à partir du texte et utilise un vocodeur neuronal pour produire le son. Beaucoup de systèmes plus récents fusionnent ou réorganisent ces étapes, mais le rôle de chacune demeure.
Les développeurs peuvent piloter la synthèse avec SSML (Speech Synthesis Markup Language), une norme du W3C pour marquer pauses, accentuation, prononciation et lecture des dates et autres. La prise en charge de chaque fonction SSML varie selon les moteurs.
Là où elles se rejoignent : nombres, dates et noms
Les deux sens butent sur les mêmes choses, chacun de son côté :
- La dictée doit transformer « douze cinquante » prononcé en écrit : 12 h 50 ? 1250 ? 12,50 € ? C'est la normalisation inverse du texte, décrite dans de la transcription au texte.
- La synthèse doit transformer « 12/05 » écrit en parole : le douze mai ou le cinq décembre ? C'est la normalisation du texte.
Les deux sont liées sans être des reflets exacts, car la bonne réponse dépend du contexte dans les deux sens. Les noms sont difficiles dans les deux directions : un système de reconnaissance doit savoir comment s'écrit un nom qu'il entend (c'est le rôle du dictionnaire), un synthétiseur comment se prononce un nom qu'il lit.
Les codecs sont une troisième chose, à part
Un codec vocal comme Opus représente avec moins de bits un son qui existe déjà, pour le transmettre ou le stocker. Il ne crée pas de parole à partir de texte et ne décide pas des mots prononcés. Un produit qui transcrit la parole n'a ni à synthétiser de la voix ni à utiliser un codec particulier. Plus de détails dans la compression audio pour la parole.
Toutes deux utilisent l'apprentissage automatique, différemment
L'ASR et la TTS modernes reposent sur des réseaux de neurones et apprennent toutes deux à partir de paires son-texte. Mais leurs objectifs sont opposés : on juge l'ASR sur la justesse des mots, la TTS sur le naturel et la clarté de la voix pour les auditeurs. Un modèle excellent dans un domaine ne sait pas automatiquement faire l'autre.
Questions fréquentes
SayVelio peut-il me lire mon texte ?
Non. SayVelio sert à écrire avec la voix. Pour faire lire un texte, utilisez la fonction intégrée de votre système : Contenu énoncé sur Mac et iPhone, Narrateur sous Windows, Sélectionner pour prononcer sur Android.
« Voix vers texte » et « reconnaissance de la voix », c'est pareil ?
On les emploie souvent comme synonymes, mais au sens strict, la reconnaissance de la voix peut aussi désigner l'identification de qui parle. SayVelio reconnaît ce que vous dites, pas qui vous êtes.
À lire aussi
 Comment fonctionne la saisie vocale
Comment la reconnaissance vocale transforme le son en mots
Pourquoi la parole est difficile pour un ordinateur, comment fonctionnaient les systèmes classiques avec modèles acoustique, de prononciation et de langage, ce que les modèles de bout en bout (CTC, encodeur-décodeur, transducteurs) ont changé, et pourquoi le texte en streaming bouge pendant que vous parlez.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
De la transcription brute au texte lisible : ponctuation, nombres et nettoyage
Pourquoi une transcription brute n'est pas prête à envoyer, comment s'ajoutent ponctuation, majuscules, nombres et listes, pourquoi « cinq cinquante » est ambigu, et comment éviter que le nettoyage change votre propos.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
Formats et compression audio dans la saisie vocale
Audio numérique, encodage et compression sont trois choses distinctes. Comment fonctionnent la compression sans perte et avec perte, pourquoi aucun algorithme ne peut réduire tous les fichiers, comment les codecs vocaux comme Opus arbitrent entre taille et latence, et ce que cela change pour la dictée.
MacWindowsiPhoneAndroid