
Riconoscimento vocale e sintesi vocale: qual è la differenza
Il riconoscimento vocale trasforma la voce in testo, la sintesi vocale il testo in voce. Come funziona ciascuno, dove si incontrano (numeri, date, nomi), in cosa i codec vocali sono diversi da entrambi e perché un'app di dettatura non legge il testo ad alta voce.
In breve
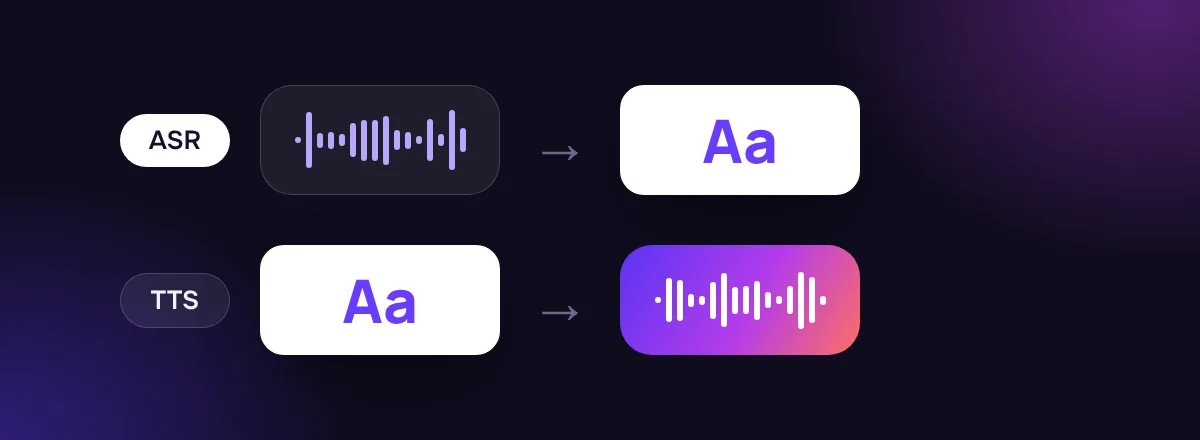
Il riconoscimento vocale (ASR) ascolta e scrive: suono in ingresso, testo in uscita. La sintesi vocale (TTS) legge e parla: testo in ingresso, suono in uscita. Spesso compaiono insieme negli assistenti vocali, ma sono tecnologie distinte, con addestramento, risultato e misure di qualità diversi. Una terza tecnologia, il codec vocale, si limita a ridurre il suono per trasmetterlo e non fa né l'una né l'altra cosa.
Hai detto
la riunione è spostata al dodici alle quindici e trenta
SayVelio ha scritto
La riunione è spostata al 12 alle 15:30.
Due direzioni opposte
| Riconoscimento vocale (ASR) | Sintesi vocale (TTS) | Codec vocale | |
|---|---|---|---|
| Ingresso | Il suono di una persona che parla | Testo scritto | Suono |
| Uscita | Testo | Una voce sintetica | Lo stesso suono, più leggero |
| Domanda centrale | Quali parole sono state dette? | Come deve suonare questo testo? | Come trasmettere questo suono in modo efficiente? |
| Uso tipico | Dettatura, sottotitoli, ricerca vocale | Lettori di schermo, navigatori, audiolibri | Chiamate, messaggi vocali |
| Qualità misurata con | Il tasso di errore sulle parole | Punteggi di naturalezza e intelligibilità | Test d'ascolto a un dato bitrate |
Un assistente vocale li usa entrambi: il riconoscimento per capire la tua domanda, la sintesi per rispondere ad alta voce. Ma l'uno non implica l'altro. SayVelio è un'app di dettatura: riconosce il parlato e scrive testo, e non legge nulla ad alta voce.
Come funziona la sintesi vocale
Un tipico sistema TTS lavora per fasi:
- Analisi del testo. Espandere abbreviazioni e numeri in parole («S.» si legge «San» o «Santo»?) e scegliere la pronuncia giusta delle parole che si scrivono uguali ma si dicono diversamente («àncora» o «ancóra»).
- Prosodia. Decidere ritmo, pause, accenti e intonazione, perché una domanda suoni come una domanda.
- Modello acustico. Prevedere come deve suonare la voce nel tempo, spesso sotto forma di spettrogramma.
- Vocoder. Trasformare quella previsione in una vera forma d'onda da ascoltare.
Un esempio noto è Tacotron 2 di Google (2018), che prevede uno spettrogramma mel a partire dal testo e usa un vocoder neurale per produrre il suono. Molti sistemi più recenti uniscono o riorganizzano queste fasi, ma il ruolo di ciascuna resta.
Gli sviluppatori possono guidare la sintesi con SSML (Speech Synthesis Markup Language), uno standard del W3C per indicare pause, enfasi, pronuncia e lettura di date e altro. Il supporto delle singole funzioni SSML varia da motore a motore.
Dove si incontrano: numeri, date e nomi
Entrambe le direzioni inciampano sulle stesse cose, ognuna dal proprio lato:
- La dettatura deve trasformare «dodici e cinquanta» pronunciato in scritto: 12:50? 1250? 12,50 €? È la normalizzazione inversa del testo, descritta in dalla trascrizione al testo.
- La sintesi deve trasformare «12/05» scritto in parlato: il dodici maggio o il cinque dicembre? È la normalizzazione del testo.
Le due sono collegate senza essere l'una lo specchio esatto dell'altra, perché in entrambe le direzioni la risposta giusta dipende dal contesto. I nomi sono difficili in tutti e due i sensi: un sistema di riconoscimento deve sapere come si scrive un nome che sente (è il compito del dizionario), un sintetizzatore come si pronuncia un nome che legge.
I codec sono una terza cosa, a parte
Un codec vocale come Opus rappresenta con meno bit un suono che esiste già, per trasmetterlo o salvarlo. Non crea parlato dal testo e non decide quali parole sono state dette. Un prodotto che trascrive il parlato non deve né sintetizzare voce né usare un codec particolare. Più dettagli in compressione audio per il parlato.
Entrambi usano l'apprendimento automatico, in modo diverso
ASR e TTS moderni si basano su reti neurali e imparano entrambi da coppie di suono e testo. Ma i loro obiettivi sono opposti: l'ASR si giudica dalla correttezza delle parole, il TTS dalla naturalezza e chiarezza della voce per chi ascolta. Un modello eccellente in un campo non sa fare automaticamente l'altro.
Domande frequenti
SayVelio può leggermi il testo?
No. SayVelio serve a scrivere con la voce. Per farti leggere un testo usa la funzione integrata del sistema: Contenuto letto ad alta voce su Mac e iPhone, Assistente vocale su Windows, Seleziona per ascoltare su Android.
«Da voce a testo» e «riconoscimento della voce» sono la stessa cosa?
Spesso si usano come sinonimi, ma in senso stretto il riconoscimento della voce può indicare anche l'identificazione di chi parla. SayVelio riconosce cosa dici, non chi sei.
Leggi anche
 Come funziona la dettatura vocale
Come il riconoscimento vocale trasforma il suono in parole
Perché il parlato è difficile per un computer, come funzionavano i riconoscitori classici con modelli acustici, di pronuncia e linguistici, cosa hanno cambiato i modelli end-to-end (CTC, encoder-decoder, transducer) e perché il testo in streaming può cambiare mentre parli.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Dalla trascrizione grezza al testo leggibile: punteggiatura, numeri e pulizia
Perché una trascrizione grezza non è pronta da inviare, come si aggiungono punteggiatura, maiuscole, numeri ed elenchi, perché «cinque e cinquanta» è ambiguo e come evitare che la pulizia cambi il significato.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Formati audio e compressione nella dettatura vocale
Audio digitale, codifica e compressione sono tre cose diverse. Come funzionano la compressione senza perdita e con perdita, perché nessun algoritmo può ridurre ogni file, come i codec vocali come Opus bilanciano dimensione e ritardo e cosa significa per la dettatura.
MacWindowsiPhoneAndroid