
Come il riconoscimento vocale trasforma il suono in parole
Perché il parlato è difficile per un computer, come funzionavano i riconoscitori classici con modelli acustici, di pronuncia e linguistici, cosa hanno cambiato i modelli end-to-end (CTC, encoder-decoder, transducer) e perché il testo in streaming può cambiare mentre parli.
In breve
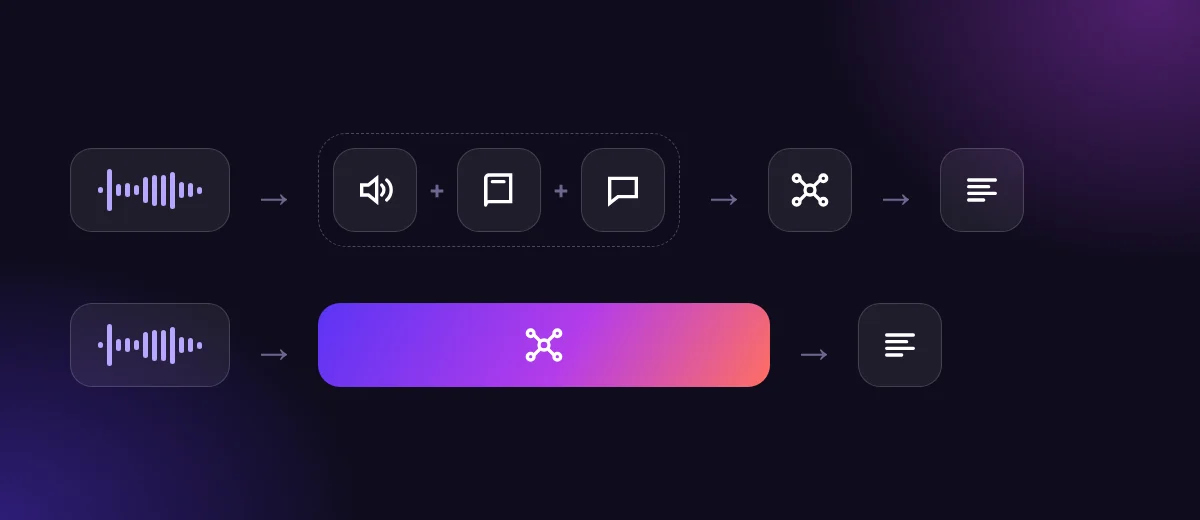
Nel parlato non ci sono pause nette tra le parole e ognuno pronuncia a modo suo, quindi un riconoscitore non «legge» mai le parole dall'audio. Stima la sequenza di parole più probabile in base al suono e agli schemi appresi durante l'addestramento. I sistemi più vecchi usavano modelli separati per acustica, pronuncia e lingua; la maggior parte di quelli moderni impara l'intero percorso dall'audio al testo in un'unica rete.
Hai detto
l'ho visto ieri con lo zio e la zia di marco
SayVelio ha scritto
L'ho visto ieri con lo zio e la zia di Marco.
Perché riconoscere il parlato è difficile
Il testo scritto ha gli spazi tra le parole. Il parlato no. Quando dici «l'ago», i suoni si fondono, e «lago» suona quasi uguale. I suoni cambiano anche a seconda di quelli vicini, le persone parlano a velocità e altezze diverse e gli accenti colorano ogni vocale.
Così lo stesso tratto di audio può corrispondere a più sequenze di parole. Un riconoscitore non decodifica le parole con certezza: soppesa le alternative e sceglie la più probabile. Per questo un risultato può leggersi benissimo ed essere comunque sbagliato.
L'approccio classico: tre modelli e un decodificatore
Per decenni il riconoscimento vocale è stato costruito con parti separate:
- Un modello acustico collegava brevi frammenti di audio ai suoni del parlato (fonemi).
- Un dizionario di pronuncia elencava come si può pronunciare ogni parola come sequenza di quei suoni.
- Un modello linguistico valutava quanto è probabile una sequenza di parole nella lingua («sono andato al lago» è molto più probabile di «sono andato all'ago»).
- Un decodificatore cercava tra le combinazioni quella che si adattava meglio nel complesso.
Questo schema resta il modo più chiaro per capire il problema, e alcuni sistemi ne usano ancora delle parti. Ma non è così che funziona la maggior parte dei riconoscitori moderni.
Modelli end-to-end: una sola rete dall'audio al testo
I sistemi moderni imparano una corrispondenza diretta tra audio e testo in un'unica rete neurale, addestrata su enormi quantità di parlato trascritto. Le famiglie più comuni sono tre:
- CTC (connectionist temporal classification) prevede un carattere o un pezzo di parola per ogni breve frammento di audio, compreso un simbolo speciale «vuoto», poi unisce le ripetizioni e toglie i vuoti. Non serve che qualcuno segni dove inizia ogni parola nell'audio di addestramento.
- I modelli encoder-decoder con attenzione trasformano prima l'intera registrazione in una rappresentazione interna, poi scrivono il testo un pezzo alla volta, «guardando indietro» alle parti rilevanti dell'audio per ogni pezzo successivo.
- I transducer (RNN-T e simili) uniscono un codificatore dell'audio a un componente che ricorda il testo già prodotto, il che li rende adatti a scrivere mentre stai ancora parlando.
I prodotti reali mescolano queste idee, e alcuni aggiungono passaggi come suggerimenti di contesto per le parole rare (vedi come il contesto aiuta il riconoscimento). Un'app di dettatura non ti dice quale architettura usa, e non ne ha bisogno: a te interessano precisione, velocità e cosa succede ai tuoi dati.
Registrazione intera o streaming
Il riconoscimento può lavorare sulla registrazione completa quando ti fermi, oppure di continuo mentre parli:
- Lo streaming mostra le parole quasi subito, ma le prime ipotesi possono cambiare quando le parole successive aggiungono contesto. «All'ago» può comparire per un attimo e poi correggersi in «al lago».
- Il riconoscimento della registrazione intera aspetta che tu abbia finito, ma vede tutta la frase in una volta, il che spesso aiuta precisione e punteggiatura.
Il ritardo che percepisci comprende anche il tempo per capire che hai smesso di parlare, la rete ed eventuale pulizia. In SayVelio tieni premuto il tasto mentre parli, quindi la fine della registrazione è esatta, e il testo viene inserito quando è definitivo, non parola per parola.
Perché il risultato è una probabilità, non un fatto
Siccome il sistema sceglie sempre l'opzione più probabile, i suoi errori sembrano plausibili: una parola vera, scritta correttamente, che però non hai detto. Nomi, numeri e termini rari sono i più a rischio, perché il modello li ha visti meno spesso. Due difese pratiche:
- Insegna al sistema le tue parole con un dizionario personale.
- Rileggi i testi importanti prima di inviarli, soprattutto importi, date e «non».
Domande frequenti
Il riconoscimento vocale capisce cosa intendo?
Non nel senso umano. Stima quali parole sono state dette. Il significato entra solo attraverso schemi appresi dai testi, che lo aiutano a scegliere tra frasi dal suono simile.
Perché la dettatura sbaglia sempre la stessa parola?
Di solito perché la parola è rara o suona come una più comune. Aggiungerla al dizionario, con il modo in cui suona come variante, risolve la maggior parte di questi casi.
Leggi anche
 Come funziona la dettatura vocale
Come impara il riconoscimento vocale e perché il contesto aiuta con nomi e gergo
Addestramento e uso quotidiano, perché i modelli faticano con nomi poco noti e accenti, come suggerimenti di contesto e dizionari orientano il riconoscimento e perché dettare non significa addestrare il modello con la tua voce.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Dalla trascrizione grezza al testo leggibile: punteggiatura, numeri e pulizia
Perché una trascrizione grezza non è pronta da inviare, come si aggiungono punteggiatura, maiuscole, numeri ed elenchi, perché «cinque e cinquanta» è ambiguo e come evitare che la pulizia cambi il significato.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Quanto è precisa la dettatura vocale? Tasso di errore, velocità e limiti reali
Come si misura la precisione del riconoscimento vocale (tasso di errore sulle parole), cosa dicono gli studi sulla velocità della dettatura rispetto alla digitazione, cosa peggiora i risultati e quali parole controllare sempre.
MacWindowsiPhoneAndroid