
Как распознавание речи превращает звук в слова
Почему речь трудна для компьютера, как работали классические распознаватели с акустической, произносительной и языковой моделями, что изменили сквозные модели (CTC, кодер-декодер, трансдьюсеры) и почему текст при потоковом распознавании меняется на ходу.
Коротко
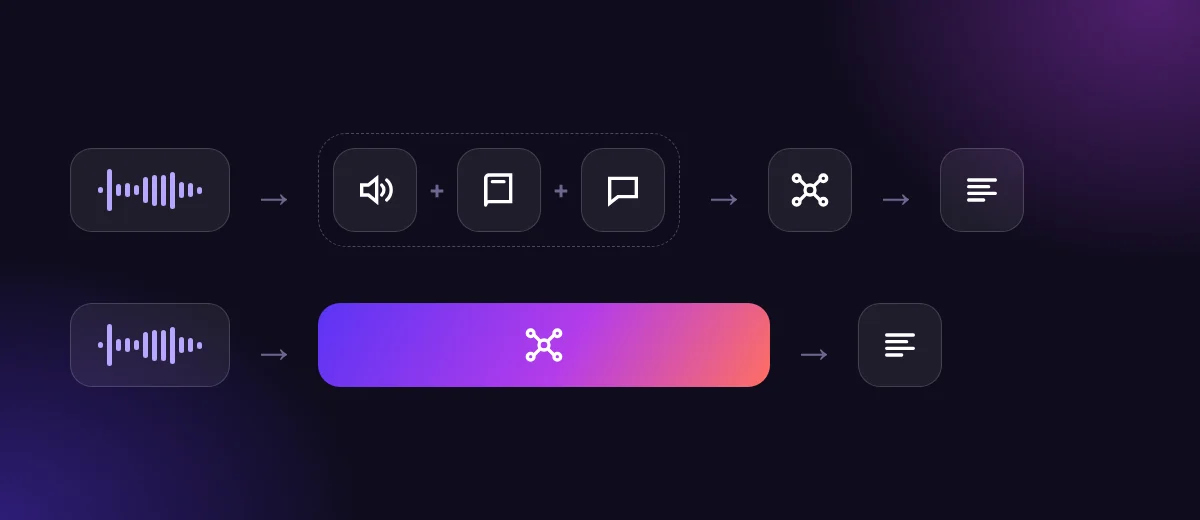
В речи нет чётких пауз между словами, и все произносят их по-разному, поэтому распознаватель никогда не «считывает» слова со звука. Он оценивает наиболее вероятную последовательность слов по звуку и по закономерностям, выученным на обучающих данных. Старые системы состояли из отдельных акустической, произносительной и языковой моделей; большинство современных проходят весь путь от звука до текста в одной нейросети.
Вы сказали
мы встретимся у моста или у мостика где кафе
SayVelio напечатал
Мы встретимся у моста или у мостика, где кафе?
Почему распознавать речь трудно
В письменном тексте между словами есть пробелы. В речи их нет. Звуки сливаются: «у моста» и «умоста» звучат одинаково, а «в Ольгу» и «вольгу» — почти одинаково. Звуки меняются в зависимости от соседей, люди говорят с разной скоростью и высотой голоса, а акцент меняет каждую гласную.
Поэтому один и тот же кусок звука может подходить к нескольким вариантам слов. Распознаватель не расшифровывает слова с уверенностью: он взвешивает варианты и выбирает самый вероятный. Поэтому результат может читаться гладко и всё равно быть неверным.
Классический подход: три модели и декодер
Десятилетиями распознавание речи собирали из отдельных частей:
- Акустическая модель связывала короткие кусочки звука со звуками речи (фонемами).
- Словарь произношений описывал, как каждое слово может звучать в виде цепочки таких звуков.
- Языковая модель оценивала, насколько вероятна последовательность слов в языке («встретимся у моста» гораздо вероятнее, чем «встретимся умоста»).
- Декодер перебирал комбинации и искал лучшее общее совпадение.
Эта схема по-прежнему лучше всего объясняет задачу, и некоторые системы используют её части. Но большинство современных распознавателей устроены иначе.
Сквозные модели: одна сеть от звука до текста
Современные системы учатся напрямую переводить звук в текст в одной нейросети, обученной на огромном количестве расшифрованной речи. Есть три распространённых семейства:
- CTC (connectionist temporal classification) предсказывает символ или кусочек слова для каждого короткого кадра звука, включая специальный «пустой» символ, затем склеивает повторы и убирает пустые. Ей не нужно, чтобы кто-то размечал, где в обучающей записи начинается каждое слово.
- Кодер-декодер с механизмом внимания сначала превращает всю запись во внутреннее представление, а потом пишет текст кусочек за кусочком, «оглядываясь» на нужные места звука для каждого следующего кусочка.
- Трансдьюсеры (RNN-T и похожие) сочетают кодер звука с компонентом, который помнит уже написанный текст. Поэтому они хорошо подходят, чтобы выдавать текст, пока вы ещё говорите.
Реальные продукты смешивают эти идеи, а некоторые добавляют дополнительные шаги, например подсказки для редких слов (см. как контекст помогает распознаванию). По приложению с диктовкой не видно, какая архитектура внутри, и вам это не нужно: важны точность, скорость и то, что происходит с вашими данными.
Вся запись целиком или потоком
Распознавание может работать по готовой записи, когда вы закончили, или непрерывно, пока вы говорите:
- Потоковое распознавание показывает слова почти сразу, но ранние догадки могут меняться, когда следующие слова добавляют контекст. «Удобно ли» может на мгновение появиться как «у Добнали» и тут же исправиться.
- Распознавание целой записи ждёт, пока вы закончите, но видит всю фразу сразу, что часто помогает точности и пунктуации.
Задержка, которую вы замечаете, включает ещё определение конца речи, время сети и этап обработки, если он есть. В SayVelio вы держите клавишу, пока говорите, поэтому конец записи точный, а текст вставляется, когда он окончательный, а не по слову.
Почему результат — вероятность, а не факт
Система всегда выбирает самый вероятный вариант, поэтому её ошибки выглядят правдоподобно: настоящее, правильно написанное слово, которое вы не говорили. Больше всего рискуют имена, числа и редкие термины, потому что модель видела их реже. Две практические защиты:
- Научите систему своим словам с помощью личного словаря.
- Перечитывайте важный текст перед отправкой, особенно суммы, даты и «не».
Частые вопросы
Понимает ли распознавание речи, что я имею в виду?
Не в человеческом смысле. Оно оценивает, какие слова были сказаны. Смысл участвует только через закономерности, выученные из текстов, и помогает выбирать между похоже звучащими фразами.
Почему диктовка каждый раз ошибается в одном и том же слове?
Обычно потому, что слово редкое или похоже на более частое. Добавьте его в словарь вместе с вариантом того, как оно звучит, — это исправляет большинство таких случаев.
Похожие материалы
 Как устроен голосовой ввод
Как учится распознавание речи и почему контекст помогает с именами и жаргоном
Обучение и повседневное использование, почему модели путаются в незнакомых именах и акцентах, как подсказки и словари направляют распознавание и почему диктовка не означает, что ваш голос обучает модель.
MacWindowsiPhoneAndroid Как устроен голосовой ввод
От сырой расшифровки к читаемому тексту: пунктуация, числа и обработка
Почему сырую расшифровку речи нельзя сразу отправлять, как добавляются знаки препинания, заглавные буквы, числа и списки, почему «пять пятьдесят» неоднозначно и как не дать обработке изменить смысл.
MacWindowsiPhoneAndroid Как устроен голосовой ввод
Насколько точен голосовой ввод? Доля ошибок в словах, скорость и реальные ограничения
Как измеряют точность распознавания речи (WER), что говорят исследования о скорости диктовки по сравнению с набором, что ухудшает результат и какие слова всегда стоит перепроверять.
MacWindowsiPhoneAndroid