
音声認識が音を言葉に変えるしくみ
話し言葉がコンピューターにとって難しい理由、音響モデル・発音辞書・言語モデルを組み合わせた従来の認識器のしくみ、エンドツーエンドのモデル(CTC、エンコーダー・デコーダー、トランスデューサー)がもたらした変化、そして話している途中で文字が変わる理由を解説します。
要点
話し言葉には単語の間のはっきりした区切りがなく、人によって発音も違うので、認識器が音から単語を「読み取る」ことはありません。音と、学習で覚えたパターンから、最もありそうな単語の並びを推定します。以前のシステムは音響・発音・言語を別々のモデルで扱っていましたが、今のシステムの多くは、音声から文字までの道のり全体を 1 つのネットワークで学習します。
話した内容
えー 明日の会議は 10 時からに変更になりました よろしくお願いします
SayVelio の入力結果
明日の会議は 10 時からに変更になりました。よろしくお願いします。
音声認識が難しい理由
日本語の文章には単語の間に空白がありませんが、漢字やかなが区切りの手がかりになります。話し言葉にはその手がかりもありません。「きしゃのきしゃがきしゃできしゃした」は、「貴社の記者が汽車で帰社した」と書くまで意味が定まりません。音は前後の音で変わり、人によって話す速さや声の高さが違い、方言やなまりは母音の響きまで変えます。
つまり、同じ音の区間がいくつもの単語の並びに当てはまりうるのです。認識器は単語を確実に解読しているのではなく、候補を比べて最もありそうなものを選んでいます。だからこそ、自然に読めるのに間違っている結果が生まれます。
従来の方式:3 つのモデルとデコーダー
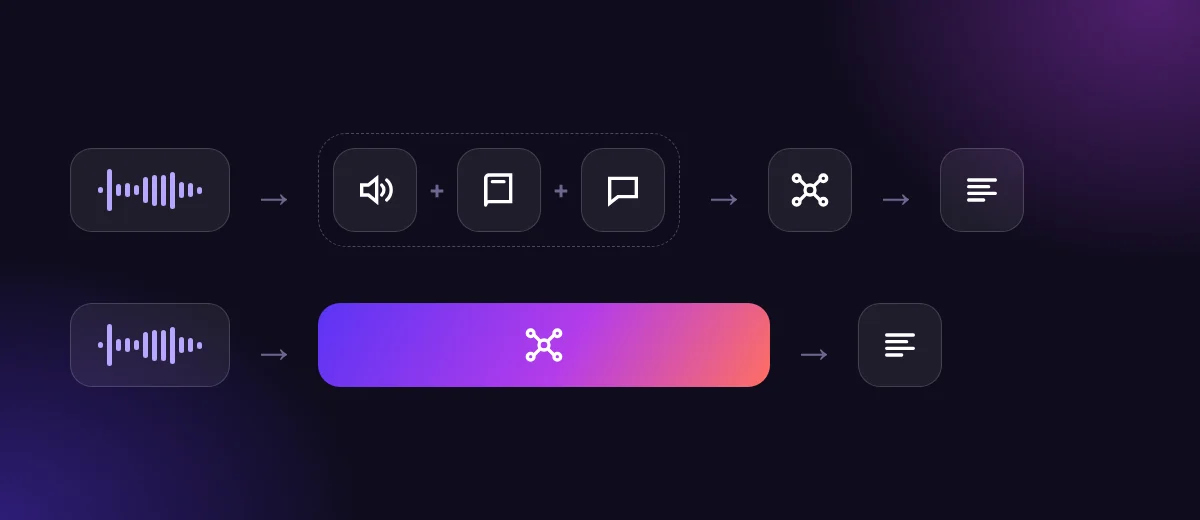
何十年もの間、音声認識は別々の部品で作られていました。
- 音響モデル が、短い音の断片を話し言葉の音(音素)に結びつける。
- 発音辞書 が、各単語がそれらの音のどんな並びで発音されうるかを列挙する。
- 言語モデル が、ある単語の並びがその言語でどれくらいありそうかを評価する(「会議の資料を送ります」は「会議の視療を送ります」よりはるかにありそう)。
- デコーダー が組み合わせを探し、全体として最もよく合うものを見つける。
この設計は今でも問題を理解するいちばん分かりやすい方法で、一部を使っているシステムもあります。ただ、最近の認識器の多くはこのしくみでは動いていません。
エンドツーエンドのモデル:音声から文字まで 1 つのネットワーク
今のシステムは、文字起こし済みの大量の音声で学習した 1 つのニューラルネットワークで、音声から文字への対応を直接学びます。よくある系統は 3 つです。
- CTC(connectionist temporal classification) は、短い音のフレームごとに文字や単語の断片を予測し、特別な「空白」記号も使います。その後、繰り返しをまとめて空白を取り除きます。学習用の音声で各単語の始まりに印を付ける必要がありません。
- アテンション付きのエンコーダー・デコーダー は、まず録音全体を内部の表現に変え、それから文字を少しずつ書き出します。次の部分を書くたびに、音声の関係する部分を「振り返って」見ます。
- トランスデューサー(RNN-T など) は、音声のエンコーダーと、これまでに出した文字を覚えておく部品を組み合わせたものです。話している最中に文字を出すのに向いています。
実際の製品はこれらの考え方を混ぜて使い、珍しい言葉のための文脈ヒントのような段階を加えるものもあります(文脈が認識を助けるしくみを参照)。音声入力アプリはどの構造を使っているかを明かしませんし、明かす必要もありません。あなたにとって大切なのは、精度、速さ、そしてデータがどう扱われるかです。
録音全体か、ストリーミングか
認識は、話し終えたあとに録音全体に対して行うことも、話している間に続けて行うこともできます。
- ストリーミング はほぼすぐに文字を表示しますが、後に続く言葉が文脈を加えると、最初の推測が変わることがあります。「汽車」と一瞬表示されてから「記者」に直る、といったことです。
- 録音全体の認識 は話し終わるまで待ちますが、文全体を一度に見られるので、精度や句読点の面で有利なことが多いです。
体感する待ち時間には、話し終わりの判定、ネットワーク、そして整形がある場合はその時間も含まれます。SayVelio では話している間キーを押し続けるので、録音の終わりは正確で、文字は 1 語ずつではなく確定してから入力されます。
結果が事実ではなく確率である理由
システムは常に最もありそうな候補を選ぶので、間違いももっともらしく見えます。正しく書かれた実在の言葉なのに、あなたは言っていない、という形です。名前、数字、珍しい用語は、モデルが目にした回数が少ないので、特に間違えやすくなります。実用的な対策は 2 つです。
- 個人の辞書で自分の言葉をシステムに教える。
- 大事な文章は送る前に読み返す。特に金額、日付、「ない」などの否定に注意する。
よくある質問
音声認識は私の言いたいことを理解していますか?
人間のような意味では理解していません。どの言葉が話されたかを推定しています。意味は、文章から学んだパターンを通してのみ入ってきて、似た音の言い回しの中から選ぶ助けになっています。
いつも同じ言葉を間違えるのはなぜですか?
たいていは、その言葉が珍しいか、もっとよく使われる言葉に音が似ているからです。辞書に追加し、聞こえ方をバリエーションとして登録すると、ほとんどの場合は解決します。
関連記事
 音声入力のしくみ
音声認識はどう学ぶのか、そして文脈が名前や専門用語に効く理由
学習と普段の利用の違い、モデルがなじみのない名前やなまりに弱い理由、文脈ヒントや辞書が認識を導くしくみ、そして音声入力をしても自分の声でモデルが学習されるわけではない理由を解説します。
MacWindowsiPhoneAndroid 音声入力のしくみ
認識結果から読める文章へ:句読点、数字、整形
音声認識の生の結果がそのまま送れない理由、句読点・数字・リストが加わるしくみ、「ごじはん」があいまいな理由、そして整形で意味が変わらないようにする方法を解説します。
MacWindowsiPhoneAndroid 音声入力のしくみ
音声入力はどれくらい正確か:誤り率、速さ、本当の限界
音声認識の精度の測り方(単語誤り率)、音声入力とタイピングの速さについて研究が示していること、結果を悪くする要因、そして必ず確認すべき言葉を解説します。
MacWindowsiPhoneAndroid