
Konuşma tanıma sesi nasıl kelimelere dönüştürür
Konuşma bilgisayar için neden zordur, akustik, telaffuz ve dil modelleriyle çalışan klasik tanıyıcılar nasıl işlerdi, uçtan uca modeller (CTC, encoder-decoder, transducer) neyi değiştirdi ve akış halindeki metin sen konuşurken neden değişebilir.
Kısaca
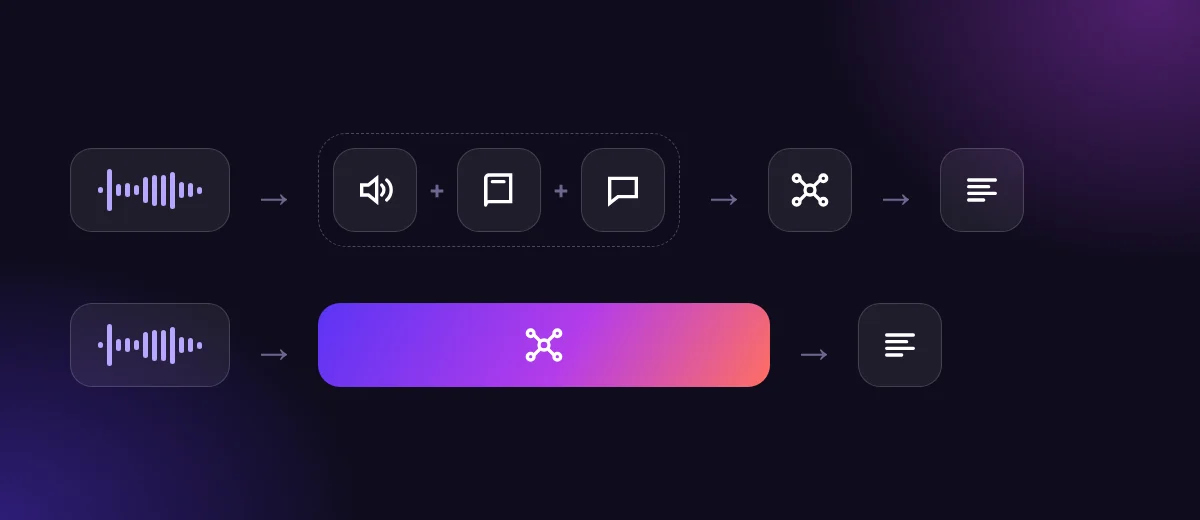
Konuşmada kelimeler arasında net boşluklar yoktur ve herkes farklı telaffuz eder, bu yüzden bir tanıyıcı kelimeleri sesten asla "okumaz". Sese ve eğitimde öğrendiği örüntülere bakarak en olası kelime dizisini tahmin eder. Eski sistemler akustik, telaffuz ve dil için ayrı modeller kullanırdı; modern sistemlerin çoğu sesten metne tüm yolu tek bir ağda öğrenir.
Söylediğin
yarın akşam yemeğe geliyor musun yoksa işte misin
SayVelio'nun yazdığı
Yarın akşam yemeğe geliyor musun, yoksa işte misin?
Konuşmayı tanımak neden zor
Yazılı metinde kelimeler arasında boşluk vardır. Konuşmada yoktur. "Ne de olsa" dediğinde sesler birbirine karışır ve "nede olsa" ile neredeyse aynı duyulur. Sesler komşularına göre değişir, insanlar farklı hızlarda ve perdelerde konuşur, ağızlar her ünlüyü şekillendirir.
Böylece aynı ses parçası birkaç kelime dizisine uyabilir. Bir tanıyıcı kelimeleri kesinlikle çözmez: seçenekleri tartar ve en olasısını seçer. Bu yüzden bir sonuç gayet düzgün okunup yine de yanlış olabilir.
Klasik yaklaşım: üç model ve bir kod çözücü
Onlarca yıl boyunca konuşma tanıma ayrı parçalardan kuruldu:
- Bir akustik model kısa ses dilimlerini konuşma seslerine (fonemlere) bağlardı.
- Bir telaffuz sözlüğü her kelimenin bu seslerin dizisi olarak nasıl söylenebileceğini listelerdi.
- Bir dil modeli bir kelime dizisinin dilde ne kadar olası olduğunu puanlardı (aynı sesi veren iki yazımdan "hâlâ bekliyorum", "hala bekliyorum"dan çok daha olasıdır).
- Bir kod çözücü genel olarak en iyi eşleşmeyi bulmak için kombinasyonlar arasında arama yapardı.
Bu tasarım sorunu anlamanın hâlâ en açık yoludur ve bazı sistemler parçalarını kullanır. Ama modern tanıyıcıların çoğu böyle çalışmaz.
Uçtan uca modeller: sesten metne tek ağ
Modern sistemler, büyük miktarda yazıya dökülmüş konuşmayla eğitilmiş tek bir sinir ağında sesten metne doğrudan bir eşleme öğrenir. Üç yaygın aile vardır:
- CTC (connectionist temporal classification) her kısa ses karesi için özel bir "boş" sembolü de dahil olmak üzere bir karakter ya da kelime parçası tahmin eder, sonra tekrarları birleştirip boşlukları çıkarır. Eğitim sesinde her kelimenin nerede başladığını birinin işaretlemesi gerekmez.
- Dikkat tabanlı encoder-decoder modelleri önce kaydın tamamını içsel bir temsile dönüştürür, sonra metni parça parça yazar ve her yeni parça için sesin ilgili kısımlarına "geri bakar".
- Transducer'lar (RNN-T ve benzerleri) bir ses kodlayıcısını şimdiye kadar üretilen metni hatırlayan bir bileşenle birleştirir; bu da onları sen hâlâ konuşurken metin üretmeye uygun kılar.
Gerçek ürünler bu fikirleri karıştırır, bazıları da nadir kelimeler için bağlam ipuçları gibi ek adımlar ekler (bkz. bağlam tanımaya nasıl yardım eder). Dikte sunan bir uygulama hangi mimariyi kullandığını söylemez, söylemesi de gerekmez: senin için önemli olan doğruluk, hız ve verine ne olduğudur.
Tüm kayıt mı, akış mı
Tanıma, sen durduktan sonra tam kayıt üzerinde ya da sen konuşurken sürekli çalışabilir:
- Akış (streaming) kelimeleri neredeyse anında gösterir, ama sonraki kelimeler bağlam ekledikçe ilk tahminler değişebilir. Önce "hala" görünüp ardından "bekliyorum" gelince "hâlâ" diye düzelebilir.
- Tüm kaydın tanınması bitirmeni bekler, ama cümlenin tamamını bir kerede görür; bu da çoğu zaman doğruluğa ve noktalamaya yardımcı olur.
Fark ettiğin gecikmeye durduğunu algılama süresi, ağ ve varsa düzenleme adımı da dahildir. SayVelio'da konuşurken tuşu basılı tutarsın, yani kaydın sonu kesindir ve metin kelime kelime değil, son hali hazır olduğunda eklenir.
Sonuç neden bir olasılıktır, gerçek değil
Sistem her zaman en olası seçeneği seçtiği için hataları akla yatkın görünür: doğru yazılmış, gerçek ama senin söylemediğin bir kelime. İsimler, sayılar ve nadir terimler en çok risk altındadır, çünkü model onları daha az görmüştür. İki pratik savunma:
- Kelimelerini sisteme bir kişisel sözlükle öğret.
- Önemli metinleri göndermeden önce oku, özellikle tutarları, tarihleri ve olumsuzlukları.
Sorular
Konuşma tanıma ne demek istediğimi anlar mı?
İnsani anlamda değil. Hangi kelimelerin söylendiğini tahmin eder. Anlam yalnızca metinlerden öğrenilmiş örüntüler yoluyla girer; bu da benzer duyulan ifadeler arasında seçim yapmasına yardımcı olur.
Dikte neden her seferinde aynı kelimeyi yanlış yazıyor?
Genellikle kelime nadir olduğu ya da daha yaygın bir kelimeye benzediği için. Onu sözlüğe, nasıl duyulduğunu da bir varyant olarak ekleyerek eklemek bu durumların çoğunu çözer.
İlgili yazılar
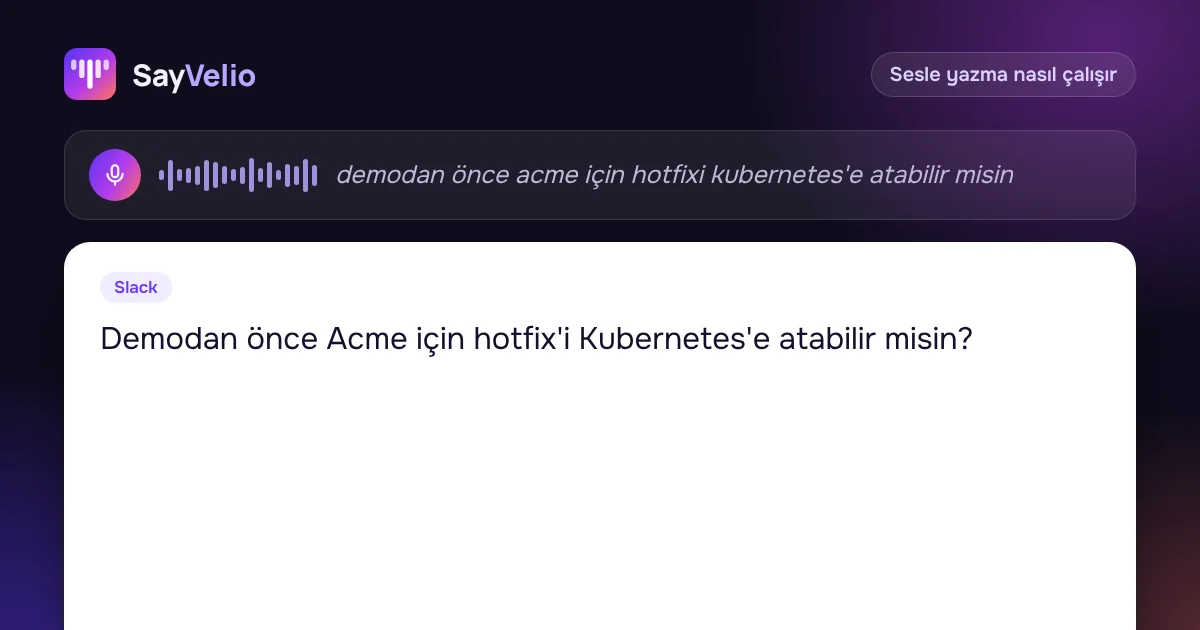 Sesle yazma nasıl çalışır
Konuşma tanıma nasıl öğrenir ve bağlam isimlerde ve jargonda neden yardımcı olur
Eğitim ve günlük kullanım, modellerin tanıdık olmayan isimler ve ağızlarla neden zorlandığı, bağlam ipuçlarının ve sözlüklerin tanımayı nasıl yönlendirdiği ve dikte etmenin modeli sesinle eğitmek anlamına neden gelmediği.
MacWindowsiPhoneAndroid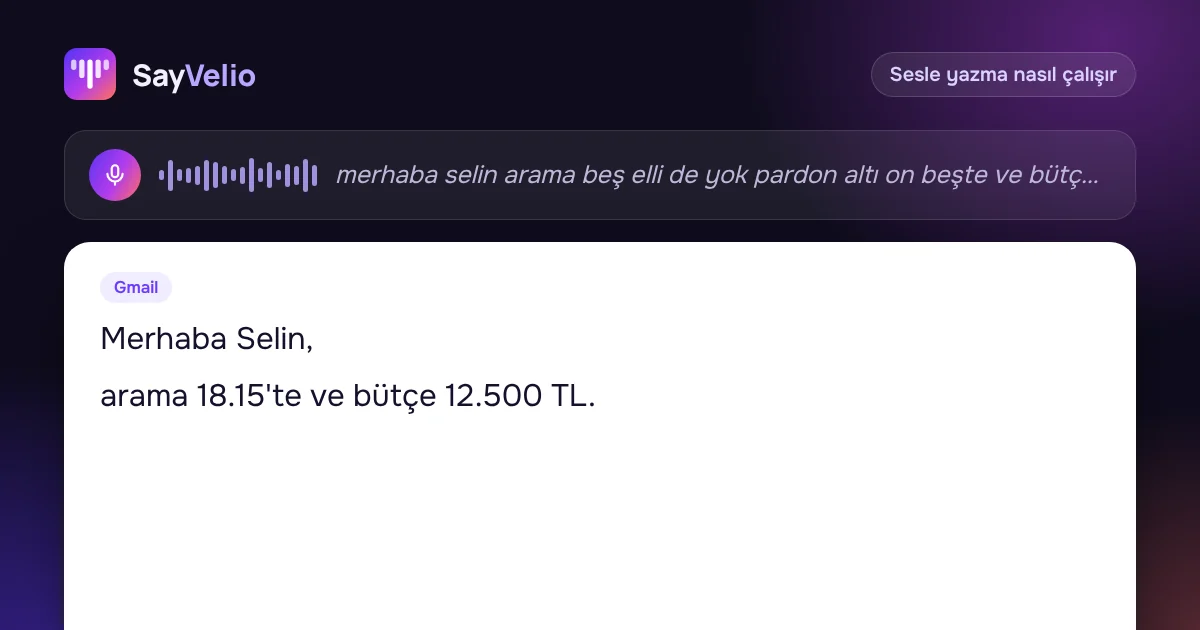 Sesle yazma nasıl çalışır
Ham dökümden okunur metne: noktalama, sayılar ve düzenleme
Ham bir konuşma dökümü neden gönderilmeye hazır değildir, noktalama, büyük harfler, sayılar ve listeler nasıl eklenir, "beş elli" neden belirsizdir ve bir düzenleme adımının anlamını değiştirmesi nasıl önlenir.
MacWindowsiPhoneAndroid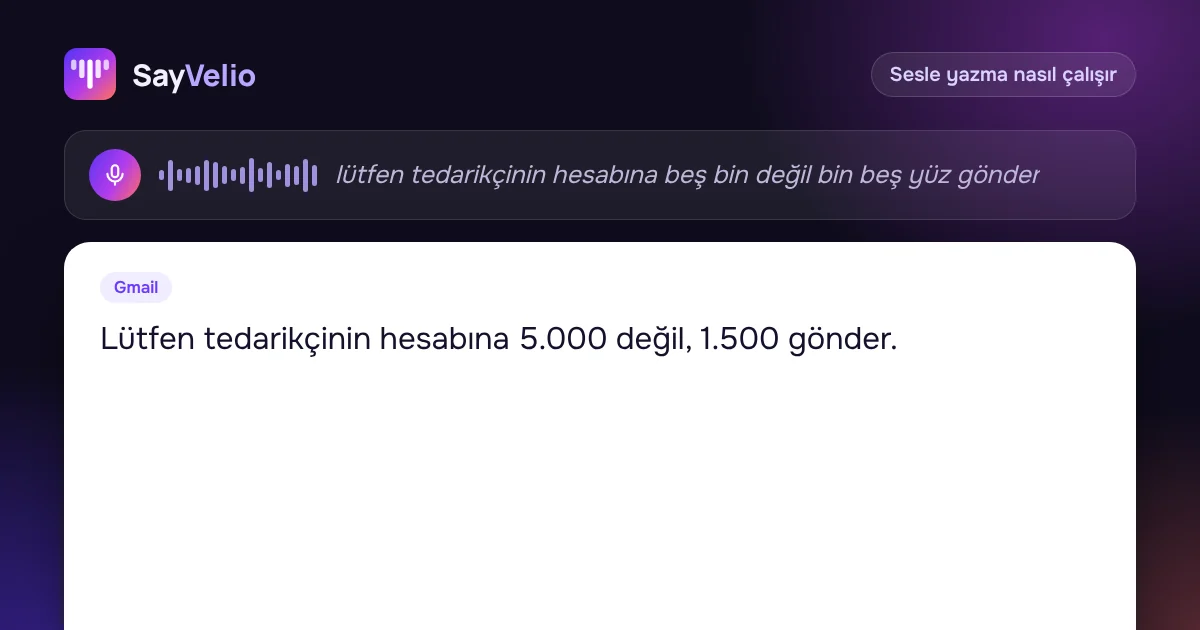 Sesle yazma nasıl çalışır
Sesle yazma ne kadar doğru? Hata oranı, hız ve gerçek sınırlar
Konuşma tanıma doğruluğu nasıl ölçülür (kelime hata oranı), araştırmalar dikte ile klavyenin hızı hakkında ne söylüyor, sonuçları ne kötüleştirir ve hangi kelimeler her zaman kontrol edilmeli.
MacWindowsiPhoneAndroid