
음성 인식은 소리를 어떻게 단어로 바꿀까
말소리가 컴퓨터에 어려운 이유, 음향 모델·발음 사전·언어 모델로 이루어진 전통적인 인식기의 원리, 엔드투엔드 모델(CTC, 인코더-디코더, 트랜스듀서)이 바꾼 것, 그리고 말하는 동안 텍스트가 바뀌는 이유를 알아봐요.
요약
말소리에는 단어 사이에 뚜렷한 간격이 없고 사람마다 발음이 달라서, 인식기는 소리에서 단어를 "읽어" 내지 않아요. 소리와 학습에서 배운 패턴을 바탕으로 가장 그럴듯한 단어 순서를 추정해요. 예전 시스템은 음향, 발음, 언어를 별도의 모델로 다뤘고, 요즘 시스템 대부분은 오디오에서 텍스트까지 전체 과정을 하나의 신경망으로 배워요.
말한 내용
내일 저녁에 같이 밥 먹을 수 있어 아니면 다음 주에 볼까
SayVelio가 입력한 내용
내일 저녁에 같이 밥 먹을 수 있어? 아니면 다음 주에 볼까?
말소리를 인식하기 어려운 이유
글에는 띄어쓰기가 있지만 말에는 없어요. "아버지가 방에 들어가신다"를 빠르게 말하면 "아버지 가방에 들어가신다"와 거의 똑같이 들려요. 소리는 앞뒤 소리에 따라 바뀌고(예를 들어 "국물"은 "궁물"로 발음돼요), 사람마다 말하는 속도와 높이가 다르고, 사투리는 모음 하나하나를 바꿔요.
그래서 같은 소리 구간이 여러 단어 순서에 들어맞을 수 있어요. 인식기는 단어를 확실하게 해독하는 게 아니라 후보를 비교해 가장 그럴듯한 것을 골라요. 그래서 결과가 아주 자연스럽게 읽히는데도 틀릴 수 있어요.
전통적인 방식: 세 가지 모델과 디코더
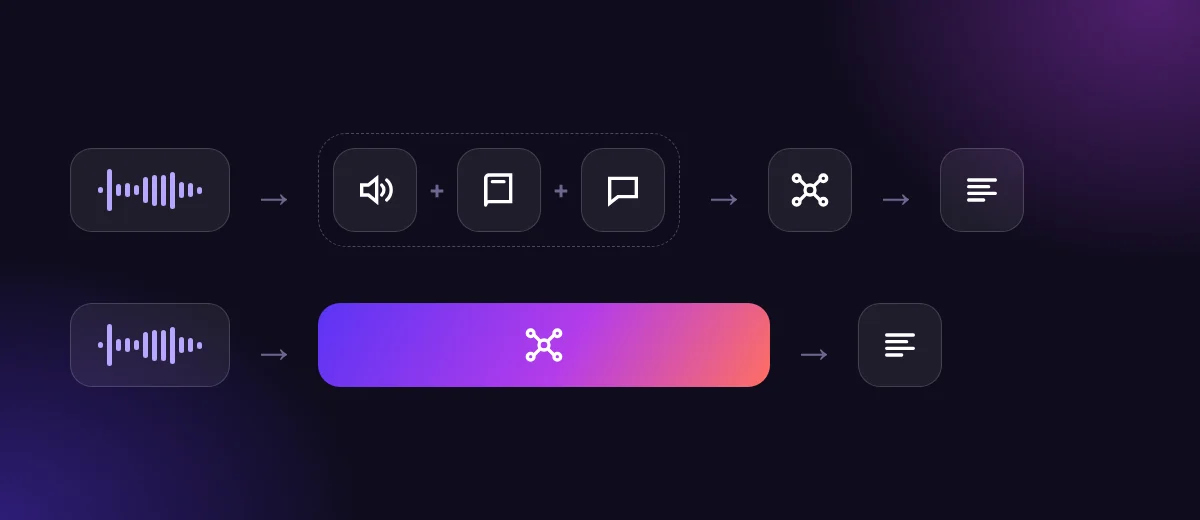
수십 년 동안 음성 인식은 따로따로 만든 부품으로 이루어졌어요.
- 음향 모델 은 짧은 오디오 조각을 말소리 단위(음소)와 연결했어요.
- 발음 사전 은 각 단어가 그 소리들의 어떤 순서로 발음될 수 있는지 나열했어요.
- 언어 모델 은 어떤 단어 순서가 그 언어에서 얼마나 그럴듯한지 점수를 매겼어요("아버지가 방에 들어가신다"가 "아버지 가방에 들어가신다"보다 훨씬 그럴듯해요).
- 디코더 는 조합들 가운데 전체적으로 가장 잘 맞는 것을 찾았어요.
이 구조는 지금도 문제를 이해하는 가장 명확한 방법이고, 일부를 쓰는 시스템도 있어요. 하지만 요즘 인식기 대부분은 이렇게 동작하지 않아요.
엔드투엔드 모델: 오디오에서 텍스트까지 하나의 신경망
요즘 시스템은 받아쓴 말소리를 엄청나게 많이 학습한 하나의 신경망으로 오디오에서 텍스트로 바로 이어지는 대응을 배워요. 흔한 계열은 세 가지예요.
- CTC(connectionist temporal classification) 는 짧은 오디오 프레임마다 글자나 단어 조각을 예측하고, 특별한 "빈칸" 기호도 써요. 그런 다음 반복을 합치고 빈칸을 지워요. 학습용 오디오에서 단어마다 시작 지점을 표시할 필요가 없어요.
- 어텐션 기반 인코더-디코더 모델 은 먼저 녹음 전체를 내부 표현으로 바꾼 다음, 텍스트를 한 조각씩 써 나가요. 다음 조각을 쓸 때마다 오디오의 관련 부분을 "되돌아" 봐요.
- 트랜스듀서(RNN-T 등) 는 오디오 인코더와 지금까지 만든 텍스트를 기억하는 부품을 합친 거예요. 그래서 아직 말하는 중에도 텍스트를 내는 데 잘 맞아요.
실제 제품은 이런 아이디어를 섞어 쓰고, 드문 단어를 위한 문맥 힌트 같은 단계를 더하기도 해요(문맥이 인식을 돕는 방법 참고). 음성 입력 앱은 어떤 구조를 쓰는지 알려 주지 않고, 알려 줄 필요도 없어요. 나에게 중요한 건 정확도, 속도, 그리고 내 데이터가 어떻게 되는지예요.
녹음 전체 인식과 스트리밍
인식은 말을 멈춘 뒤 녹음 전체에 대해 할 수도 있고, 말하는 동안 계속할 수도 있어요.
- 스트리밍 은 단어를 거의 바로 보여 주지만, 뒤에 오는 단어가 문맥을 더하면 처음 추측이 바뀔 수 있어요. "가방에"가 잠깐 보였다가 "방에"로 고쳐지는 식이에요.
- 녹음 전체 인식 은 말이 끝날 때까지 기다리지만, 문장 전체를 한 번에 보기 때문에 정확도와 문장 부호에 유리한 경우가 많아요.
체감하는 지연에는 말이 끝났다고 판단하는 시간, 네트워크, 그리고 다듬기가 있다면 그 시간도 들어가요. SayVelio에서는 말하는 동안 키를 누르고 있기 때문에 녹음이 끝나는 시점이 정확하고, 텍스트는 단어마다가 아니라 확정된 뒤에 입력돼요.
결과가 사실이 아니라 확률인 이유
시스템은 늘 가장 그럴듯한 후보를 고르기 때문에 실수도 그럴듯해 보여요. 맞춤법도 맞는 실제 단어인데 내가 말하지 않은 단어인 거죠. 이름, 숫자, 드문 용어는 모델이 덜 봤기 때문에 특히 틀리기 쉬워요. 실용적인 대책은 두 가지예요.
- 개인 사전으로 내 단어를 시스템에 가르치세요.
- 중요한 글은 보내기 전에 읽어 보세요. 특히 금액, 날짜, "안" 같은 부정어를요.
질문
음성 인식은 내가 뜻하는 바를 이해하나요?
사람처럼 이해하지는 않아요. 어떤 단어를 말했는지 추정할 뿐이에요. 의미는 글에서 배운 패턴을 통해서만 들어오고, 그 패턴이 비슷하게 들리는 표현 중에서 고르는 데 도움을 줘요.
왜 늘 같은 단어를 틀릴까요?
대개 그 단어가 드물거나 더 흔한 단어와 소리가 비슷하기 때문이에요. 사전에 추가하고 들리는 방식을 변형으로 함께 넣으면 대부분 해결돼요.
함께 읽기
 음성 입력의 원리
음성 인식은 어떻게 배우고, 문맥은 왜 이름과 전문 용어에 도움이 될까
학습과 일상적인 사용의 차이, 모델이 낯선 이름과 억양에 약한 이유, 문맥 힌트와 사전이 인식을 이끄는 방식, 그리고 음성 입력을 해도 내 목소리로 모델이 학습되지 않는 이유를 알아봐요.
MacWindowsiPhoneAndroid 음성 입력의 원리
인식 결과에서 읽기 좋은 글로: 문장 부호, 숫자, 다듬기
음성 인식의 날것 그대로의 결과를 바로 보낼 수 없는 이유, 문장 부호·숫자·목록이 들어가는 방식, "다섯 시 반"이 애매한 이유, 그리고 다듬기가 뜻을 바꾸지 않게 하는 방법을 알아봐요.
MacWindowsiPhoneAndroid 음성 입력의 원리
음성 입력은 얼마나 정확할까: 오류율, 속도, 실제 한계
음성 인식의 정확도를 재는 방법(단어 오류율), 음성 입력과 타이핑 속도에 대해 연구가 말해 주는 것, 결과를 나쁘게 만드는 요인, 그리고 꼭 확인해야 할 단어들을 알아봐요.
MacWindowsiPhoneAndroid