
Wie Spracherkennung lernt und warum Kontext bei Namen und Fachbegriffen hilft
Training und Alltagseinsatz, warum Modelle mit unbekannten Namen und Akzenten kämpfen, wie Kontexthinweise und Wörterbücher die Erkennung lenken und warum Diktieren nicht heißt, dass deine Stimme das Modell trainiert.
Kurz gesagt
Ein Sprachmodell lernt aus riesigen Mengen aufgenommener Sprache mit passendem Text und wendet das Gelernte dann auf deine Stimme an. Am besten ist es bei dem, was es oft gesehen hat, am schwächsten bei seltenen Namen und Fachjargon. Ein Kontexthinweis, etwa die Wörter in deinem Wörterbuch, lenkt die Erkennung zu deinen Begriffen, ohne das Modell selbst zu verändern, und ein Hinweis bedeutet nicht, dass deine Aufnahmen zu Trainingsdaten werden.
Du sagst
kannst du den hotfix vor der demo mit acme auf kubernetes ausrollen
SayVelio schrieb
Kannst du den Hotfix vor der Demo mit Acme auf Kubernetes ausrollen?
Training und Nutzung sind zwei verschiedene Momente
Maschinelles Lernen lässt ein Modell Muster aus Beispielen finden statt aus handgeschriebenen Regeln. Für Sprache sind das Aufnahmen zusammen mit dem, was gesagt wurde. Training passt die internen Parameter des Modells über sehr viele solcher Beispiele an. Inferenz ist das, was passiert, wenn du diktierst: Das fertige Modell wird auf deine neue Aufnahme angewendet.
Beides ist getrennt. Ein diktierter Satz bringt dem Modell für sich genommen nichts bei. Ob ein Anbieter Kundenaudio jemals fürs Training nutzt, ist eine Frage der Richtlinien, keine technische Notwendigkeit. SayVelio trainiert keine KI mit deinen Daten, siehe Datenschutz bei der Spracheingabe.
Wo ein Modell stark ist und wo es stolpert
Ein Modell spiegelt wider, womit es trainiert wurde. Ein häufiges Wort, klar gesprochen in einem ruhigen Raum, ist einfach. Schwieriger wird es, wenn dein Audio von den Trainingsdaten abweicht:
- Seltene Wörter: Nachnamen, Produktnamen, interne Projektnamen, neuer Slang.
- Akzente und Sprechweisen, die in den Trainingsdaten seltener vorkamen.
- Bedingungen: Hall, entfernte Mikrofone, mehrere Sprecher.
- Gemischte Sprachen in einem Satz; SayVelio erkennt dafür die Sprache bei jedem Diktat (siehe in zwei Sprachen diktieren).
Deshalb muss Qualität an Aufnahmen gemessen werden, die das Modell im Training nie gesehen hat. Ein Modell, das auf seinen Trainingsdaten perfekt wirkt, kann bei deiner Stimme trotzdem stolpern.
Mehr Daten sind nicht automatisch besser
Man nimmt leicht an, dass mehr Merkmale, Messungen oder Parameter immer bessere Ergebnisse bringen. In der Praxis können irrelevante oder doppelte Informationen dazu führen, dass ein Modell Rauschen lernt statt Muster, die sich übertragen lassen. Forschende testen Modelle deshalb an zurückgehaltenen Aufnahmen, um zu prüfen, ob eine Verbesserung auch bei neuer Sprache hält. Für dich zählt nur eine Zahl: wie gut es deinen nächsten Satz erkennt.
Zwei Wege, ein hartnäckiges Wort zu reparieren
| Kontexthinweis | Feinabstimmung (Fine-Tuning) | |
|---|---|---|
| Was sich ändert | Welche Wortkandidaten für diese Anfrage bevorzugt werden | Die Parameter des Modells, durch zusätzliches Training |
| Wie schnell | Sofort, bei jedem Diktat | Braucht Trainingsdaten und Zeit |
| Wer es macht | Du, indem du Wörter hinzufügst | Der Modellanbieter |
| Garantie | Keine, aber bei Namen sehr wirksam | Auch keine |
Ein Kontexthinweis ist wie der Satz vor einem Meeting: „Du wirst die Namen Kubernetes und Acme hören.“ Das ändert nicht das Gehör, sondern die Erwartung.
Wie SayVelio dein Wörterbuch nutzt
Dein SayVelio-Wörterbuch wirkt an zwei Stellen als solcher Hinweis:
- Bei der Erkennung werden deine Wörter dem Sprachmodell als Kontext mitgegeben, damit es sie eher wählt, wenn der Klang passt.
- Bei der Bereinigung, falls aktiv, hilft das Wörterbuch, Schreibweisen zu korrigieren, die die Erkennung trotzdem falsch hatte, einschließlich der Varianten, die du für die Aussprache eingetragen hast.
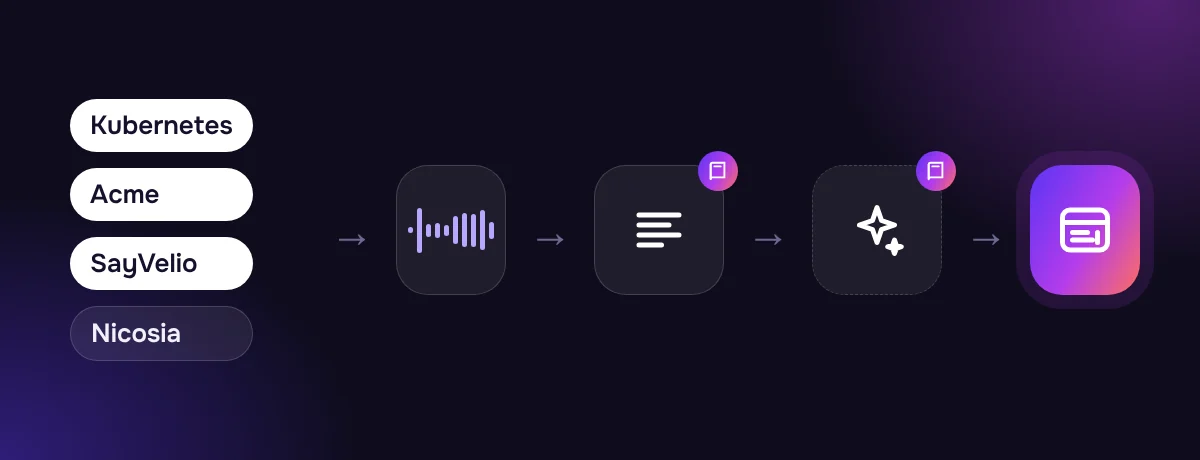
Keiner der Schritte ist eine Garantie, und ein kurzes, fokussiertes Wörterbuch wirkt besser als ein langes, weil sich hunderte Hinweise gegenseitig verwässern. Nimm die Wörter auf, die wirklich falsch herauskommen, und lass ungenutzte von selbst verschwinden.
Bereinigung ist ein zweites Modell mit eigenen Risiken
Die Erkennung schreibt Wörter auf, eine optionale Bereinigung macht daraus lesbaren Text. Sie nutzt ein Sprachmodell, das hervorragend Satzzeichen setzt und „ähm“ entfernt, aber ein Modell, das zu frei umschreibt, kann auch den Sinn verändern. Die Bereinigung in SayVelio ist angewiesen, deine Wörter und deine Sprache zu behalten, nie zu übersetzen und nie auf das Gesagte zu antworten. Bei wichtigen Texten vergleich das Ergebnis trotzdem mit dem, was du gemeint hast.
Häufige Fragen
Lernt SayVelio meine Stimme mit der Zeit?
Nein. Das Erkennungsmodell passt sich nicht an deine Stimme an, und deine Aufnahmen werden nicht fürs Training genutzt. An dich passen sich dein Wörterbuch, dein Bereinigungs-Prompt und deine App-Stile an.
Warum hilft ein hinzugefügtes Wort nicht immer?
Ein Hinweis macht ein Wort wahrscheinlicher, erzwingt es aber nicht. Wenn es weiter falsch herauskommt, füge seine Aussprache als Variante hinzu oder prüf, ob es in einem sehr langen Wörterbuch untergeht.
Weiterlesen
 Funktionen
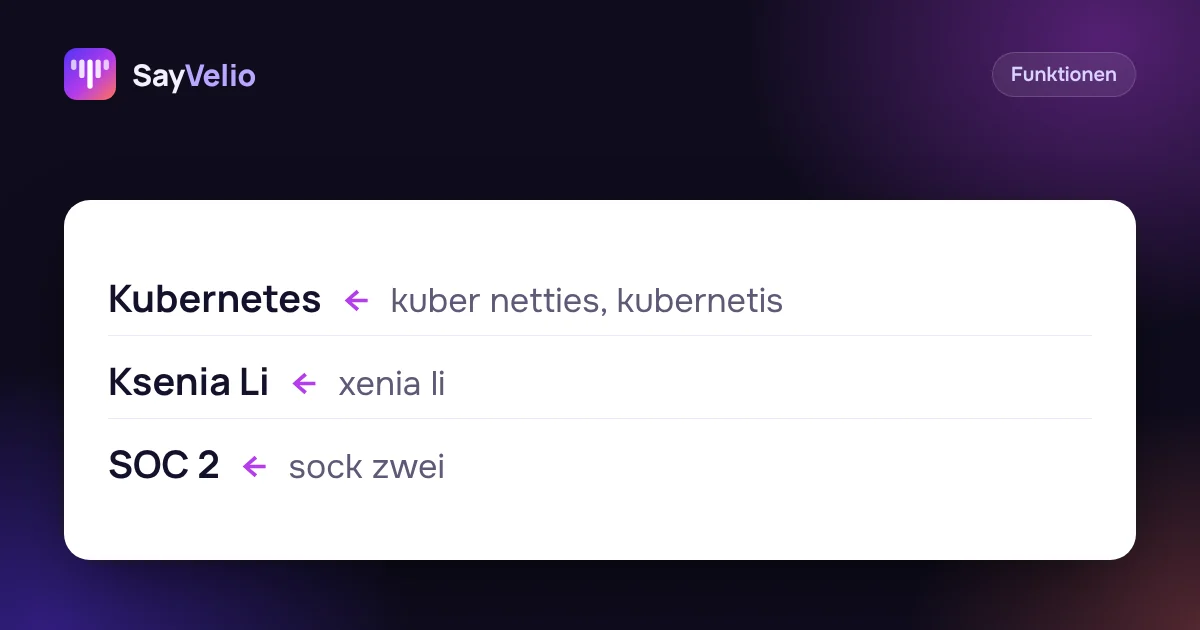
Eigenes Wörterbuch: So schreibt die Spracheingabe Namen, Marken und Fachbegriffe richtig
Was ins SayVelio-Wörterbuch gehört und was nicht, wie du ein Wort korrigierst, das immer falsch erkannt wird, und warum ein kurzes Wörterbuch besser funktioniert als ein langes.
MacWindowsiPhoneAndroid So funktioniert Spracheingabe
Wie Spracherkennung aus Ton Wörter macht
Warum Sprache für Computer schwer ist, wie klassische Erkenner mit akustischem Modell, Aussprachewörterbuch und Sprachmodell arbeiteten, was End-to-End-Modelle (CTC, Encoder-Decoder, Transducer) geändert haben und warum sich Text beim Streaming noch ändert.
MacWindowsiPhoneAndroid Erste Schritte
Zweisprachig diktieren: englische Begriffe in deiner eigenen Sprache
Wie SayVelio mit gemischter Sprache umgeht: Spracherkennung bei jedem Diktat, englische Begriffe bleiben, wie sie sind, keine Übersetzung, und wie Wörterbuch und App-Stile gemischten Text sauber halten.
MacWindowsiPhoneAndroid