
Как учится распознавание речи и почему контекст помогает с именами и жаргоном
Обучение и повседневное использование, почему модели путаются в незнакомых именах и акцентах, как подсказки и словари направляют распознавание и почему диктовка не означает, что ваш голос обучает модель.
Коротко
Речевая модель учится на огромном количестве записей речи с текстом, а потом применяет выученное к вашему голосу. Лучше всего она справляется с тем, что видела часто, хуже всего — с редкими именами и жаргоном. Подсказка из контекста, например слова из вашего словаря, склоняет распознавание к вашим терминам, не меняя саму модель, и использование подсказки не означает, что ваши записи становятся данными для обучения.
Вы сказали
выкати хотфикс в kubernetes до демо с acme
SayVelio напечатал
Выкати хотфикс в Kubernetes до демо с Acme.
Обучение и использование — два разных момента
Машинное обучение позволяет модели находить закономерности по примерам, а не по правилам, написанным вручную. Для речи такие примеры — записи вместе с тем, что в них сказано. Обучение подстраивает внутренние параметры модели на огромном количестве таких примеров. Инференс — то, что происходит, когда вы диктуете: готовая модель применяется к вашей новой записи.
Это разные вещи. Продиктованная фраза сама по себе ничему модель не учит. Использует ли провайдер записи клиентов для обучения — вопрос политики, а не технической необходимости. SayVelio не обучает ИИ на ваших данных, см. приватность голосового ввода.
В чём модель сильна, а где спотыкается
Модель отражает то, на чём её учили. Частое слово, сказанное чётко в тихой комнате, — легко. Сложнее, когда ваш звук отличается от обучающих данных:
- Редкие слова: фамилии, названия продуктов, внутренние имена проектов, новый сленг.
- Акценты и манера речи, которые реже встречались в обучающих данных.
- Условия: эхо, дальний микрофон, несколько говорящих.
- Смешение языков в одной фразе — SayVelio справляется с этим, определяя язык в каждой диктовке (см. диктовка на двух языках).
Поэтому качество нужно измерять на записях, которых модель не видела при обучении. Модель, идеальная на своих обучающих данных, всё равно может споткнуться на вашем голосе.
Больше данных — не всегда лучше
Легко решить, что больше признаков, измерений или параметров всегда дают лучший результат. На практике лишняя или повторяющаяся информация может заставить модель выучить шум вместо закономерностей, которые работают на новых данных. Исследователи проверяют модели на отложенных записях как раз затем, чтобы понять, сохраняется ли улучшение на новой речи. Для вас важна одна цифра: насколько хорошо модель распознает вашу следующую фразу.
Два способа исправить упрямое слово
| Подсказка из контекста | Дообучение | |
|---|---|---|
| Что меняется | Какие варианты слов предпочтительнее в этом запросе | Параметры модели, через дополнительное обучение |
| Как быстро | Сразу, в каждой диктовке | Нужны данные и время |
| Кто делает | Вы, добавляя слова | Провайдер модели |
| Гарантия | Нет, но для имён очень эффективно | Тоже нет |
Подсказка — как сказать человеку перед встречей: «услышишь названия Kubernetes и Acme». Слух у него не меняется, меняются ожидания.
Как SayVelio использует ваш словарь
Ваш словарь SayVelio работает как такая подсказка в двух местах:
- При распознавании ваши слова передаются речевой модели как контекст, чтобы она чаще выбирала их, когда звук подходит.
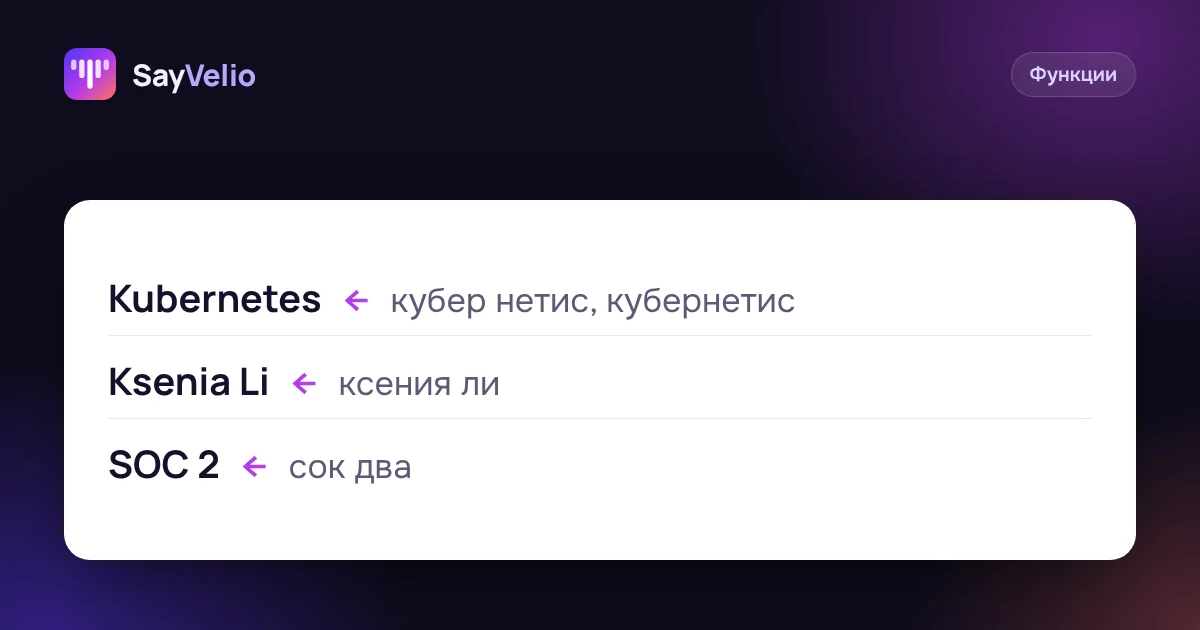
- При обработке, если она включена, словарь помогает исправить написание, в котором распознавание всё-таки ошиблось, включая варианты того, как слово звучит.
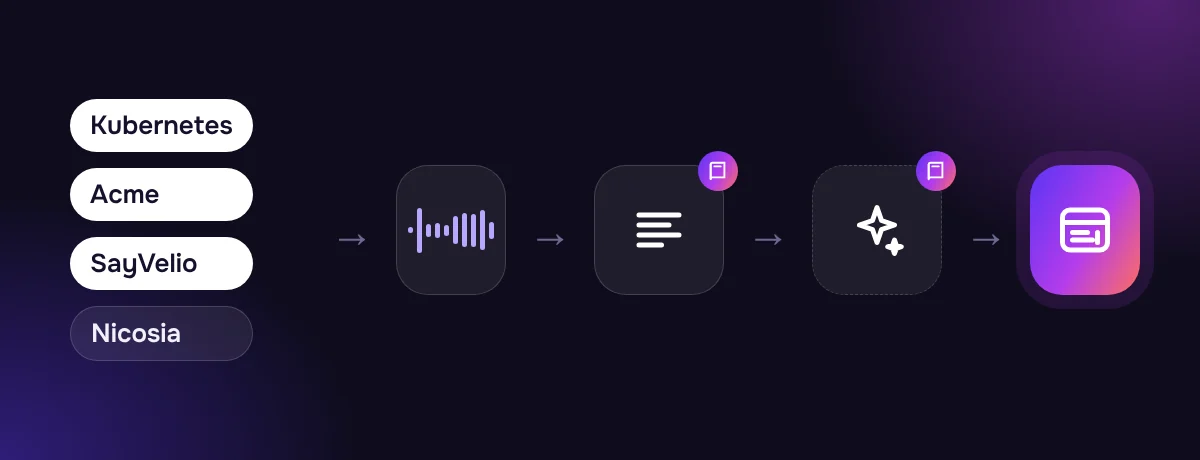
Ни один шаг не даёт гарантии, а короткий словарь работает лучше длинного: сотни подсказок мешают друг другу. Добавляйте слова, которые действительно получаются неправильно, а неиспользуемые пусть уходят сами.
Обработка — это вторая модель со своими рисками
Распознавание записывает слова, а необязательная обработка переписывает их в читаемый текст. Обработка использует языковую модель: она отлично расставляет знаки и убирает «э-э», но модель, которая переписывает слишком вольно, может изменить смысл. Обработке в SayVelio задано сохранять ваши слова и язык, никогда не переводить и не отвечать на сказанное. И всё же для важного текста сверяйте результат с тем, что имели в виду.
Частые вопросы
SayVelio со временем учится моему голосу?
Нет. Модель распознавания не подстраивается под ваш голос, а ваши записи не используются для обучения. Под вас подстраиваются ваш словарь, промпт обработки и стили для приложений.
Почему добавленное слово не всегда исправляется?
Подсказка делает слово вероятнее, но не навязывает его. Если слово всё ещё получается неправильно, добавьте вариант того, как оно звучит, или проверьте, не тонет ли оно в очень длинном словаре.
Похожие материалы
 Функции
Словарь в диктовке: как научить её писать имена, бренды и термины
Что добавлять в словарь SayVelio, а что нет, как исправить слово, которое всё время пишется неправильно, и почему короткий словарь работает точнее длинного.
MacWindowsiPhoneAndroid Как устроен голосовой ввод
Как распознавание речи превращает звук в слова
Почему речь трудна для компьютера, как работали классические распознаватели с акустической, произносительной и языковой моделями, что изменили сквозные модели (CTC, кодер-декодер, трансдьюсеры) и почему текст при потоковом распознавании меняется на ходу.
MacWindowsiPhoneAndroid С чего начать
Диктовка на двух языках: английские термины в русской речи
Как SayVelio работает со смешанной речью: определяет язык каждой диктовки, оставляет английские термины как есть, никогда не переводит, а словарь и стили приложений помогают держать смешанный текст в порядке.
MacWindowsiPhoneAndroid