
Cómo aprende el reconocimiento de voz y por qué el contexto ayuda con nombres y jerga
Entrenamiento frente a uso diario, por qué los modelos fallan con nombres y acentos poco habituales, cómo las pistas de contexto y los diccionarios guían el reconocimiento y por qué dictar no significa que tu voz entrene al modelo.
En resumen
Un modelo de voz aprende de enormes cantidades de habla grabada con su texto y luego aplica lo aprendido a tu voz. Es mejor en lo que ha visto a menudo y más flojo con nombres raros y jerga. Una pista de contexto, como las palabras de tu diccionario, inclina el reconocimiento hacia tus términos sin cambiar el modelo, y usar una pista no significa que tus grabaciones se conviertan en datos de entrenamiento.
Dijiste
puedes subir el hotfix a kubernetes antes de la demo con acme
SayVelio escribió
¿Puedes subir el hotfix a Kubernetes antes de la demo con Acme?
Entrenar y usar son dos momentos distintos
El aprendizaje automático permite que un modelo encuentre patrones a partir de ejemplos en vez de reglas escritas a mano. En voz, esos ejemplos son grabaciones junto con lo que se dijo. El entrenamiento ajusta los parámetros internos del modelo con una enorme cantidad de ejemplos. La inferencia es lo que ocurre cuando dictas: el modelo ya terminado se aplica a tu nueva grabación.
Son cosas separadas. Dictar una frase no le enseña nada al modelo por sí solo. Que un proveedor use alguna vez el audio de sus clientes para entrenar es una cuestión de política, no una necesidad técnica. SayVelio no entrena IA con tus datos; ver privacidad en el dictado por voz.
En qué es bueno un modelo y dónde tropieza
Un modelo refleja aquello con lo que se entrenó. Una palabra común dicha con claridad en una sala tranquila es fácil. Se complica cuando tu audio se aleja de los datos de entrenamiento:
- Palabras raras: apellidos, nombres de productos, nombres internos de proyectos, jerga nueva.
- Acentos y formas de hablar que eran menos frecuentes en los datos de entrenamiento.
- Condiciones: eco, micrófonos lejanos, varias personas hablando.
- Idiomas mezclados en una misma frase, que SayVelio resuelve detectando el idioma en cada dictado (ver dictar en dos idiomas).
Por eso la calidad debe medirse con grabaciones que el modelo nunca vio durante el entrenamiento. Un modelo que parece perfecto con sus propios datos puede tropezar con tu voz.
Más datos no es automáticamente mejor
Es fácil suponer que más características, mediciones o parámetros siempre dan mejores resultados. En la práctica, la información irrelevante o redundante puede hacer que un modelo aprenda ruido en vez de patrones que generalicen. Los investigadores prueban los modelos con grabaciones apartadas justo para comprobar si una mejora se mantiene con habla nueva. A ti solo te importa una cifra: lo bien que transcribe tu próxima frase.
Dos maneras de arreglar una palabra rebelde
| Pista de contexto | Ajuste fino | |
|---|---|---|
| Qué cambia | Qué palabras candidatas se prefieren en esta petición | Los parámetros del modelo, con entrenamiento adicional |
| Rapidez | Al instante, en cada dictado | Requiere datos de entrenamiento y tiempo |
| Quién lo hace | Tú, añadiendo palabras | El proveedor del modelo |
| Garantía | Ninguna, pero muy eficaz con nombres | Tampoco |
Una pista de contexto es como avisar a alguien antes de una reunión: «vas a oír los nombres Kubernetes y Acme». No le cambia el oído, le cambia lo que espera.
Cómo usa SayVelio tu diccionario
Tu diccionario de SayVelio funciona como ese tipo de pista en dos momentos:
- Durante el reconocimiento, tus palabras se pasan al modelo de voz como contexto, para que sea más probable que las elija cuando el sonido encaja.
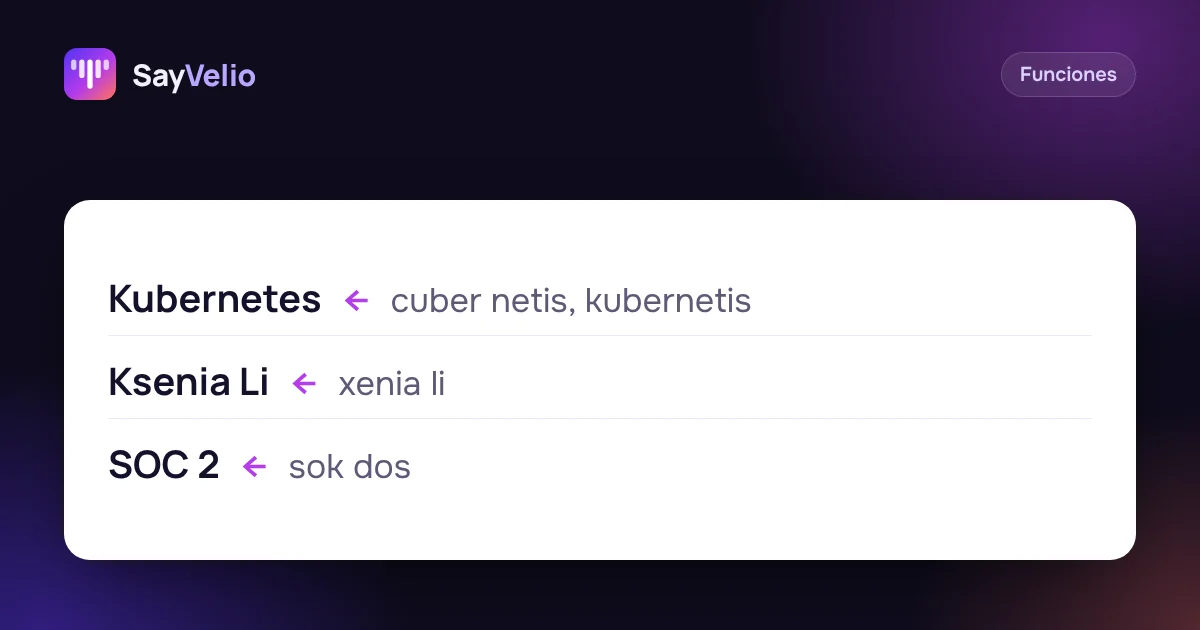
- Durante la limpieza, si está activada, el diccionario ayuda a corregir grafías que el reconocimiento aún falló, incluidas las variantes que anotaste de cómo suena una palabra.
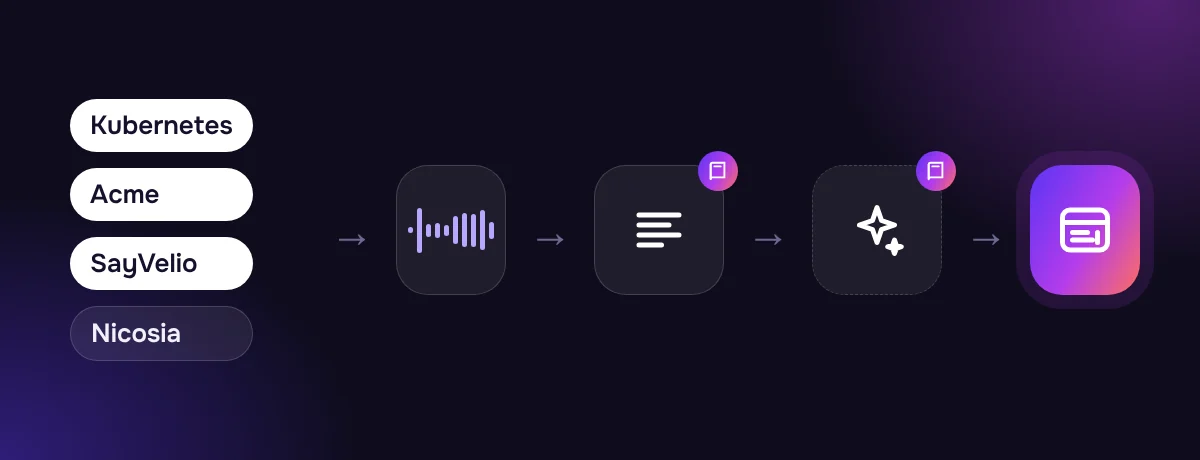
Ningún paso es una garantía, y un diccionario corto y centrado funciona mejor que uno largo, porque cientos de pistas se diluyen entre sí. Añade las palabras que de verdad salen mal y deja que las que no usas se vayan solas.
La limpieza es un segundo modelo, con sus propios riesgos
El reconocimiento escribe palabras; una limpieza opcional las reescribe como texto legible. Usa un modelo de lenguaje, excelente para la puntuación y para quitar los «eh», pero un modelo que reescribe con demasiada libertad también puede cambiar el sentido. La limpieza de SayVelio tiene la instrucción de mantener tus palabras y tu idioma, no traducir nunca y no responder a lo que dictas. Aun así, en lo importante, compara el resultado con lo que querías decir.
Preguntas frecuentes
¿SayVelio aprende mi voz con el tiempo?
No. El modelo de reconocimiento no se adapta a tu voz y tus grabaciones no se usan para entrenar. Lo que se adapta a ti es tu diccionario, tu prompt de limpieza y tus estilos por app.
¿Por qué añadir una palabra no siempre la arregla?
Una pista hace una palabra más probable, no la impone. Si sigue saliendo mal, añade cómo suena como variante o comprueba que no se pierda en un diccionario muy largo.
Lecturas relacionadas
 Funciones
Diccionario personal: enseña al dictado tus nombres, marcas y jerga
Qué añadir al diccionario de SayVelio y qué no, cómo corregir una palabra que siempre sale mal y por qué un diccionario corto funciona mejor que uno largo.
MacWindowsiPhoneAndroid Cómo funciona el dictado por voz
Cómo el reconocimiento de voz convierte el sonido en palabras
Por qué el habla es difícil para un ordenador, cómo funcionaban los reconocedores clásicos con modelos acústico, de pronunciación y de lenguaje, qué cambiaron los modelos de extremo a extremo (CTC, codificador-decodificador, transductores) y por qué el texto en streaming cambia mientras hablas.
MacWindowsiPhoneAndroid Primeros pasos
Dictar en dos idiomas: términos en inglés dentro de tu propio idioma
Cómo maneja SayVelio el habla mezclada: detecta el idioma en cada dictado, deja los términos en inglés tal cual, nunca traduce, y cómo el diccionario y los estilos por app mantienen bien el texto mixto.
MacWindowsiPhoneAndroid