
Comment la reconnaissance vocale apprend, et pourquoi le contexte aide pour les noms et le jargon
Entraînement et usage quotidien, pourquoi les modèles butent sur les noms et accents peu courants, comment les indices de contexte et les dictionnaires guident la reconnaissance, et pourquoi dicter ne veut pas dire que votre voix entraîne le modèle.
En bref
Un modèle vocal apprend sur d'énormes quantités de parole enregistrée accompagnée de texte, puis applique ce qu'il a appris à votre voix. Il est meilleur sur ce qu'il a souvent vu, plus faible sur les noms rares et le jargon. Un indice de contexte, comme les mots de votre dictionnaire, oriente la reconnaissance vers vos termes sans changer le modèle, et utiliser un indice ne signifie pas que vos enregistrements deviennent des données d'entraînement.
Vous avez dit
tu peux déployer le hotfix sur kubernetes avant la démo avec acme
SayVelio a écrit
Tu peux déployer le hotfix sur Kubernetes avant la démo avec Acme ?
Entraînement et usage : deux moments distincts
L'apprentissage automatique permet à un modèle de trouver des régularités à partir d'exemples plutôt que de règles écrites à la main. Pour la parole, ces exemples sont des enregistrements accompagnés de ce qui a été dit. L'entraînement ajuste les paramètres internes du modèle sur un très grand nombre d'exemples. L'inférence, c'est ce qui se passe quand vous dictez : le modèle terminé est appliqué à votre nouvel enregistrement.
Les deux sont séparés. Dicter une phrase n'apprend rien au modèle en soi. Qu'un fournisseur utilise un jour l'audio de ses clients pour l'entraînement relève de sa politique, pas d'une nécessité technique. SayVelio n'entraîne pas d'IA sur vos données ; voir la confidentialité de la saisie vocale.
Où un modèle excelle et où il trébuche
Un modèle reflète ce sur quoi il a été entraîné. Un mot courant prononcé clairement dans une pièce calme, c'est facile. Cela se complique quand votre son s'éloigne des données d'entraînement :
- Mots rares : noms de famille, noms de produits, noms de projets internes, argot récent.
- Accents et façons de parler moins présents dans les données d'entraînement.
- Conditions : écho, micro éloigné, plusieurs personnes qui parlent.
- Langues mélangées dans une phrase, que SayVelio gère en détectant la langue à chaque dictée (voir dicter en deux langues).
C'est pourquoi la qualité doit se mesurer sur des enregistrements que le modèle n'a jamais vus à l'entraînement. Un modèle parfait sur ses propres données peut trébucher sur votre voix.
Plus de données n'est pas automatiquement mieux
On suppose facilement que plus de caractéristiques, de mesures ou de paramètres donnent toujours de meilleurs résultats. En pratique, des informations inutiles ou redondantes peuvent pousser un modèle à apprendre du bruit plutôt que des régularités généralisables. Les chercheurs testent les modèles sur des enregistrements mis de côté justement pour vérifier qu'une amélioration tient sur de la parole nouvelle. Pour vous, un seul chiffre compte : la qualité de la transcription de votre prochaine phrase.
Deux façons de corriger un mot récalcitrant
| Indice de contexte | Ajustement fin (fine-tuning) | |
|---|---|---|
| Ce qui change | Les mots candidats privilégiés pour cette requête | Les paramètres du modèle, par un entraînement supplémentaire |
| Rapidité | Immédiat, à chaque dictée | Demande des données et du temps |
| Qui s'en charge | Vous, en ajoutant des mots | Le fournisseur du modèle |
| Garantie | Aucune, mais très efficace pour les noms | Aucune non plus |
Un indice de contexte, c'est comme prévenir quelqu'un avant une réunion : « tu vas entendre les noms Kubernetes et Acme ». Cela ne change pas son ouïe, cela change ses attentes.
Comment SayVelio utilise votre dictionnaire
Votre dictionnaire SayVelio sert d'indice de ce type à deux moments :
- Pendant la reconnaissance, vos mots sont transmis au modèle vocal comme contexte, pour qu'il les choisisse plus volontiers quand le son correspond.
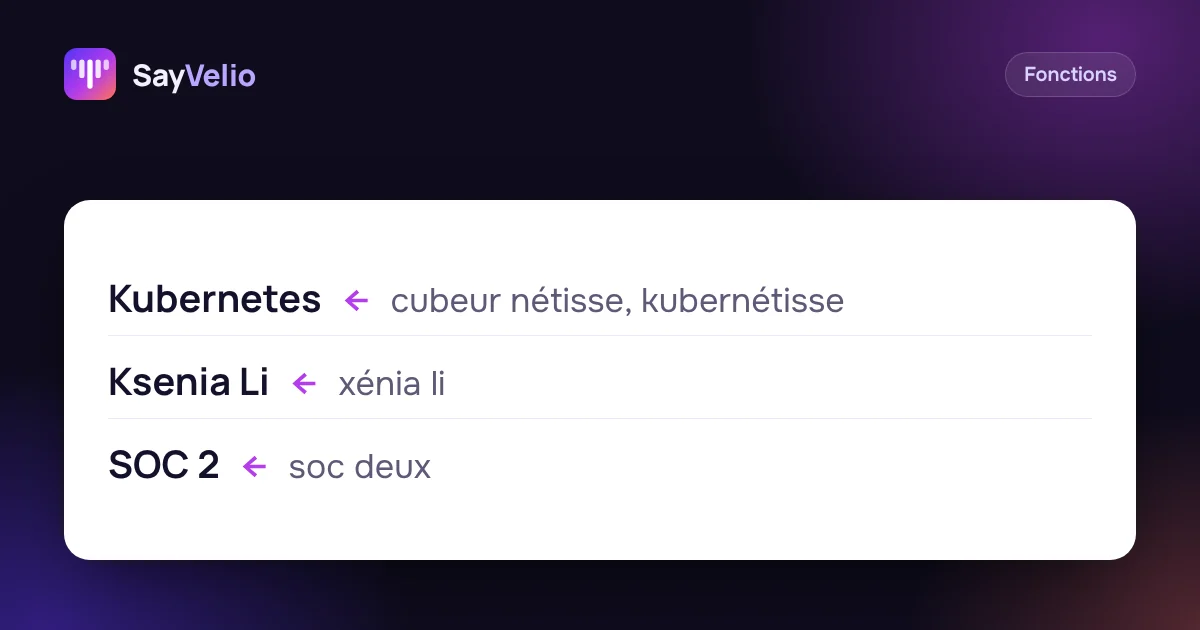
- Pendant le nettoyage, s'il est activé, le dictionnaire aide à corriger les graphies que la reconnaissance a encore ratées, y compris les variantes de prononciation que vous avez notées.
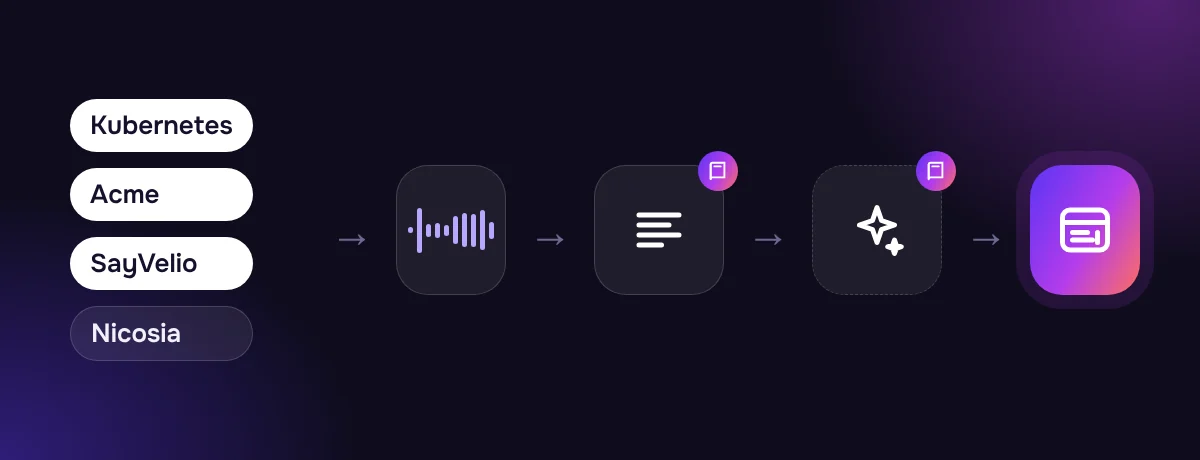
Aucune étape n'est une garantie, et un dictionnaire court et ciblé fonctionne mieux qu'un long, car des centaines d'indices se diluent entre eux. Ajoutez les mots qui sortent vraiment mal, et laissez partir d'eux-mêmes ceux qui ne servent plus.
Le nettoyage est un second modèle, avec ses propres risques
La reconnaissance écrit des mots ; un nettoyage facultatif les réécrit en texte lisible. Il utilise un modèle de langage, excellent pour la ponctuation et pour retirer les « euh », mais un modèle qui réécrit trop librement peut aussi changer le sens. Le nettoyage de SayVelio a pour consigne de garder vos mots et votre langue, de ne jamais traduire et de ne jamais répondre à ce que vous dictez. Pour un texte important, comparez quand même le résultat avec ce que vous vouliez dire.
Questions fréquentes
SayVelio apprend-il ma voix avec le temps ?
Non. Le modèle de reconnaissance ne s'adapte pas à votre voix et vos enregistrements ne servent pas à l'entraînement. Ce qui s'adapte à vous, c'est votre dictionnaire, votre prompt de nettoyage et vos styles par app.
Pourquoi ajouter un mot ne suffit-il pas toujours ?
Un indice rend un mot plus probable, il ne l'impose pas. Si le mot sort encore mal, ajoutez sa prononciation en variante ou vérifiez qu'il ne se perd pas dans un dictionnaire très long.
À lire aussi
 Fonctions
Dictionnaire personnel : apprenez à la dictée vos noms, marques et jargon
Ce qu’il faut ajouter au dictionnaire de SayVelio et ce qu’il vaut mieux laisser de côté, comment corriger un mot toujours mal écrit, et pourquoi un dictionnaire court marche mieux qu’un long.
MacWindowsiPhoneAndroid Comment fonctionne la saisie vocale
Comment la reconnaissance vocale transforme le son en mots
Pourquoi la parole est difficile pour un ordinateur, comment fonctionnaient les systèmes classiques avec modèles acoustique, de prononciation et de langage, ce que les modèles de bout en bout (CTC, encodeur-décodeur, transducteurs) ont changé, et pourquoi le texte en streaming bouge pendant que vous parlez.
MacWindowsiPhoneAndroid Bien démarrer
Dicter en deux langues : des termes anglais dans votre propre langue
Comment SayVelio gère une parole mélangée : détection de la langue à chaque dictée, termes anglais conservés tels quels, aucune traduction, et comment le dictionnaire et les styles par app gardent le texte mixte propre.
MacWindowsiPhoneAndroid