
음성 인식은 어떻게 배우고, 문맥은 왜 이름과 전문 용어에 도움이 될까
학습과 일상적인 사용의 차이, 모델이 낯선 이름과 억양에 약한 이유, 문맥 힌트와 사전이 인식을 이끄는 방식, 그리고 음성 입력을 해도 내 목소리로 모델이 학습되지 않는 이유를 알아봐요.
요약
음성 모델은 텍스트와 짝을 이룬 엄청난 양의 녹음된 말소리로 배우고, 배운 것을 내 목소리에 적용해요. 자주 본 것에는 강하고, 드문 이름과 전문 용어에는 약해요. 사전 속 단어 같은 문맥 힌트는 모델 자체를 바꾸지 않고 인식을 내 용어 쪽으로 기울여 줘요. 힌트를 쓴다고 내 녹음이 학습 데이터가 되는 건 아니에요.
말한 내용
데모 전에 kubernetes에 핫픽스 배포해 줄 수 있어요 acme 건이에요
SayVelio가 입력한 내용
데모 전에 Kubernetes에 핫픽스 배포해 줄 수 있어요? Acme 건이에요.
학습과 사용은 서로 다른 순간이에요
머신러닝은 모델이 사람이 쓴 규칙을 따르는 대신 예시에서 패턴을 찾게 해 줘요. 음성에서 예시는 녹음과 그 안에서 말한 내용의 짝이에요. 학습 은 이런 예시를 아주 많이 써서 모델 내부의 파라미터를 조정하는 거예요. 추론 은 내가 음성 입력할 때 일어나는 일로, 완성된 모델을 새 녹음에 적용하는 거예요.
둘은 별개예요. 한 문장을 음성 입력한다고 해서 그것만으로 모델이 뭔가를 배우지는 않아요. 제공업체가 고객 오디오를 학습에 쓰는지는 정책의 문제이지 기술적으로 꼭 필요한 일이 아니에요. SayVelio는 내 데이터로 AI를 학습시키지 않아요. 음성 입력과 개인정보를 보세요.
모델이 잘하는 것과 어려워하는 것
모델은 학습한 것을 반영해요. 조용한 방에서 또렷하게 말한 흔한 단어는 쉬워요. 내 오디오가 학습 데이터와 다를수록 어려워져요.
- 드문 단어: 성씨, 제품 이름, 사내 프로젝트 이름, 새로운 유행어.
- 학습 데이터에 적었던 억양과 말투.
- 환경: 울림, 먼 마이크, 여러 사람의 목소리.
- 한 문장 안에서 섞이는 언어. SayVelio는 음성 입력할 때마다 언어를 감지해서 처리해요(두 언어로 음성 입력하기 참고).
그래서 품질은 모델이 학습 중에 본 적 없는 녹음으로 재야 해요. 자기 학습 데이터에서는 완벽해 보이는 모델도 내 목소리에서는 걸려 넘어질 수 있어요.
데이터가 많다고 자동으로 좋아지지는 않아요
특징, 측정값, 파라미터가 많을수록 결과가 늘 좋아질 거라고 생각하기 쉬워요. 실제로는 관계없거나 중복된 정보 때문에 모델이 일반화되는 패턴 대신 잡음을 배울 수도 있어요. 연구자들이 따로 떼어 둔 녹음으로 모델을 시험하는 것도 개선이 새로운 말소리에서도 통하는지 확인하기 위해서예요. 나에게 중요한 숫자는 하나뿐이에요. 내 다음 문장을 얼마나 잘 받아쓰느냐예요.
고집스럽게 틀리는 단어를 고치는 두 가지 방법
| 문맥 힌트 | 파인튜닝 | |
|---|---|---|
| 바뀌는 것 | 이번 요청에서 어떤 후보 단어를 우선할지 | 추가 학습을 통한 모델의 파라미터 |
| 속도 | 음성 입력할 때마다 즉시 | 학습 데이터와 시간이 필요 |
| 하는 사람 | 내가 단어를 추가해서 | 모델 제공업체 |
| 보장 | 없음. 하지만 이름에는 아주 효과적 | 역시 없음 |
문맥 힌트는 회의 전에 누군가에게 "Kubernetes랑 Acme라는 이름이 나올 거야"라고 미리 말해 두는 것과 같아요. 듣는 능력은 그대로지만 기대가 달라져요.
SayVelio가 사전을 쓰는 방법
SayVelio 사전은 이런 힌트로서 두 군데에서 작동해요.
- 인식할 때 내 단어가 문맥으로 음성 모델에 전달돼서, 소리가 맞으면 그 단어를 고를 가능성이 높아져요.
- 다듬을 때(켜져 있다면) 인식이 그래도 틀린 표기를 고치는 데 사전이 도움을 줘요. 단어가 들리는 방식으로 넣어 둔 변형도 쓰여요.
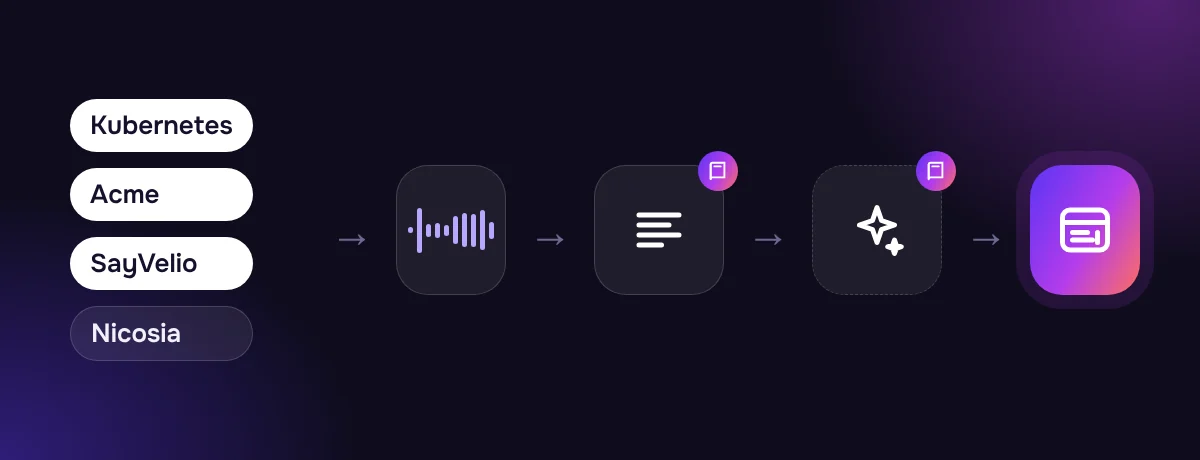
어느 단계도 보장은 아니에요. 그리고 짧고 집중된 사전이 긴 사전보다 잘 작동해요. 수백 개의 힌트는 서로 효과를 묽게 만들거든요. 실제로 틀리게 나오는 단어를 추가하고, 쓰지 않는 단어는 빠지게 두세요.
다듬기는 나름의 위험이 있는 두 번째 모델이에요
인식은 단어를 받아쓰고, 선택 사항인 다듬기가 그것을 읽기 좋은 글로 고쳐 써요. 다듬기에는 언어 모델이 쓰이는데, 문장 부호를 넣고 "음", "어"를 빼는 데는 아주 능하지만, 너무 자유롭게 고쳐 쓰는 모델은 뜻까지 바꿀 수 있어요. SayVelio의 다듬기는 내 단어와 언어를 지키고, 절대 번역하지 않고, 말한 내용에 대답하지 않도록 지시받아요. 그래도 중요한 글은 결과를 내가 뜻한 바와 비교해 보세요.
질문
SayVelio는 쓸수록 내 목소리를 익히나요?
아니요. 인식 모델은 내 목소리에 맞춰 바뀌지 않고, 내 녹음은 학습에 쓰이지 않아요. 나에게 맞춰지는 건 내 사전, 다듬기 프롬프트, 앱별 스타일이에요.
단어를 추가해도 항상 고쳐지지 않는 이유는 뭔가요?
힌트는 단어가 선택될 가능성을 높일 뿐, 강제하지는 않아요. 그래도 틀리게 나오면 들리는 방식을 변형으로 추가하거나, 사전이 너무 길어서 단어가 묻히지 않았는지 확인하세요.
함께 읽기
 기능
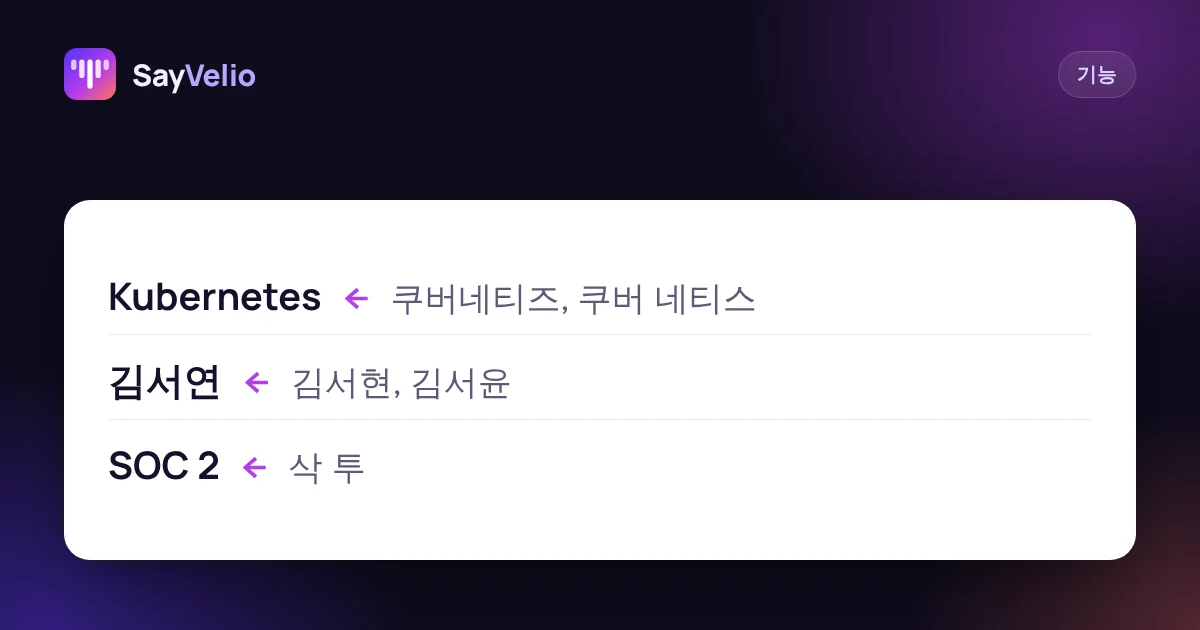
나만의 사전: 받아쓰기에 이름, 브랜드, 전문 용어 가르치기
SayVelio 사전에 넣을 것과 뺄 것, 계속 틀리게 나오는 단어를 고치는 법, 그리고 짧은 사전이 긴 사전보다 나은 이유.
MacWindowsiPhoneAndroid 음성 입력의 원리
음성 인식은 소리를 어떻게 단어로 바꿀까
말소리가 컴퓨터에 어려운 이유, 음향 모델·발음 사전·언어 모델로 이루어진 전통적인 인식기의 원리, 엔드투엔드 모델(CTC, 인코더-디코더, 트랜스듀서)이 바꾼 것, 그리고 말하는 동안 텍스트가 바뀌는 이유를 알아봐요.
MacWindowsiPhoneAndroid 시작하기
두 언어로 받아쓰기: 한국어에 영어 용어를 섞어 말하기
SayVelio가 두 언어가 섞인 말을 처리하는 방법: 받아쓰기마다 언어 감지, 영어 용어는 그대로, 번역 없음, 그리고 사전과 앱별 스타일로 섞인 텍스트를 정확하게 유지하는 방법.
MacWindowsiPhoneAndroid