
Come impara il riconoscimento vocale e perché il contesto aiuta con nomi e gergo
Addestramento e uso quotidiano, perché i modelli faticano con nomi poco noti e accenti, come suggerimenti di contesto e dizionari orientano il riconoscimento e perché dettare non significa addestrare il modello con la tua voce.
In breve
Un modello vocale impara da enormi quantità di parlato registrato abbinato al testo, poi applica ciò che ha imparato alla tua voce. È più bravo con ciò che ha visto spesso e più debole con nomi rari e gergo. Un suggerimento di contesto, come le parole del tuo dizionario, sposta il riconoscimento verso i tuoi termini senza cambiare il modello, e usare un suggerimento non significa che le tue registrazioni diventino dati di addestramento.
Hai detto
puoi fare il deploy dell'hotfix su kubernetes prima della demo con acme
SayVelio ha scritto
Puoi fare il deploy dell'hotfix su Kubernetes prima della demo con Acme?
Addestramento e uso sono due momenti diversi
L'apprendimento automatico permette a un modello di trovare schemi a partire da esempi, invece di seguire regole scritte a mano. Per il parlato gli esempi sono registrazioni abbinate a ciò che è stato detto. L'addestramento regola i parametri interni del modello su un numero enorme di esempi. L'inferenza è ciò che succede quando detti: il modello finito viene applicato alla tua nuova registrazione.
Le due cose sono separate. Dettare una frase, di per sé, non insegna nulla al modello. Se un fornitore usi o meno l'audio dei clienti per l'addestramento è una questione di regole, non una necessità tecnica. SayVelio non addestra l'IA sui tuoi dati: vedi privacy nella dettatura vocale.
In cosa un modello è bravo e dove inciampa
Un modello riflette ciò su cui è stato addestrato. Una parola comune detta chiaramente in una stanza tranquilla è facile. Le cose si complicano quando il tuo audio è diverso dai dati di addestramento:
- Parole rare: cognomi, nomi di prodotti, nomi di progetti interni, gergo nuovo.
- Accenti e modi di parlare meno presenti nei dati di addestramento.
- Condizioni: eco, microfoni lontani, più persone che parlano.
- Lingue mescolate nella stessa frase, che SayVelio gestisce riconoscendo la lingua a ogni dettatura (vedi dettare in due lingue).
Per questo la qualità va misurata su registrazioni che il modello non ha mai visto durante l'addestramento. Un modello che sembra perfetto sui propri dati di addestramento può comunque inciampare sulla tua voce.
Più dati non significa automaticamente meglio
Viene facile pensare che più caratteristiche, più misure o più parametri diano sempre risultati migliori. In pratica, informazioni irrilevanti o ridondanti possono far imparare al modello il rumore invece di schemi che valgono in generale. I ricercatori testano i modelli su registrazioni tenute da parte proprio per verificare se un miglioramento regge su parlato nuovo. Per te conta un solo numero: quanto bene trascrive la tua prossima frase.
Due modi per sistemare una parola ostinata
| Suggerimento di contesto | Fine-tuning | |
|---|---|---|
| Cosa cambia | Quali parole candidate sono favorite per questa richiesta | I parametri del modello, con un addestramento aggiuntivo |
| Quanto è rapido | Immediato, a ogni dettatura | Richiede dati di addestramento e tempo |
| Chi lo fa | Tu, aggiungendo parole | Il fornitore del modello |
| Garanzia | Nessuna, ma molto efficace per i nomi | Nessuna nemmeno qui |
Un suggerimento di contesto è come dire a qualcuno prima di una riunione: «sentirai i nomi Kubernetes e Acme». Non cambia il suo udito, cambia le sue aspettative.
Come SayVelio usa il tuo dizionario
Il tuo dizionario di SayVelio funziona come questo tipo di suggerimento in due momenti:
- Durante il riconoscimento, le tue parole vengono passate al modello vocale come contesto, così è più probabile che le scelga quando il suono corrisponde.
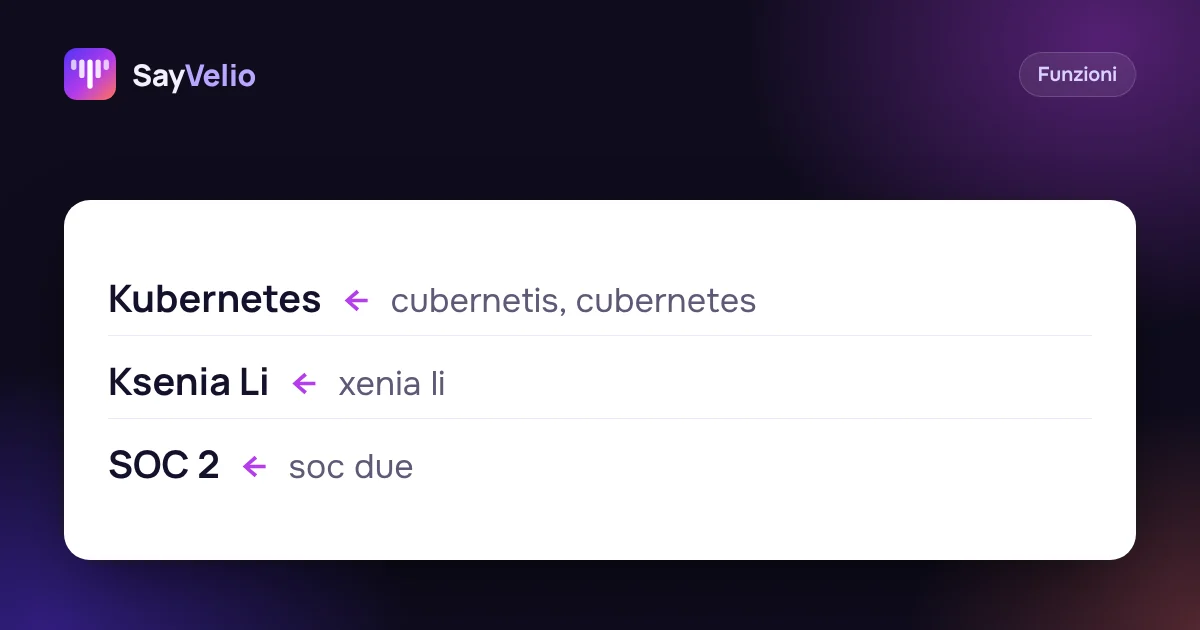
- Durante la pulizia, se è attiva, il dizionario aiuta a correggere le grafie che il riconoscimento ha comunque sbagliato, comprese le varianti che hai indicato per come suona una parola.
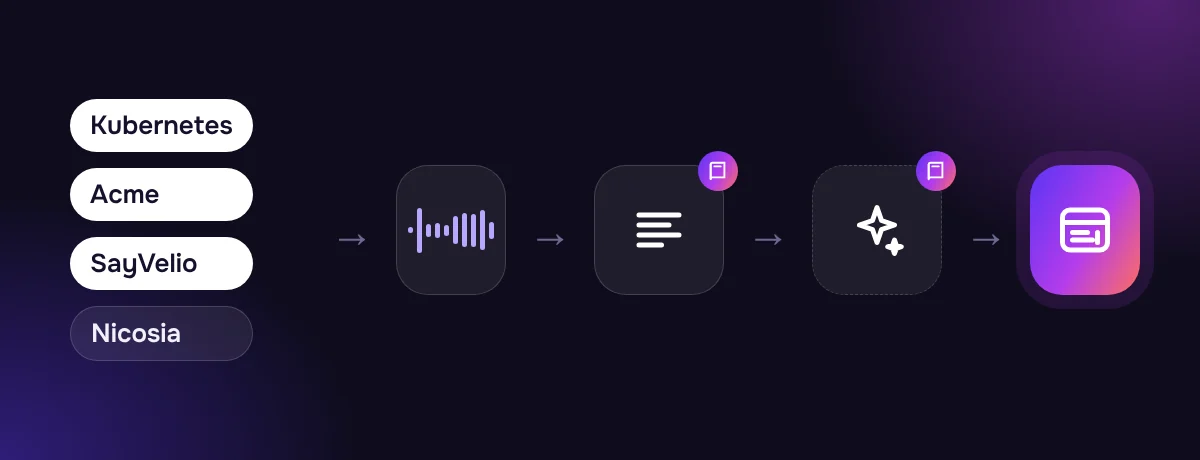
Nessuno dei due passaggi è una garanzia, e un dizionario breve e mirato funziona meglio di uno lungo, perché centinaia di suggerimenti si diluiscono a vicenda. Aggiungi le parole che escono davvero sbagliate e lascia cadere quelle che non usi.
La pulizia è un secondo modello, con i suoi rischi
Il riconoscimento scrive le parole; una pulizia facoltativa le riscrive in un testo leggibile. La pulizia usa un modello linguistico, bravissimo con la punteggiatura e a togliere gli «ehm», ma un modello che riscrive troppo liberamente può anche cambiare il significato. La pulizia di SayVelio ha l'istruzione di mantenere le tue parole e la tua lingua, di non tradurre mai e di non rispondere mai a ciò che hai detto. Comunque, per le cose importanti, confronta il risultato con ciò che intendevi.
Domande frequenti
SayVelio impara la mia voce col tempo?
No. Il modello di riconoscimento non si adatta alla tua voce e le tue registrazioni non vengono usate per l'addestramento. A adattarsi a te sono il tuo dizionario, il tuo prompt di pulizia e i tuoi stili per app.
Perché aggiungere una parola non sempre la corregge?
Un suggerimento rende una parola più probabile, non la impone. Se esce ancora sbagliata, aggiungi come suona come variante, oppure controlla che non si perda in un dizionario lunghissimo.
Leggi anche
 Funzioni
Dizionario personale: insegna alla dettatura nomi, marchi e gergo
Cosa aggiungere al dizionario di SayVelio e cosa lasciare fuori, come correggere una parola sempre scritta male e perché un dizionario corto funziona meglio di uno lungo.
MacWindowsiPhoneAndroid Come funziona la dettatura vocale
Come il riconoscimento vocale trasforma il suono in parole
Perché il parlato è difficile per un computer, come funzionavano i riconoscitori classici con modelli acustici, di pronuncia e linguistici, cosa hanno cambiato i modelli end-to-end (CTC, encoder-decoder, transducer) e perché il testo in streaming può cambiare mentre parli.
MacWindowsiPhoneAndroid Per iniziare
Dettare in due lingue: termini inglesi nella tua lingua
Come SayVelio gestisce il parlato misto: rileva la lingua a ogni dettatura, lascia i termini inglesi come sono, non traduce mai, e come dizionario e stili per app tengono in ordine il testo misto.
MacWindowsiPhoneAndroid