
التعرف على الكلام وتحويل النص إلى كلام: ما الفرق؟
التعرف على الكلام يحوّل الصوت إلى نص، وتحويل النص إلى كلام يحوّل النص إلى صوت. كيف تعمل كل تقنية، وأين تلتقيان (الأرقام والتواريخ والأسماء)، وكيف تختلف ترميزات الكلام عنهما، ولماذا لا يقرأ تطبيق الإملاء النص بصوت عالٍ.
باختصار
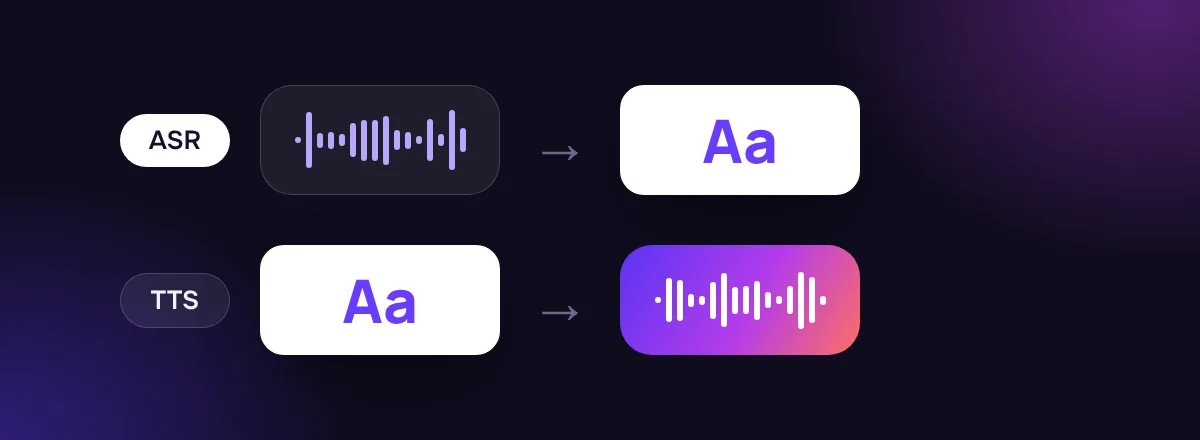
التعرف على الكلام (ASR) يستمع ويكتب: صوت في المدخل ونص في المخرج. وتحويل النص إلى كلام (TTS) يقرأ ويتكلم: نص في المدخل وصوت في المخرج. كثيرًا ما يظهران معًا في المساعدات الصوتية، لكنهما تقنيتان منفصلتان تختلفان في التدريب والناتج ومقاييس الجودة. وهناك تقنية ثالثة، هي ترميز الكلام، تكتفي بتصغير الصوت لنقله ولا تقوم بأيٍّ من المهمتين.
قلتَ
تأجل الاجتماع إلى يوم الثاني عشر الساعة الثالثة والنصف عصرا
كتب SayVelio
تأجل الاجتماع إلى يوم 12 الساعة 3:30 عصرًا.
اتجاهان متعاكسان
| التعرف على الكلام (ASR) | تحويل النص إلى كلام (TTS) | ترميز الكلام | |
|---|---|---|---|
| المدخل | صوت شخص يتكلم | نص مكتوب | صوت |
| المخرج | نص | صوت اصطناعي | الصوت نفسه بحجم أخف |
| السؤال الأساسي | ما الكلمات التي قيلت؟ | كيف يجب أن يبدو هذا النص مسموعًا؟ | كيف يُنقل هذا الصوت بكفاءة؟ |
| الاستخدام المعتاد | الإملاء، والترجمة النصية للفيديو، والبحث الصوتي | قارئات الشاشة، والملاحة، والكتب الصوتية | المكالمات، والرسائل الصوتية |
| تُقاس الجودة بـ | معدل خطأ الكلمات | تقييمات الطبيعية والوضوح | اختبارات استماع عند معدل بت معيّن |
المساعد الصوتي يستخدم الاثنين: التعرف ليفهم سؤالك، والتحويل إلى كلام ليجيب بصوت عالٍ. لكن وجود أحدهما لا يعني وجود الآخر. SayVelio تطبيق إملاء: يتعرف على الكلام ويكتب نصًا، ولا يقرأ شيئًا بصوت عالٍ.
كيف يعمل تحويل النص إلى كلام
يعمل نظام TTS المعتاد على مراحل:
- تحليل النص. توسيع الاختصارات والأرقام إلى كلمات (هل تُقرأ «د.» «دكتور» أم «دينار»؟)، واختيار النطق الصحيح للكلمات التي تُكتب بالحروف نفسها وتُنطق بشكل مختلف («عِلم» و«عَلَم» في نص بلا تشكيل).
- التنغيم. تحديد الإيقاع والوقفات والنبر واللحن، ليبدو السؤال سؤالًا.
- النموذج الصوتي. التنبؤ بكيف يجب أن يبدو الصوت عبر الزمن، غالبًا على هيئة مخطط طيفي.
- المُرمِّز الصوتي (vocoder). تحويل هذا التنبؤ إلى موجة صوتية حقيقية يمكن سماعها.
من الأمثلة المعروفة Tacotron 2 من Google (2018)، الذي يتنبأ بمخطط ميل الطيفي من النص ويستخدم مُرمِّزًا صوتيًا عصبيًا لإنتاج الصوت. كثير من الأنظمة الأحدث تدمج هذه المراحل أو تعيد ترتيبها، لكن دور كل منها باقٍ.
يمكن للمطورين التحكم في التحويل إلى كلام عبر SSML (لغة ترميز تركيب الكلام)، وهي معيار من W3C لتحديد الوقفات والتشديد والنطق وطريقة قراءة التواريخ وغيرها. ويختلف دعم كل ميزة من ميزات SSML من محرّك إلى آخر.
حيث يلتقيان: الأرقام والتواريخ والأسماء
يتعثر الاتجاهان في الأشياء نفسها، كلٌّ من جهته:
- الإملاء عليه أن يحوّل «اثنا عشر وخمسون» المنطوقة إلى كتابة: 12:50؟ 1250؟ 12.50 دولارًا؟ هذا هو التطبيع العكسي للنص، الموصوف في من النص الخام إلى نص مقروء.
- التحويل إلى كلام عليه أن يحوّل «12/05» المكتوبة إلى كلام: الثاني عشر من مايو أم الخامس من ديسمبر؟ هذا هو تطبيع النص.
الأمران مرتبطان دون أن يكونا مرآة دقيقة أحدهما للآخر، لأن الإجابة الصحيحة في الاتجاهين تعتمد على السياق. والأسماء صعبة في الاتجاهين: نظام التعرف يجب أن يعرف كيف يُكتب اسم يسمعه (وهذا دور القاموس)، ونظام التحويل إلى كلام يجب أن يعرف كيف يُنطق اسم يقرؤه.
الترميزات شيء ثالث منفصل
ترميز الكلام مثل Opus يمثّل صوتًا موجودًا أصلًا ببتات أقل لنقله أو تخزينه. لا يُنشئ كلامًا من نص، ولا يقرر ما الكلمات التي قيلت. والمنتج الذي يحوّل الكلام إلى نص لا يحتاج إلى تركيب صوت ولا إلى استخدام ترميز معيّن. مزيد من التفاصيل في ضغط الصوت للكلام.
كلاهما يستخدم تعلّم الآلة، بطريقة مختلفة
يعتمد ASR وTTS الحديثان على الشبكات العصبية، ويتعلمان كلاهما من أزواج من الصوت والنص. لكن هدفيهما متعاكسان: يُحكم على ASR بصحة الكلمات، وعلى TTS بمدى طبيعية الصوت ووضوحه للمستمعين. والنموذج الممتاز في أحدهما لا يجيد الآخر تلقائيًا.
أسئلة شائعة
هل يستطيع SayVelio قراءة نصي لي؟
لا. SayVelio مخصص للكتابة بالصوت. لسماع نص، استخدم الميزة المدمجة في نظامك: «المحتوى المنطوق» على Mac وiPhone، و«الراوي» على Windows، و«التحديد للنطق» على Android.
هل «تحويل الصوت إلى نص» و«التعرف على الصوت» الشيء نفسه؟
يُستخدمان كثيرًا كمترادفين، لكن بالمعنى الدقيق قد يعني التعرف على الصوت أيضًا تحديد من يتكلم. SayVelio يتعرف على ما تقوله، لا على هويتك.
اقرأ أيضًا
 كيف تعمل الكتابة بالصوت
كيف يحوّل التعرف على الكلام الصوت إلى كلمات
لماذا الكلام صعب على الحاسوب، وكيف عملت أنظمة التعرف التقليدية بنماذج صوتية ونطقية ولغوية، وما الذي غيّرته النماذج الشاملة (CTC والمرمِّز-المفكِّك والمحوِّلات)، ولماذا قد يتغيّر النص المتدفق أثناء كلامك.
MacWindowsiPhoneAndroid كيف تعمل الكتابة بالصوت
من النص الخام إلى نص مقروء: علامات الترقيم والأرقام والتنظيف
لماذا لا يكون النص الخام للتعرف على الكلام جاهزًا للإرسال، وكيف تُضاف علامات الترقيم والأرقام والقوائم، ولماذا تحتمل «خمسة وخمسين» أكثر من معنى، وكيف تمنع خطوة التنظيف من تغيير ما قصدته.
MacWindowsiPhoneAndroid كيف تعمل الكتابة بالصوت
صيغ الصوت والضغط في الكتابة بالصوت
الصوت الرقمي والترميز والضغط ثلاثة أشياء مختلفة. كيف يعمل الضغط دون فقد ومع فقد، ولماذا لا تستطيع أي خوارزمية تصغير كل ملف، وكيف توازن ترميزات الكلام مثل Opus بين الحجم والتأخير، وما يعنيه ذلك للإملاء.
MacWindowsiPhoneAndroid