
음성 인식과 음성 합성의 차이
음성 인식은 목소리를 텍스트로, 음성 합성은 텍스트를 목소리로 바꿔요. 각각의 원리, 둘이 만나는 지점(숫자, 날짜, 이름), 음성 코덱이 둘과 다른 점, 그리고 음성 입력 앱이 텍스트를 읽어 주지 않는 이유를 알아봐요.
요약
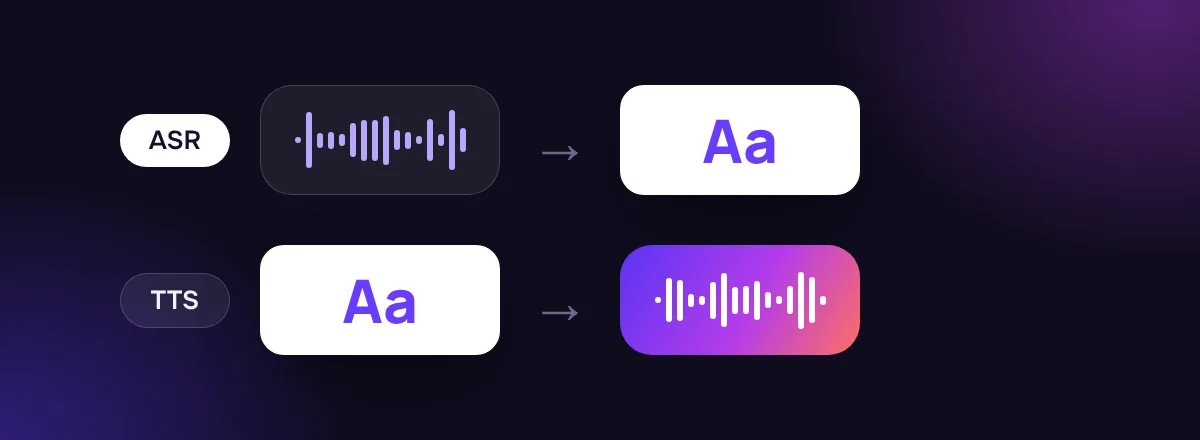
음성 인식(ASR)은 듣고 써요. 입력은 소리, 출력은 텍스트예요. 음성 합성(TTS)은 읽고 말해요. 입력은 텍스트, 출력은 소리예요. 음성 비서에서는 함께 쓰이는 경우가 많지만, 학습 방식도 결과물도 품질을 재는 방법도 다른 별개의 기술이에요. 세 번째 기술인 음성 코덱은 소리를 보내기 위해 줄이기만 할 뿐, 둘 중 어느 일도 하지 않아요.
말한 내용
회의가 십이 일 오후 세 시 삼십 분으로 바뀌었어요
SayVelio가 입력한 내용
회의가 12일 오후 3시 30분으로 바뀌었어요.
정반대의 두 방향
| 음성 인식(ASR) | 음성 합성(TTS) | 음성 코덱 | |
|---|---|---|---|
| 입력 | 말하는 사람의 소리 | 쓰인 텍스트 | 소리 |
| 출력 | 텍스트 | 합성된 목소리 | 같은 소리를 더 가볍게 |
| 핵심 질문 | 어떤 단어를 말했나? | 이 글은 어떻게 들려야 하나? | 이 소리를 어떻게 효율적으로 보낼까? |
| 대표 용도 | 음성 입력, 자막, 음성 검색 | 화면 낭독기, 내비게이션, 오디오북 | 통화, 음성 메시지 |
| 품질 측정 | 단어 오류율 | 자연스러움과 명료도 평가 | 정해진 비트레이트에서의 청취 테스트 |
음성 비서는 둘 다 써요. 질문을 이해하려고 인식을, 소리 내어 답하려고 합성을 써요. 하지만 하나가 있다고 다른 하나도 있는 건 아니에요. SayVelio는 음성 입력 앱이라서 말소리를 인식해 텍스트를 쓰고, 아무것도 소리 내어 읽지 않아요.
음성 합성의 원리
일반적인 TTS 시스템은 단계별로 동작해요.
- 텍스트 분석. 약어와 숫자를 단어로 풀고("3개"는 "세 개"로, "3층"은 "삼 층"으로), 같은 글자인데 다르게 읽는 경우의 발음을 골라요("눈"이 내리는 눈인지 얼굴의 눈인지에 따라 길게 또는 짧게).
- 운율. 리듬, 쉼, 강세, 억양을 정해서 질문이 질문처럼 들리게 해요.
- 음향 모델. 목소리가 시간에 따라 어떻게 들려야 하는지를 흔히 스펙트로그램 형태로 예측해요.
- 보코더. 그 예측을 실제로 들을 수 있는 파형으로 바꿔요.
잘 알려진 예가 Google의 Tacotron 2(2018)예요. 텍스트에서 멜 스펙트로그램을 예측하고, 신경망 보코더로 소리를 만들어요. 최근 시스템은 이 단계들을 합치거나 다시 배치하는 경우가 많지만, 각 단계의 역할은 그대로예요.
개발자는 SSML(Speech Synthesis Markup Language)로 합성을 조절할 수 있어요. 쉼, 강조, 발음, 날짜 읽는 법 등을 표시하는 W3C 표준이에요. SSML 기능별 지원은 엔진마다 달라요.
둘이 만나는 곳: 숫자, 날짜, 이름
두 방향 모두 같은 곳에서 걸려 넘어져요. 각자 자기 쪽에서요.
- 음성 입력 은 말로 한 "열두 시 오십 분"을 글로 바꿔야 해요. 12:50일까요, 12시 50분일까요? 이게 역 텍스트 정규화이고, 인식 결과에서 읽기 좋은 글로에서 설명해요.
- 음성 합성 은 글로 쓴 "12/05"를 말로 바꿔야 해요. 12월 5일일까요, 5월 12일일까요? 이게 텍스트 정규화예요.
둘은 이어져 있지만 정확한 거울상은 아니에요. 어느 방향이든 정답은 문맥에 달려 있으니까요. 이름은 두 방향 모두에서 어려워요. 인식 시스템은 들은 이름을 어떻게 쓰는지 알아야 하고(그게 사전의 역할이에요), 합성 시스템은 읽은 이름을 어떻게 발음하는지 알아야 해요.
코덱은 별개의 세 번째 것
Opus 같은 음성 코덱은 이미 있는 소리를 보내거나 저장하려고 더 적은 비트로 나타내요. 텍스트에서 말소리를 만들지도, 어떤 단어를 말했는지 정하지도 않아요. 말소리를 텍스트로 바꾸는 제품이 목소리를 합성하거나 특정 코덱을 쓸 필요는 없어요. 자세한 내용은 음성 오디오 압축을 보세요.
둘 다 머신러닝을 쓰지만 방식이 달라요
요즘 ASR과 TTS는 모두 신경망을 바탕으로 하고, 둘 다 소리와 텍스트의 짝으로 배워요. 하지만 목표는 정반대예요. ASR은 단어가 얼마나 정확한지로, TTS는 듣는 사람에게 목소리가 얼마나 자연스럽고 또렷한지로 평가받아요. 한쪽에서 뛰어난 모델이 자동으로 다른 쪽도 잘하는 건 아니에요.
질문
SayVelio가 내 글을 읽어 줄 수 있나요?
아니요. SayVelio는 목소리로 쓰기 위한 도구예요. 글을 듣고 싶다면 시스템 기본 기능을 쓰세요. Mac과 iPhone에서는 말하기 콘텐츠, Windows에서는 내레이터, Android에서는 선택하여 말하기예요.
"음성을 텍스트로"와 "음성 인식"은 같은 말인가요?
흔히 같은 뜻으로 쓰지만, 엄밀히 말하면 음성 인식은 누가 말하는지 알아내는 화자 인식을 뜻하기도 해요. SayVelio는 내가 무슨 말을 했는지 인식할 뿐, 내가 누구인지는 인식하지 않아요.
함께 읽기
 음성 입력의 원리
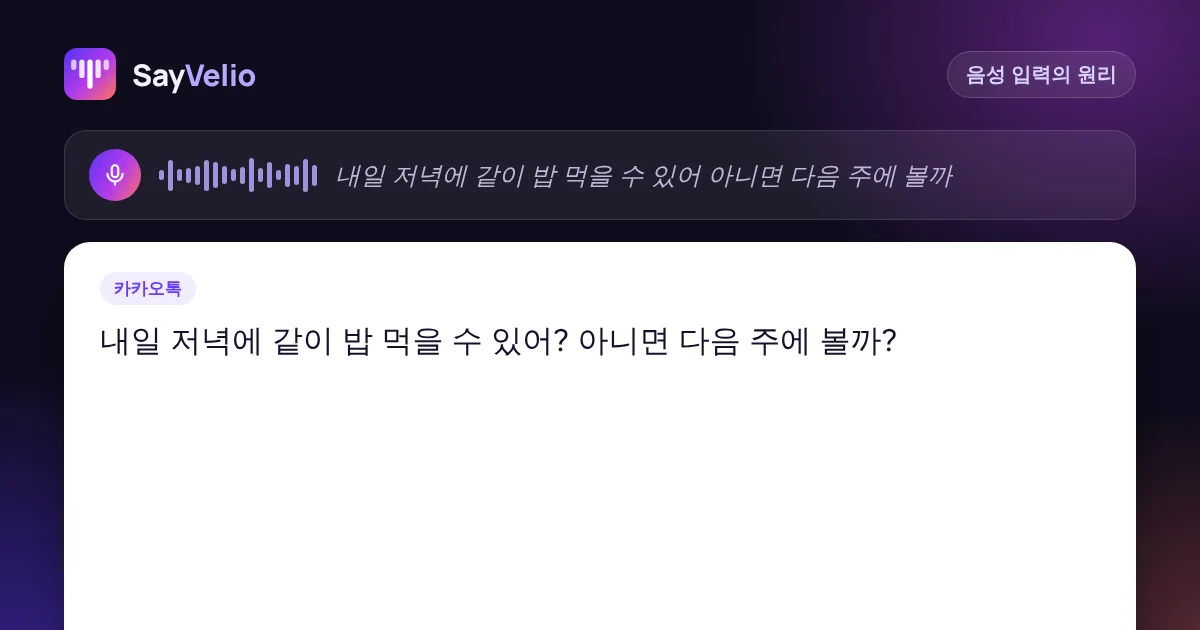
음성 인식은 소리를 어떻게 단어로 바꿀까
말소리가 컴퓨터에 어려운 이유, 음향 모델·발음 사전·언어 모델로 이루어진 전통적인 인식기의 원리, 엔드투엔드 모델(CTC, 인코더-디코더, 트랜스듀서)이 바꾼 것, 그리고 말하는 동안 텍스트가 바뀌는 이유를 알아봐요.
MacWindowsiPhoneAndroid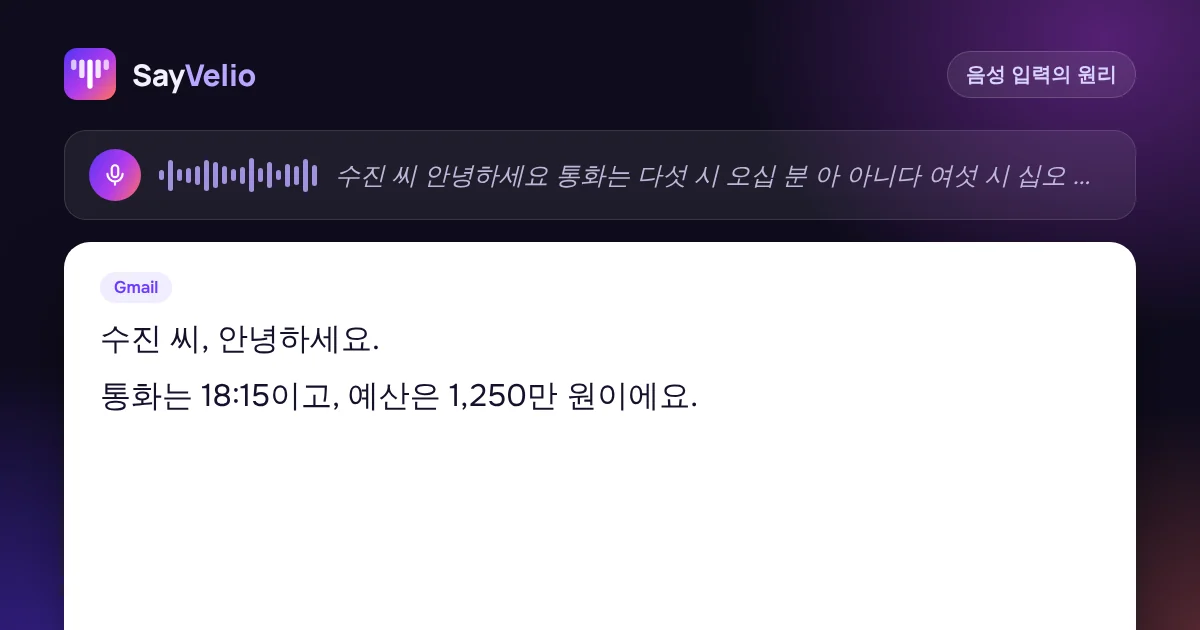 음성 입력의 원리
인식 결과에서 읽기 좋은 글로: 문장 부호, 숫자, 다듬기
음성 인식의 날것 그대로의 결과를 바로 보낼 수 없는 이유, 문장 부호·숫자·목록이 들어가는 방식, "다섯 시 반"이 애매한 이유, 그리고 다듬기가 뜻을 바꾸지 않게 하는 방법을 알아봐요.
MacWindowsiPhoneAndroid 음성 입력의 원리
음성 입력의 오디오 형식과 압축
디지털 오디오, 인코딩, 압축은 서로 다른 개념이에요. 무손실 압축과 손실 압축의 원리, 어떤 알고리즘도 모든 파일을 줄일 수 없는 이유, Opus 같은 음성 코덱이 크기와 지연을 조율하는 방법, 그리고 음성 입력에 주는 의미를 알아봐요.
MacWindowsiPhoneAndroid