
Распознавание речи и синтез речи: в чём разница
Распознавание речи превращает голос в текст, синтез — текст в голос. Как работает каждое, где они пересекаются (числа, даты, имена), чем от обоих отличаются речевые кодеки и почему приложение для диктовки не читает текст вслух.
Коротко
Распознавание речи (ASR) слушает и пишет: на входе звук, на выходе текст. Синтез речи (TTS) читает и говорит: на входе текст, на выходе звук. Они часто встречаются вместе в голосовых ассистентах, но это разные технологии с разным обучением, результатом и мерами качества. Третья технология, речевой кодек, только уменьшает звук для передачи и не делает ни того, ни другого.
Вы сказали
встречу перенесли на пятнадцать тридцать двенадцатого числа
SayVelio напечатал
Встречу перенесли на 15:30 12-го числа.
Противоположные направления
| Распознавание речи (ASR) | Синтез речи (TTS) | Речевой кодек | |
|---|---|---|---|
| Вход | Звук голоса | Письменный текст | Звук |
| Выход | Текст | Синтезированный голос | Тот же звук, но меньше |
| Главный вопрос | Какие слова сказаны? | Как должен звучать этот текст? | Как эффективно передать этот звук? |
| Типичное применение | Диктовка, субтитры, голосовой поиск | Экранные дикторы, навигаторы, аудиокниги | Звонки, голосовые сообщения |
| Качество измеряют | Долей ошибок в словах | Оценками естественности и разборчивости | Тестами на слух при заданном битрейте |
Голосовой ассистент использует оба: распознавание, чтобы понять вопрос, синтез, чтобы ответить вслух. Но одно не означает другого. SayVelio — приложение для диктовки: оно распознаёт речь и пишет текст, а вслух ничего не читает.
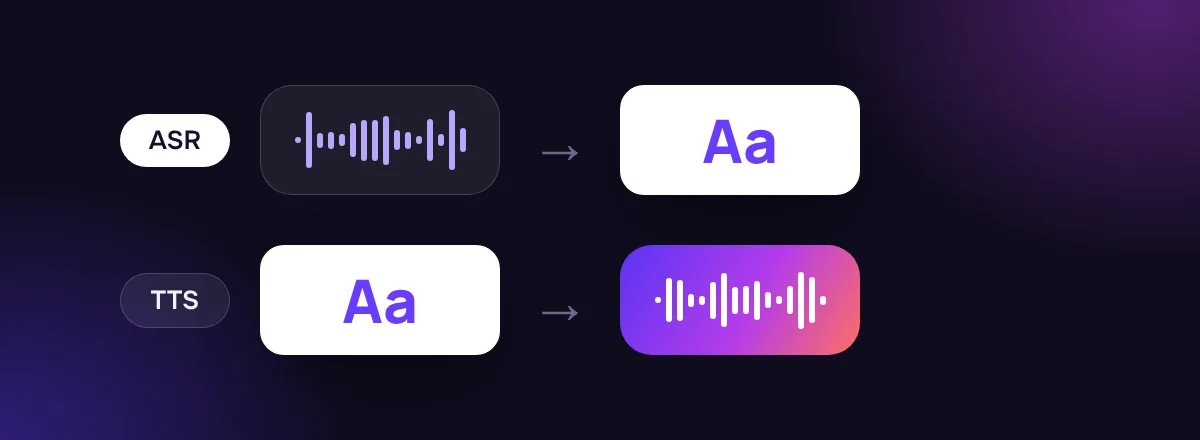
Как работает синтез речи
Типичная система синтеза работает по этапам:
- Анализ текста. Раскрыть сокращения и числа в слова («г.» — это «год» или «город»?) и выбрать правильное произношение для слов, которые пишутся одинаково, а звучат по-разному («зАмок» или «замОк»).
- Просодия. Решить, какими будут ритм, паузы, ударения и высота тона, чтобы вопрос звучал как вопрос.
- Акустическая модель. Предсказать, как речь должна звучать во времени, часто в виде спектрограммы.
- Вокодер. Превратить это предсказание в настоящую звуковую волну, которую можно проиграть.
Известный пример — Tacotron 2 от Google (2018): он предсказывает по тексту мел-спектрограмму и с помощью нейросетевого вокодера получает звук. Многие новые системы объединяют или переставляют эти этапы, но задача каждого остаётся.
Разработчики могут управлять синтезом через SSML (Speech Synthesis Markup Language) — стандарт W3C для разметки пауз, ударений, произношения и того, как читать даты и подобное. Поддержка отдельных возможностей SSML у разных движков разная.
Где они встречаются: числа, даты и имена
Оба направления спотыкаются об одно и то же, только с разных сторон:
- Диктовке нужно превратить сказанное «двенадцать пятьдесят» в запись: 12:50? 1250? 12,50 ₽? Это обратная нормализация текста, о ней — в статье от расшифровки к тексту.
- Синтезу нужно превратить записанное «12.05» в речь: двенадцатое мая или двенадцать целых пять сотых? Это нормализация текста.
Эти задачи связаны, но не зеркальны: правильный ответ в обе стороны зависит от контекста. С именами тоже трудно в обе стороны: распознавателю нужно знать, как пишется услышанное имя (для этого и есть словарь), а синтезатору — как произносится прочитанное.
Кодеки — третья, отдельная вещь
Речевой кодек, например Opus, записывает уже существующий звук меньшим числом бит, чтобы его можно было передать или сохранить. Он не создаёт речь из текста и не решает, какие слова кто-то сказал. Продукту, который распознаёт речь, не нужно ни синтезировать речь, ни использовать определённый кодек. Подробнее — в статье о сжатии звука для речи.
Оба используют машинное обучение, но по-разному
Современные ASR и TTS построены на нейросетях, и обе учатся на парах «звук + текст». Но цели у них противоположные: ASR оценивают по тому, верно ли угаданы слова, TTS — по тому, естественно ли и понятно ли звучит голос. Модель, отличная в одном, не умеет автоматически другое.
Частые вопросы
Может ли SayVelio прочитать мне мой текст?
Нет. SayVelio — для того, чтобы писать голосом. Чтобы текст читался вслух, используйте встроенную функцию системы: «Проговаривание» на Mac и iPhone, «Экранный диктор» в Windows, «Озвучивание при нажатии» на Android.
«Речь в текст» и «распознавание голоса» — одно и то же?
Обычно имеют в виду одно и то же, но строго говоря распознавание голоса может означать и распознавание того, кто говорит. SayVelio распознаёт, что вы говорите, а не кто вы.
Похожие материалы
 Как устроен голосовой ввод
Как распознавание речи превращает звук в слова
Почему речь трудна для компьютера, как работали классические распознаватели с акустической, произносительной и языковой моделями, что изменили сквозные модели (CTC, кодер-декодер, трансдьюсеры) и почему текст при потоковом распознавании меняется на ходу.
MacWindowsiPhoneAndroid Как устроен голосовой ввод
От сырой расшифровки к читаемому тексту: пунктуация, числа и обработка
Почему сырую расшифровку речи нельзя сразу отправлять, как добавляются знаки препинания, заглавные буквы, числа и списки, почему «пять пятьдесят» неоднозначно и как не дать обработке изменить смысл.
MacWindowsiPhoneAndroid Как устроен голосовой ввод
Форматы и сжатие звука в голосовом вводе
Цифровой звук, кодирование и сжатие — три разные вещи. Как работает сжатие без потерь и с потерями, почему ни один алгоритм не может уменьшить любой файл, как речевые кодеки вроде Opus балансируют между размером и задержкой и что это значит для диктовки.
MacWindowsiPhoneAndroid