
音声認識と音声合成の違い
音声認識は声を文字に、音声合成は文字を声に変えます。それぞれのしくみ、両者が重なる部分(数字、日付、名前)、音声コーデックがどちらとも違う点、そして音声入力アプリが文字を読み上げない理由を解説します。
要点
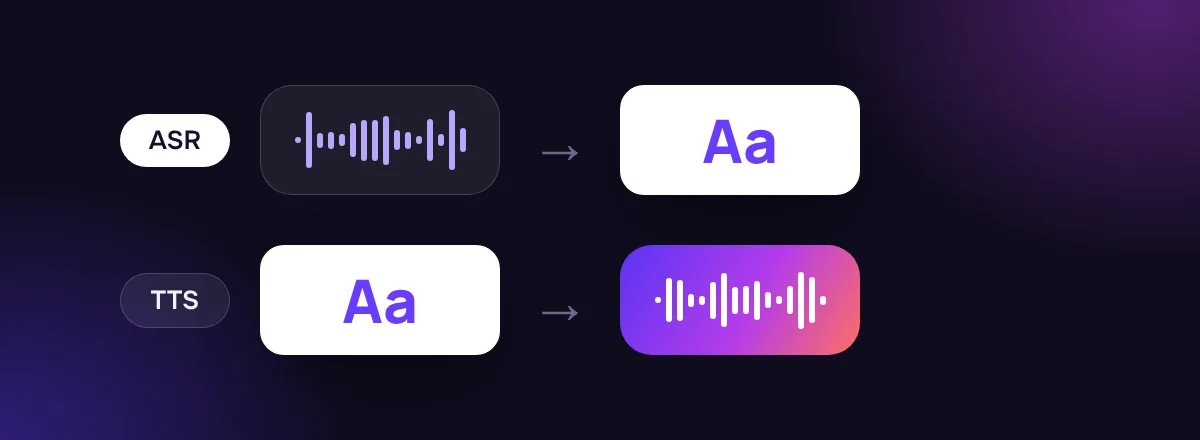
音声認識(ASR)は聞いて書きます。入力は音、出力は文字です。音声合成(TTS)は読んで話します。入力は文字、出力は音です。音声アシスタントでは一緒に使われることが多いものの、学習方法も出力も品質の測り方も違う、別々の技術です。3 つ目の技術である音声コーデックは、音を送るために小さくするだけで、どちらの働きもしません。
話した内容
打ち合わせは十二日の十五時三十分に変更です
SayVelio の入力結果
打ち合わせは 12 日の 15:30 に変更です。
正反対の 2 つの方向
| 音声認識(ASR) | 音声合成(TTS) | 音声コーデック | |
|---|---|---|---|
| 入力 | 話している人の音声 | 書かれた文字 | 音 |
| 出力 | 文字 | 合成された声 | 同じ音を軽くしたもの |
| 中心となる問い | どんな言葉が話されたか | この文章はどう聞こえるべきか | この音をどう効率よく送るか |
| よくある用途 | 音声入力、字幕、音声検索 | スクリーンリーダー、カーナビ、オーディオブック | 通話、ボイスメッセージ |
| 品質の測り方 | 単語誤り率 | 自然さと聞き取りやすさの評価 | 一定のビットレートでの聴取試験 |
音声アシスタントは両方を使います。質問を理解するために認識を、声で答えるために合成を使います。ただし、一方があればもう一方もあるわけではありません。SayVelio は音声入力アプリで、話し声を認識して文字を書き、何も読み上げません。
音声合成のしくみ
一般的な TTS システムは段階的に動きます。
- テキスト解析。 略語や数字を言葉に展開し(「1 日」は「ついたち」か「いちにち」か)、同じ表記で読み方が違う言葉の正しい読みを選びます(「今日」は「きょう」か「こんにち」か)。
- 韻律。 リズム、間、強調、抑揚を決め、質問が質問らしく聞こえるようにします。
- 音響モデル。 声が時間とともにどう聞こえるべきかを、多くはスペクトログラムの形で予測します。
- ボコーダー。 その予測を、実際に聞ける波形に変えます。
よく知られた例が Google の Tacotron 2(2018 年)で、文字からメルスペクトログラムを予測し、ニューラルボコーダーで音を生成します。新しいシステムの多くはこれらの段階をまとめたり組み替えたりしていますが、それぞれの役割は残っています。
開発者は SSML(Speech Synthesis Markup Language)で合成を制御できます。間、強調、発音、日付などの読み方を指定するための W3C の標準です。SSML の各機能への対応はエンジンによって異なります。
重なる部分:数字、日付、名前
どちらの方向も、同じところでつまずきます。それぞれの側からです。
- 音声入力 は、話された「じゅうにじごじゅっぷん」を書き言葉にしなければなりません。12:50 なのか、12 時 50 分なのか。これが逆テキスト正規化で、認識結果から読める文章へで説明しています。
- 音声合成 は、書かれた「12/05」を話し言葉にしなければなりません。12 月 5 日なのか、5 月 12 日なのか。これがテキスト正規化です。
2 つはつながっていますが、ぴったり鏡写しではありません。どちらの方向でも、正解は文脈しだいだからです。名前はどちらの方向でも難しく、認識システムは聞いた名前の書き方を知る必要があり(それが辞書の役目です)、合成システムは読んだ名前の発音を知る必要があります。
コーデックは別の、3 つ目のもの
Opus のような音声コーデックは、すでにある音を、送ったり保存したりするために少ないビットで表します。文字から話し声を作ることも、どんな言葉が話されたかを決めることもしません。話し声を文字にする製品が、声を合成したり特定のコーデックを使ったりする必要はありません。詳しくは音声の圧縮をご覧ください。
どちらも機械学習を使うが、使い方は違う
今の ASR と TTS はどちらもニューラルネットワークに基づき、音と文字の組から学習します。ただし目的は正反対です。ASR は言葉の正しさで、TTS は聞く人にとっての声の自然さと明瞭さで評価されます。一方で優れたモデルが、自動的にもう一方もこなせるわけではありません。
よくある質問
SayVelio に文章を読み上げてもらえますか?
いいえ。SayVelio は声で書くためのものです。文章を読み上げてほしいときは、システムに組み込まれた機能を使ってください。Mac と iPhone では「読み上げコンテンツ」、Windows では「ナレーター」、Android では「選択して読み上げ」です。
「音声をテキストに」と「声の認識」は同じですか?
同じ意味で使われることが多いですが、厳密には、声の認識は 誰が 話しているかを特定することも指します。SayVelio が認識するのは、あなたが何を言ったかであって、あなたが誰かではありません。
関連記事
 音声入力のしくみ
音声認識が音を言葉に変えるしくみ
話し言葉がコンピューターにとって難しい理由、音響モデル・発音辞書・言語モデルを組み合わせた従来の認識器のしくみ、エンドツーエンドのモデル(CTC、エンコーダー・デコーダー、トランスデューサー)がもたらした変化、そして話している途中で文字が変わる理由を解説します。
MacWindowsiPhoneAndroid 音声入力のしくみ
認識結果から読める文章へ:句読点、数字、整形
音声認識の生の結果がそのまま送れない理由、句読点・数字・リストが加わるしくみ、「ごじはん」があいまいな理由、そして整形で意味が変わらないようにする方法を解説します。
MacWindowsiPhoneAndroid 音声入力のしくみ
音声入力における音声形式と圧縮
デジタル音声、符号化、圧縮は別のものです。可逆圧縮と非可逆圧縮のしくみ、どんなアルゴリズムでもすべてのファイルは小さくできない理由、Opus のような音声コーデックがサイズと遅延をどう両立させるか、そして音声入力にとっての意味を解説します。
MacWindowsiPhoneAndroid